
ClickHouse ReplicatedMergeTree:多副本架构与数据一致性保障
一、副本的"一致性问题":分布式写入的最终一致性挑战
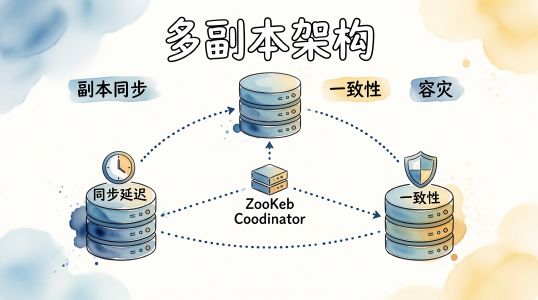
ClickHouse 的 ReplicatedMergeTree 引擎通过 ZooKeeper 协调多副本数据同步,实现高可用和容灾。但"副本间数据一致"并非即时保证——写入主副本后,从副本的同步存在延迟(通常毫秒到秒级)。在这段延迟窗口内,查询可能命中不同副本返回不同结果。更严重的是,当 ZooKeeper 会话超时或网络分区时,副本可能进入"只读模式"拒绝写入,或者多个副本同时认为自己是 Leader 导致数据分叉。理解 ReplicatedMergeTree 的一致性模型和故障恢复机制,是保障生产环境数据可靠性的前提。
二、ReplicatedMergeTree 的复制机制
2.1 从写入到副本同步的完整流程
sequenceDiagram
    participant Client as 客户端
    participant Leader as Leader 副本
    participant ZK as ZooKeeper
    participant Follower as Follower 副本

    Client->>Leader: INSERT 数据
    Leader->>Leader: 写入本地 Part
    Leader->>ZK: 注册 Part 元数据<br/>/table/replicas/leader/parts/
    ZK-->>Leader: 注册成功
    Leader-->>Client: 写入确认

    par 异步同步
        Follower->>ZK: Watch Part 变更
        ZK-->>Follower: 通知新 Part
        Follower->>Leader: 下载 Part 数据
        Leader-->>Follower: 传输 Part
        Follower->>ZK: 更新本地 Part 列表
    end
2.2 副本协调的关键 ZooKeeper 节点
# ZooKeeper 中的关键路径结构
ZK_PATHS = {
    # 副本元数据
    'replicas': '/clickhouse/tables/{database}/{table}/replicas',
    # 单个副本的状态
    'replica_state': '/clickhouse/tables/{database}/{table}/replicas/{replica}/is_active',
    # Part 列表
    'parts': '/clickhouse/tables/{database}/{table}/replicas/{replica}/parts',
    # Leader 选举
    'leader': '/clickhouse/tables/{database}/{table}/leader_election',
    # 块去重
    'blocks': '/clickhouse/tables/{database}/{table}/blocks',
    # 日志队列
    'log': '/clickhouse/tables/{database}/{table}/log',
    # 异步任务
    'queue': '/clickhouse/tables/{database}/{table}/replicas/{replica}/queue',
}
三、生产级副本配置与一致性保障
3.1 副本表创建与配置
-- 在每个副本节点上创建 ReplicatedMergeTree 表
CREATE TABLE events ON CLUSTER '{cluster}' (
    event_id UUID,
    event_time DateTime,
    event_type String,
    user_id UInt64,
    payload String
)
ENGINE = ReplicatedMergeTree(
    '/clickhouse/tables/{database}/{table}',
    '{replica}'
)
PARTITION BY toYYYYMM(event_time)
ORDER BY (event_type, event_time, user_id)
SETTINGS
    -- 副本同步配置
    min_replicated_logs_to_keep = 100,
    max_replicated_logs_to_keep = 1000,
    -- 压实协调
    replicated_can_become_leader = true,
    -- 写入一致性
    insert_quorum = 2,           -- 至少2个副本确认写入
    insert_quorum_timeout = 600, -- quorum 超时 10 分钟
    -- 读取一致性
    select_sequential_consistency = 0,  -- 0=最终一致, 1=顺序一致
    -- 去重
    replicated_deduplication_window = 1000;
3.2 写入一致性配置
class ClickHouseWriteConsistency:
    """ClickHouse 写入一致性配置管理"""

    @staticmethod
    def get_insert_settings(consistency_level: str = 'quorum') -> dict:
        """根据一致性级别返回写入配置"""
        configs = {
            # 最终一致:写入主副本即返回
            'eventual': {
                'insert_quorum': 0,
                'insert_quorum_timeout': 0,
            },
            # Quorum 一致:等待多数副本确认
            'quorum': {
                'insert_quorum': 2,        # 3 副本中至少 2 个确认
                'insert_quorum_timeout': 600,
            },
            # 全部一致:等待所有副本确认
            'all': {
                'insert_quorum': 'auto',   # 等于副本总数
                'insert_quorum_timeout': 1200,
            },
        }
        return configs.get(consistency_level, configs['quorum'])

    @staticmethod
    def get_read_settings(consistency_level: str = 'eventual') -> dict:
        """根据一致性级别返回读取配置"""
        configs = {
            # 最终一致:从任意副本读取
            'eventual': {
                'select_sequential_consistency': 0,
                'max_replica_delay_for_distributed_queries': 300,
            },
            # 顺序一致:只从已同步的副本读取
            'sequential': {
                'select_sequential_consistency': 1,
                'max_replica_delay_for_distributed_queries': 0,
            },
        }
        return configs.get(consistency_level, configs['eventual'])
3.3 副本健康监控
-- 检查副本状态
SELECT
    database,
    table,
    name AS replica_name,
    is_active,
    absolute_delay AS replication_delay_seconds,
    queue_size AS pending_tasks,
    log_max_index - log_pointer AS log_lag,
    parts_count,
    last_queue_update
FROM system.replicas
WHERE is_active = 0 OR absolute_delay > 60
ORDER BY absolute_delay DESC;

-- 检查 Part 不一致
SELECT
    database,
    table,
    countIf(is_active) AS active_parts,
    countIf(NOT is_active) AS inactive_parts
FROM system.parts
WHERE active AND database NOT IN ('system')
GROUP BY database, table
HAVING inactive_parts > 0;

-- 检查 ZooKeeper 连接状态
SELECT * FROM system.zookeeper WHERE path = '/clickhouse';
3.4 副本故障恢复
class ReplicaRecovery:
    """副本故障恢复操作"""

    @staticmethod
    def recover_stale_replica(ch_client, database: str, table: str, replica: str):
        """恢复过期的副本"""
        # 1. 检查副本状态
        status = ch_client.query(f"""
            SELECT is_active, absolute_delay, queue_size
            FROM system.replicas
            WHERE database = '{database}' AND table = '{table}'
        """)

        if not status['is_active']:
            # 2. 重启副本的复制线程
            ch_client.query(f"""
                SYSTEM RESTART REPLICA {database}.{table}
            """)

        # 3. 如果延迟过大,触发强制同步
        if status['absolute_delay'] > 3600:
            ch_client.query(f"""
                SYSTEM SYNC REPLICA {database}.{table}
            """)

    @staticmethod
    def recover_from_zookeeper_session_loss(ch_client, database: str, table: str):
        """ZooKeeper 会话丢失后的恢复"""
        # 1. 重新连接 ZooKeeper
        ch_client.query("SYSTEM RESTART REPLICA")

        # 2. 检查是否进入只读模式
        is_readonly = ch_client.query(f"""
            SELECT is_readonly FROM system.replicas
            WHERE database = '{database}' AND table = '{table}'
        """)

        if is_readonly:
            # 3. 退出只读模式
            ch_client.query(f"""
                SET allow_experimental_drop_detached = 1;
                SYSTEM DROP REPLICA '{replica}' FROM {database}.{table};
            """)

            # 4. 重新初始化副本
            ch_client.query(f"""
                ALTER TABLE {database}.{table} UPDATE SETTINGS
                replicated_can_become_leader = 1
            """)
四、边界分析与架构权衡
4.1 ZooKeeper 的可用性瓶颈
ZooKeeper 是 ReplicatedMergeTree 的核心依赖,所有元数据操作都经过 ZooKeeper。当 ZooKeeper 集群故障或延迟升高时,写入操作会阻塞(无法注册 Part 元数据)。建议:部署 3-5 节点的 ZooKeeper 集群,使用独立物理机避免资源争抢,监控 ZK 延迟(system.zookeeper 中的 zk_request_duration_ms)。
4.2 insert_quorum 的性能代价
insert_quorum=2 意味着每次写入需要等待至少 2 个副本确认,写入延迟从单副本的 50ms 增加到 100-200ms。在高吞吐场景中(10 万行/秒),quorum 确认可能成为瓶颈。建议:对实时性要求高的数据使用 quorum,对批量导入数据使用 eventual。
4.3 副本间的 Part 合并冲突
各副本独立执行 Part 合并(Merge),可能导致合并顺序不同。当两个副本合并出不同的 Part 时,需要通过 ZooKeeper 协调解决冲突——丢弃被覆盖的 Part,重新下载。在频繁写入的表中,合并冲突可能导致 Part 下载量激增,占用大量网络带宽。
4.4 跨数据中心复制的延迟
跨数据中心的副本同步受网络延迟影响(同城 <1ms,跨城 10-30ms,跨国 100-200ms)。跨城部署时,insert_quorum=2 的写入延迟取决于最慢副本的响应时间。建议:跨城部署使用异步复制(不设 quorum),通过监控延迟窗口控制读取路由。
五、总结
ClickHouse ReplicatedMergeTree 通过 ZooKeeper 协调多副本数据同步,提供从最终一致到顺序一致的可配置一致性级别。insert_quorum 控制写入确认的副本数,select_sequential_consistency 控制读取的一致性保证。副本故障恢复依赖 SYSTEM RESTART REPLICA 和 SYSTEM SYNC REPLICA 命令。工程实践中需注意 ZooKeeper 的可用性瓶颈、quorum 确认的性能代价、Part 合并冲突,以及跨数据中心复制的延迟影响。建议根据业务场景选择一致性级别——实时数据用 quorum,批量数据用 eventual,在一致性和性能之间取得平衡。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/guoyizhongxing/article/details/161825538