
一、存储程序概述
1.1 什么是存储程序
存储程序(Stored Program)本质上是将一段 SQL 语句集保存为一个可执行的程序,存储在数据库服务器端,可以被反复调用。
MySQL 的存储程序包括三种:
- 存储过程(Stored Procedure):通过
CALL调用,无返回值,可通过 OUT/INOUT 参数传出数据; - 存储函数(Stored Function):像内置函数一样在 SELECT 中调用,必须有返回值;
- 触发器(Trigger):与表关联,在表发生 INSERT/UPDATE/DELETE 时自动触发执行。
前两种是数据库级对象,后一种是表级对象
1.2 两种数据库访问方式
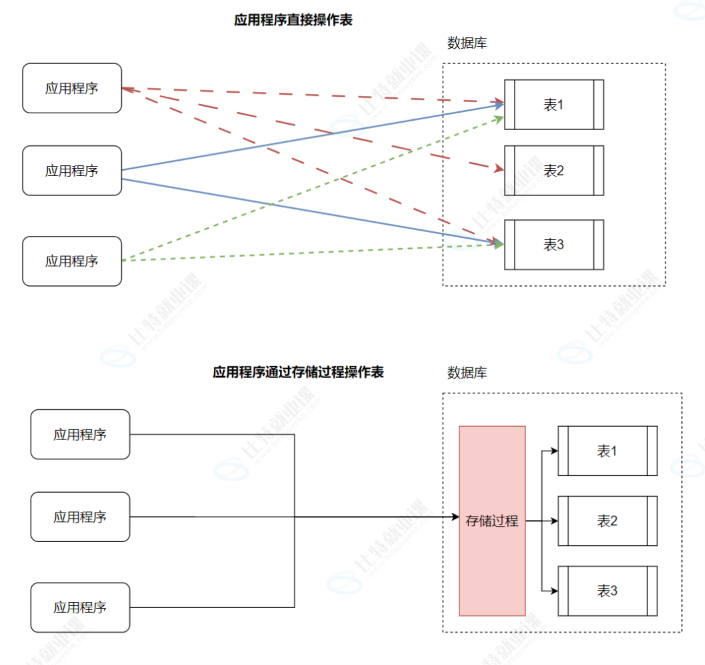
应用程序与数据库之间存在两种交互模式:
| 模式 | 说明 | 特点 |
|---|---|---|
| 方式一 | 应用程序直接发送单条 SQL 给数据库执行 | 现代主流方式,业务逻辑在应用层 |
| 方式二 | 应用程序调用数据库中预存的 SQL 语句集 | 业务逻辑封装在数据库端 |
现代开发往往使用方式一,最重要的原因是:方式二在高并发场景下会把业务逻辑的计算压力压在数据库服务器上,数据库难以横向扩展,成为性能瓶颈。
但存储程序并非一无是处,在非高并发场景下仍有其价值。
1.3 存储程序的优点
- 性能优化:存储程序创建时编译并存储在数据库中,执行时无需重复解析,速度比逐条发送 SQL 快;
- 代码重用:存储程序可重复调用,减少重复代码,提高可维护性;
- 安全性:可以限制用户直接访问表,只通过存储程序间接访问,从而保证数据安全;
- 事务管理:可以在存储程序中实现复杂的事务逻辑;
- 降低耦合:当表结构变化时,只需修改存储程序,应用程序改动较小。
1.4 存储程序的缺点
- 可移植性差:存储程序不能跨数据库移植,更换数据库(如 MySQL → PostgreSQL)时需要重写;
- 调试困难:只有少数数据库管理工具支持存储程序的调试,开发和维护成本高;
- 不适合高并发:高并发场景下存储程序会增加数据库压力,且难以水平扩展;
- 版本管理困难:存储程序的代码存在数据库中,不便于用 Git 等工具做版本控制。
二、存储过程
2.1 创建存储过程
CREATE PROCEDURE procedure_name([参数列表])
BEGIN
    statement_list
END;
2.2 DELIMITER 的作用
存储过程内部包含多条 SQL 语句,每条以分号 ; 结尾。但 MySQL 客户端默认把 ; 当作语句结束符,会在遇到第一个 ; 时就尝试执行,导致存储过程定义被截断。
DELIMITER 用于临时修改语句结束符:
DELIMITER //          -- 将结束符改为 //
CREATE PROCEDURE p5()
BEGIN
    SELECT * FROM test;   -- 内部的 ; 不会被当作结束符
END //
DELIMITER ;           -- 改回默认的 ;
用可视化工具(如 Navicat、DataGrip)创建存储过程时,工具会自动处理结束符,可能不需要手动写 DELIMITER;但在命令行中必须使用。
2.3 调用存储过程
CALL procedure_name([参数]);
2.4 查看存储过程
-- 查看存储过程的创建语句
SHOW CREATE PROCEDURE procedure_name;

-- 查看存储过程状态
SHOW PROCEDURE STATUS WHERE Db = '数据库名';

-- 从 information_schema 查询
SELECT * FROM information_schema.ROUTINES
WHERE ROUTINE_SCHEMA = '数据库名' AND ROUTINE_TYPE = 'PROCEDURE';
2.5 删除存储过程
DROP PROCEDURE [IF EXISTS] procedure_name;
2.6 参数类型(IN / OUT / INOUT)
| 参数类型 | 含义 | 特点 |
|---|---|---|
IN | 输入型参数 | 传入值,过程内只读,不能被赋值;默认类型 |
OUT | 输出型参数 | 过程内赋值,可将结果带出到外部;初始值为 NULL |
INOUT | 输入输出型参数 | 既可传入初始值,也可在过程内修改并带出 |
⚠️ 重要:
IN参数在存储过程中是只读的,不能被赋值(如SELECT ... INTO in_param或SET in_param = ...都会报错)。如果需要接收查询结果,应使用局部变量或 OUT/INOUT 参数。
示例
DELIMITER //
DROP PROCEDURE IF EXISTS p5 //
CREATE PROCEDURE p5(
    IN  _id   INT,          -- 输入:要查询的 id
    OUT _name VARCHAR(20),  -- 输出:查询到的姓名
    INOUT _str VARCHAR(40)  -- 输入输出:拼接结果
)
BEGIN
    DECLARE tmp_id INT;     -- 用局部变量接收,不能给 IN 参数赋值
    SELECT id, ename INTO tmp_id, _name
    FROM test WHERE id = _id;   -- 用传入的 _id 作为查询条件
    SET _str := CONCAT(tmp_id, ' ', _name);
END //
DELIMITER ;

-- 调用
SET @_str := '初始值';
CALL p5(1, @_name, @_str);
SELECT @_name, @_str;
三、存储函数
3.1 创建存储函数
CREATE FUNCTION function_name(参数列表)
RETURNS return_type [CHARACTERISTIC ...]
BEGIN
    statement_list
    RETURN expression;   -- 必须有返回值
END;
存储函数与存储过程的关键区别:
- 存储函数必须有返回值(
RETURN),且只能由一个 - 存储函数的参数只能是 IN 类型(不能指定 OUT/INOUT,默认就是 IN);
- 存储函数像内置函数一样在 SELECT 中调用,不需要
CALL。
3.2 函数特征(CHARACTERISTIC)
| 特征 | 含义 |
|---|---|
DETERMINISTIC | 相同的输入总是产生相同的结果(确定性函数) |
NOT DETERMINISTIC | 相同的输入可能产生不同的结果(如含 NOW ()、RAND ()) |
NO SQL | 不包含任何 SQL 语句 |
CONTAINS SQL | 包含 SQL 语句但不读写数据(默认值) |
READS SQL DATA | 包含读取数据的语句(如 SELECT) |
MODIFIES SQL DATA | 包含写入数据的语句(如 INSERT/UPDATE/DELETE) |
SQL SECURITY DEFINER | 以定义者的权限执行(默认) |
SQL SECURITY INVOKER | 以调用者的权限执行 |
如果函数包含 SELECT 但未声明
READS SQL DATA,某些 SQL 模式下可能报警告或报错,建议显式声明。
3.3 调用存储函数
SELECT function_name(参数);
存储函数可以像内置函数(如 CONCAT()、UPPER())一样在任何表达式中使用。
示例
DELIMITER //
DROP FUNCTION IF EXISTS get_emp_name //
CREATE FUNCTION get_emp_name(_id INT)
RETURNS VARCHAR(20)
READS SQL DATA
BEGIN
    DECLARE v_name VARCHAR(20);
    SELECT ename INTO v_name FROM test WHERE id = _id;
    RETURN v_name;
END //
DELIMITER ;

-- 调用
SELECT get_emp_name(1);
SELECT id, get_emp_name(id) AS name FROM test;
3.4查看存储函数
方式 1:快速查看当前库所有存储函数
使用 SHOW FUNCTION STATUS 命令,可快速列出函数的基础信息:
-- 查看当前数据库下的所有存储函数
SHOW FUNCTION STATUS WHERE Db = DATABASE();
返回信息包含:函数名、数据库、创建者、创建时间、字符集、是否确定性等基础属性。
对应查看存储过程的命令是
SHOW PROCEDURE STATUS,二者语法一致。
方式 2:精准查询元数据
通过系统表 information_schema.ROUTINES 自定义筛选字段,可获取最详细的函数信息:
SELECT
  ROUTINE_NAME AS '函数名',
  DATA_TYPE AS '返回值类型',
  IS_DETERMINISTIC AS '是否确定性',
  SQL_DATA_ACCESS AS 'SQL特性',
  CREATED AS '创建时间',
  CHARACTER_SET_NAME AS '字符集'
FROM information_schema.ROUTINES
WHERE
  ROUTINE_SCHEMA = DATABASE()  -- 当前数据库,可替换为具体库名如 'mytest'
  AND ROUTINE_TYPE = 'FUNCTION'; -- 只筛选函数,排除存储过程
- 该表同时存储存储过程和函数,通过
ROUTINE_TYPE字段区分:FUNCTION是函数,PROCEDURE是存储过程。 - 支持自定义筛选字段和查询条件,适合批量排查、统计场景。
方式 3:查看单个函数的完整创建代码
如果想查看某个函数的完整定义语句,使用 SHOW CREATE FUNCTION:
-- 语法:SHOW CREATE FUNCTION 函数名
SHOW CREATE FUNCTION function_name;
执行后会返回完整的 CREATE FUNCTION 代码,以及函数的字符集、排序规则等配置信息,是排查函数逻辑最直接的方式。
3.5删除存储函数
DROP FUNCTION [IF EXISTS] function_name;
3.6 存储过程 vs 存储函数
| 对比项 | 存储过程 | 存储函数 |
|---|---|---|
| 返回值 | 无(通过 OUT/INOUT 传出) | 必须有 RETURN 返回值 |
| 参数类型 | IN / OUT / INOUT | 只能是 IN |
| 调用方式 | CALL 过程名() | SELECT 函数名()(像内置函数) |
| 可否在 SELECT 中使用 | 不能 | 可以 |
| 可否包含事务控制 | 可以(COMMIT/ROLLBACK) | 一般不可以 |
| 典型用途 | 复杂业务逻辑、批量处理 | 计算、转换、查询单个值 |
四、触发器
4.1 什么是触发器
触发器(Trigger)是一个与表关联的数据库对象,在对表进行 INSERT / UPDATE / DELETE 操作时自动触发并执行预定义的 SQL 语句。
可以理解为:"一件事发生,自动触发另一件事"—— 类似事件驱动的思想。
典型用途:
- 数据审计(记录谁在什么时候修改了什么);
- 数据校验(插入 / 更新前检查数据合法性);
- 数据同步(一张表变化时自动更新另一张表);
- 自动计算(插入时自动生成某些字段的值)。
4.2 触发时间与触发事件
触发器由两个维度定义:
| 维度 | 选项 | 说明 |
|---|---|---|
| 触发时间 | BEFORE | 在表操作之前执行 |
AFTER | 在表操作之后执行 | |
| 触发事件 | INSERT | 插入时触发 |
UPDATE | 更新时触发 | |
DELETE | 删除时触发 |
一张表最多可以有 6 个触发器(3 种事件 × 2 个时间点)。
4.3 OLD 与 NEW
在触发器中,用 OLD 和 NEW 关键字引用受影响行的旧值和新值:
| 触发器类型 | OLD | NEW |
|---|---|---|
| INSERT 触发器 | 不可用(无旧数据) | 表示将要或已经插入的新数据 |
| UPDATE 触发器 | 表示修改之前的旧数据 | 表示将要或已经修改的新数据 |
| DELETE 触发器 | 表示将要或已经删除的数据 | 不可用(无新数据) |
重要规则
OLD是只读的,不能修改;NEW在 BEFORE 触发器中可以修改(可以在写入前改变新值);NEW在 AFTER 触发器中不能修改(操作已完成,改了也没用)。
4.4 创建触发器
CREATE TRIGGER trigger_name
{BEFORE | AFTER} {INSERT | UPDATE | DELETE}
ON table_name
FOR EACH ROW
BEGIN
    statement_list
END;
FOR EACH ROW表示这是行级触发器(MySQL 只支持行级触发器)。
示例 1:AFTER INSERT 记录操作日志
DELIMITER //
DROP TRIGGER IF EXISTS trg_test_after_insert //
CREATE TRIGGER trg_test_after_insert
AFTER INSERT ON test
FOR EACH ROW
BEGIN
    INSERT INTO test_log(emp_id, action, create_time)
    VALUES(NEW.id, 'INSERT', NOW());
END //
DELIMITER ;
示例 2:BEFORE INSERT 数据校验与修正
DELIMITER //
DROP TRIGGER IF EXISTS trg_test_before_insert //
CREATE TRIGGER trg_test_before_insert
BEFORE INSERT ON test
FOR EACH ROW
BEGIN
    -- 年龄不能为负数,负数自动修正为 0
    IF NEW.age < 0 THEN
        SET NEW.age := 0;
    END IF;
    -- 姓名自动转为大写
    SET NEW.ename := UPPER(NEW.ename);
END //
DELIMITER ;
注意:这是 BEFORE 触发器,所以可以修改
NEW.age和NEW.ename,修改后的值才是真正写入表的值。
4.5 查看与删除触发器
-- 查看所有触发器
SHOW TRIGGERS;

-- 查看指定表的触发器
SHOW TRIGGERS WHERE `Table` = '表名';

-- 查看触发器创建语句
SHOW CREATE TRIGGER trigger_name;

-- 删除触发器
DROP TRIGGER [IF EXISTS] trigger_name;
4.6 行级触发器 vs 语句级触发器
| 对比项 | 行级触发器 | 语句级触发器 |
|---|---|---|
| 触发次数 | 每影响一行就触发一次 | 整条 SQL 语句只触发一次 |
| 示例 | UPDATE 影响 100 行 → 触发 100 次 | UPDATE 影响 100 行 → 只触发 1 次 |
| 可否访问 OLD/NEW | 可以 | 不可以 |
| 典型用途 | 逐行业务逻辑、数据校验 | 全局性操作(如数据同步、清理) |
MySQL 只支持行级触发器,不支持语句级触发器。 所以 MySQL 触发器必须写
FOR EACH ROW。
4.7 触发器的限制与注意事项
- 只能基于表创建,不能基于视图;
- 不支持 CALL 存储过程(MySQL 触发器中不能调用存储过程 / 函数,但可以使用内置函数);
- 不支持事务控制语句(如 COMMIT / ROLLBACK / SAVEPOINT),触发器在当前事务中执行,随当前事务一起提交或回滚;
- BEFORE 触发器中不能修改 OLD,AFTER 触发器中不能修改 NEW;
- 触发器执行失败会导致触发它的 SQL 语句也失败回滚;
- 触发器会增加写入操作的开销,不适合在高并发写入的表上使用复杂触发器。
转载自 CSDN-专业IT技术社区