
本文分享了一位12年经验的后端工程师如何成功转型AI应用开发,并顺利进入腾讯等顶尖公司的经验。文章指出,转型关键在于将工程经验与AI应用链路结合,通过三个阶段的学习:AI应用开发基础认知、腾讯专项打磨、项目实战与作品集,将业务经验转化为AI工程方案。文章强调,懂工程系统与AI应用链路的人才极度稀缺,建议有编程基础的人抓住机遇,提前准备。同时,文章还提供了一套学习路线图和面试准备材料,帮助读者更好地进行转型。
他来找我的时候,还在一家做企业SaaS的公司写后端。
本科软件工程,工作十二年,35岁。
前五年在传统行业做信息化——Java、Spring、Oracle,写审批流、报表、接口对接;后七年跳到一家互联网中厂做业务后端,扛过双十一级别的流量,做过订单中台,分库分表、缓存击穿、幂等补偿这些词,闭着眼都能写。
做过最"高级"的事,是把一张八千万行的表重新拆了索引,让一张跑了40秒的报表降到2秒。
没碰过大模型,连Prompt是什么,都是刷小红书才知道的。
他说想转AI应用开发、进腾讯的时候,我没有急着给他列方案,而是先问了他一个问题:
“这十二年里,有没有哪个瞬间让你觉得:这件事AI明明能做,但最后还是靠人堆人力硬扛?”
他想了一会,说有。
他做过一个企业内部的知识库+工单系统。销售、交付、客服每天在上面问问题:这个客户配的版本支持不支持这个接口、上个月那次变更的口径到底是什么。
理论上,这件事AI早就该接了——文档喂进去,检索出来,生成一段回答,听起来是最简单的那种大模型应用。
但真正落地的时候,难点根本不在模型本身。
关键问题是:文档半年没人维护,检索出来的还是旧版本怎么办?同一个问题有三种问法,召不回正确的那一段怎么办?销售和财务能看的文档版本不一样,权限该在哪一层过滤?模型编了一个不存在的字段名,客户照着接了,谁负责?它答对三句、编了一句,用户凭什么信?
老工程师靠的是几年踩坑踩出来的"这条链路哪里会崩",而AI应用要做的,是把这些藏在业务细节里的判断,通过检索策略、工具边界和评测机制,变成可复现、可验证的工程约束。
这句话,比会不会调模型重要一百倍。
他的目标公司非常明确:腾讯、字节、阿里、美团、蚂蚁、华为云——凡是做Agent平台、RAG知识库、Copilot类产品的团队,全部锁定。
这个方向不挑语言栈——后端、前端、测试、运维、数据,只要真写过代码,都能往上叠。腾讯要的不是算法研究员,是能把模型塞进真实系统里的人。
这就是为什么腾讯愿意开4W+,招一个35岁、没做过模型训练的后端。
他后面做的事情,跟网上那些"转行AI必学"的教程完全不一样。
没有从头推Transformer的数学,没有刷LeetCode,没有去训一个自己的模型。
📌 我把他的转型拆成了三个阶段,每个阶段只围绕一个目标。
✅ 阶段1:AI应用开发基础认知(20天)
先啃大模型的应用层边界:生成和理解的边界在哪,RAG、Prompt工程、Agent、Tool Calling分别解决什么落地问题;Embedding、向量检索、重排、长上下文、多模态,怎么用在知识问答、工单处理、代码补全、会议纪要上。
然后回到他最熟的后端场景里做判断:意图路由、工具调用、流程编排、状态管理、可观测性——哪些交给模型,哪些必须留在确定性代码里(金额计算、权限校验、幂等和重试)。
再梳理一套核心指标:首token延迟、端到端P95、召回率、答案采纳率、工具调用成功率、幻觉率、单次会话Token成本。AI应用比传统后端多两条命:评测集和兜底策略。
这一步不搞清楚,后面全是空中楼阁。
✅ 阶段2:腾讯专项打磨(15天)
目标锁定腾讯,必须吃透产品矩阵。
拆产品矩阵:腾讯云的大模型知识引擎(文档解析、切片、检索、工作流编排)、混元模型的能力边界、腾讯会议AI小助手、腾讯文档和企业微信里的AI能力、CodeBuddy这类研发提效工具,一层层搞懂模型用在哪一环、上下文从哪来、边界在哪。
研究数据与调用链路:企业文档怎么进库、怎么切片、怎么向量化、怎么召回重排、怎么带权限过滤,再由Agent调用业务系统(CRM/工单/IM)的工具,最后回到"效果怎么评、成本怎么控、答错了怎么兜"。
追踪技术方向:Agent编排与多轮工具调用、记忆与长上下文、模型路由与降本、线上评测与可观测性。
这15天的产出只有一个目标:面试官提到腾讯任何一个AI产品,他都能接住——这个产品里的模型用在哪,上下文从哪来,解决了用户、业务和成本方的什么问题。
✅ 阶段3:项目实战与作品集(1.5个月)
他完成了三份围绕腾讯真实业务场景的AI应用方案:
企业知识库RAG问答方案——从文档解析、切片策略、混合检索、重排到权限过滤,再到答案引用溯源、兜底话术、评测集建设,完整走一遍;
Agent工具调用方案(IT运维/客服工单场景)——围绕意图识别、工具编排、多轮状态、失败重试和人工接管,做一个真能跑起来的Agent,加上权限边界和审计日志;
研发提效Copilot方案——围绕代码补全、单测生成、代码评审,设计仓库级检索、上下文注入、采纳率度量,加上企业代码安全与合规边界。
三份方案最后拧成一个原则:每一个AI输出,都必须能被用户追溯、被工程师验证。
AI可以说"这个问题的答案是……",但系统必须说明:基于哪几段文档、召回了什么、置信度多少、调用过哪些工具、失败时怎么兜底、日志能不能回放。
因为线上最怕的不是AI答错,而是AI给一个没有依据、用户不敢用、工程师排查不了的答案。
面试官的评价是:这是他面过的人里,把大模型在业务系统里怎么落地讲得最清楚的一个。
他现在在腾讯做的事情,本质上是翻译——把"业务说不清、但老工程师靠十二年手感避开过的坑",翻译成"模型能执行、链路可观测、用户敢用的AI工程方案"。
举个例子。
RAG里最难的不是"答不对",是"答得让你不敢相信"。
技术原理不复杂:文档切一切,向量搜一搜,塞给模型生成。
难的是:文档半年没人更新、同一个问题三种问法、销售和财务看到的是不同版本、模型编了一个不存在的字段名、答案里有依据的部分和编的部分混在一起——怎么让用户一眼看出哪句能信?
这才是AI应用开发真正在做的——把业务经验变成工程约束。
做这个事,只会调API的搞不定,因为他不知道"权限过滤晚一步"在一次政企交付里意味着什么;只会写业务逻辑的也搞不定,因为他习惯把一切写死在if-else里,没有把不确定性显性化、可评测化的训练。
刚好站在中间的人,才是腾讯在抢的人。
我带过的学员里,有编程基础的人转AI应用开发,是转化率最高的——后端、前端、测试、运维都一样。
不是因为这个方向容易——是因为这个方向极度缺人,而几乎没有人意识到自己已经具备了一半的核心能力。
你写过的每一次分库分表、调过的每一次首屏性能,比任何算法工程师都清楚"数据不一致、体验崩了"在一次真实交付里意味着什么;你在测试环境里复现过的每一个偶现Bug,比只跑过demo的人更懂什么叫"不稳定就不敢上线";你被线上事故、返工和排查折磨过的每一个深夜,都藏着AI应用可观测性与兜底策略的需求来源。
这些东西不需要你重学,它们就在你的工程经验里。
缺的只有两样:把工程经验翻译成AI产品方案的训练,和知道这些公司面试官到底在考什么的机会。
AI应用开发正在进入爆发期。
腾讯在把混元往会议、文档、企业微信里塞,字节在推豆包和火山方舟,阿里在推通义和百炼,华为在推盘古行业大模型;国际上微软Copilot、OpenAI、Anthropic、Google也在持续加码Agent。
从"写业务代码"往"编排智能体"转,同时懂工程系统和AI应用链路的人,少到每家需求缺口都以"百"为单位。
今年秋招的同学也一样——腾讯、字节的校招JD里,Agent、RAG、Copilot这些词出现的频率比去年高了一个量级。别只盯着传统的后端、前端HC,这条线同样在招人,而且越早准备越占便宜。
我现在空余时间一直在带后端/前端/测试/运维/数据背景的朋友转型AI应用开发,复刻的就是这套打法——你的工程经验才是真正的护城河,模型只是工具。
关键是你得知道怎么把经验"翻译"成面试官听得懂、线上敢上、老板敢买单的AI应用方案。
假如你从2026年开始学大模型,按这个步骤走准能稳步进阶。
接下来告诉你一条最快的邪修路线,
3个月即可成为模型大师,薪资直接起飞。
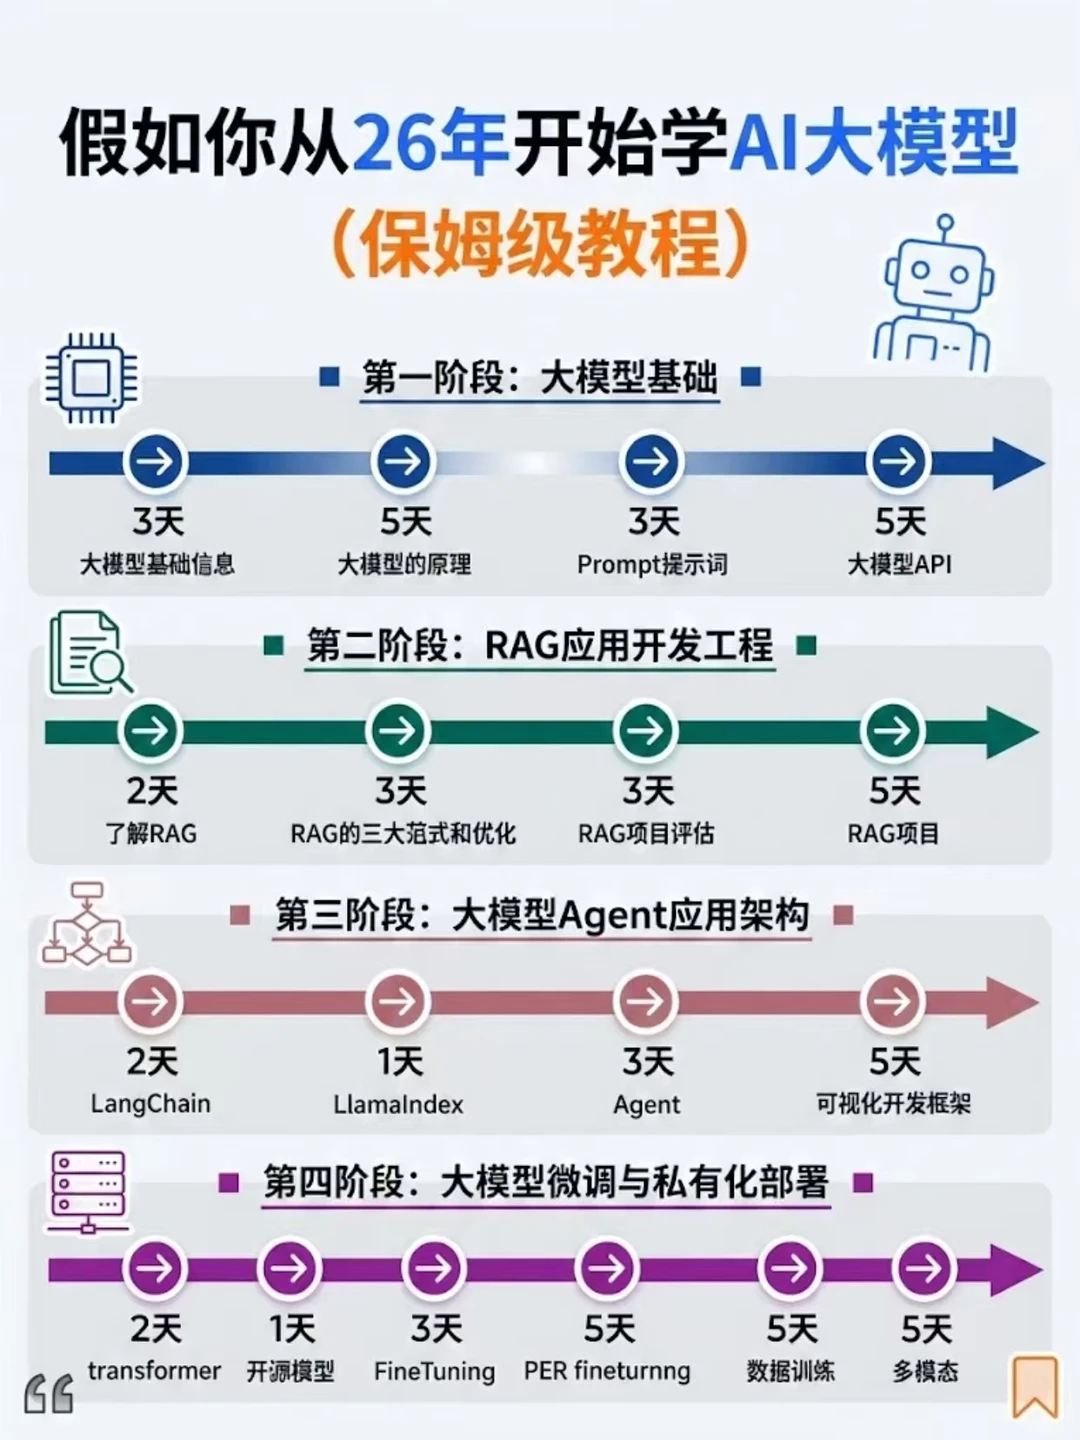
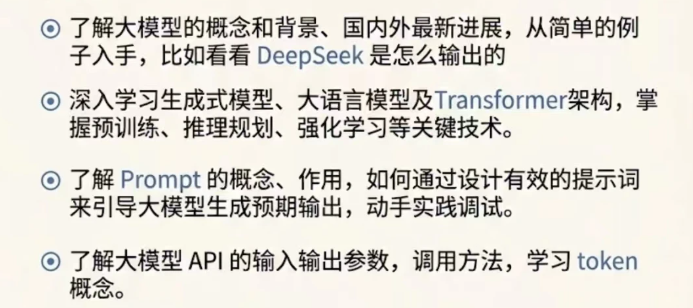
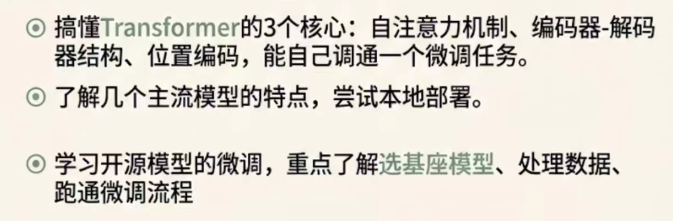
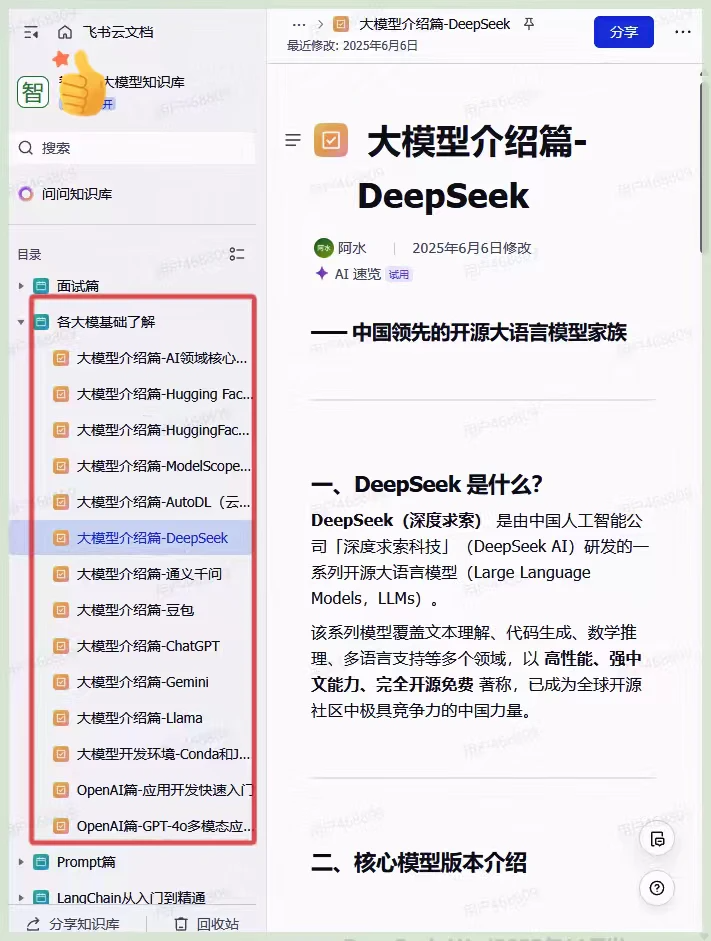
阶段1:大模型基础
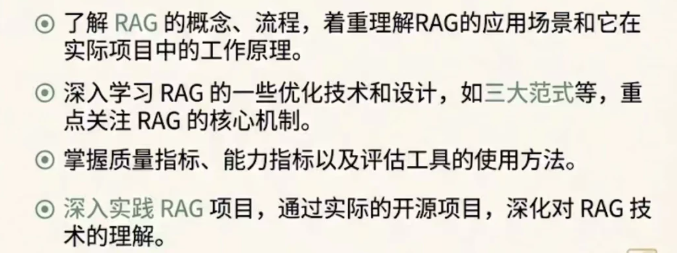
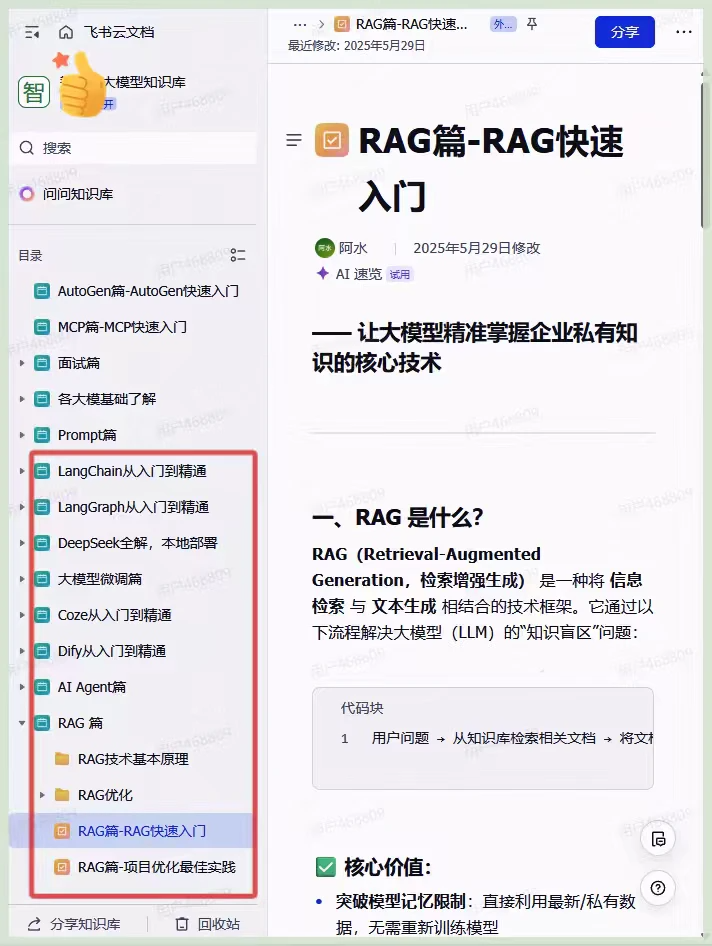
阶段2:RAG应用开发工程
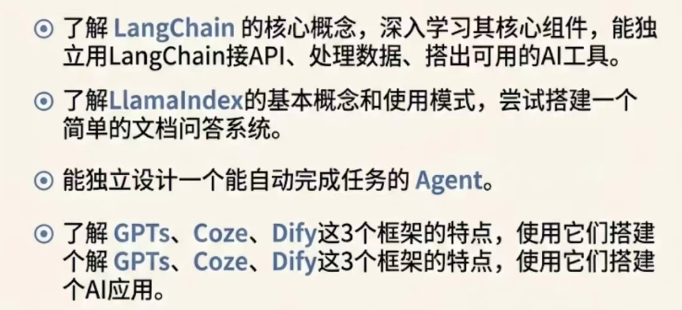
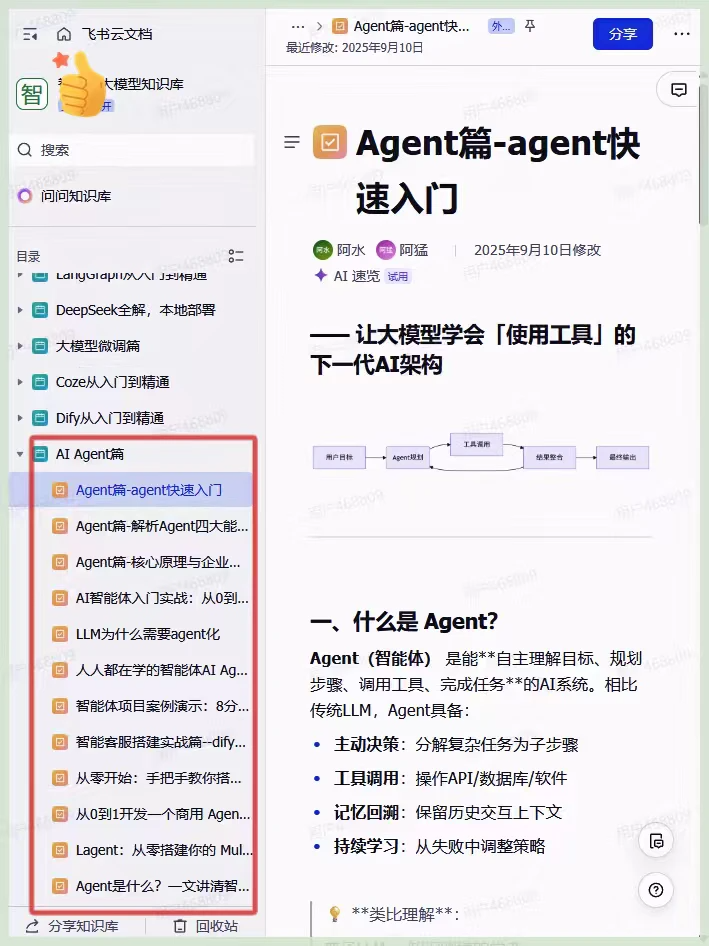
阶段3:大模型Agent应用架构
阶段4:大模型微调与私有化部署
配套文档资源+全套AI 大模型 学习资料,朋友们如果需要可以微信扫描下方二维码免费领取【保证100%免费】👇👇

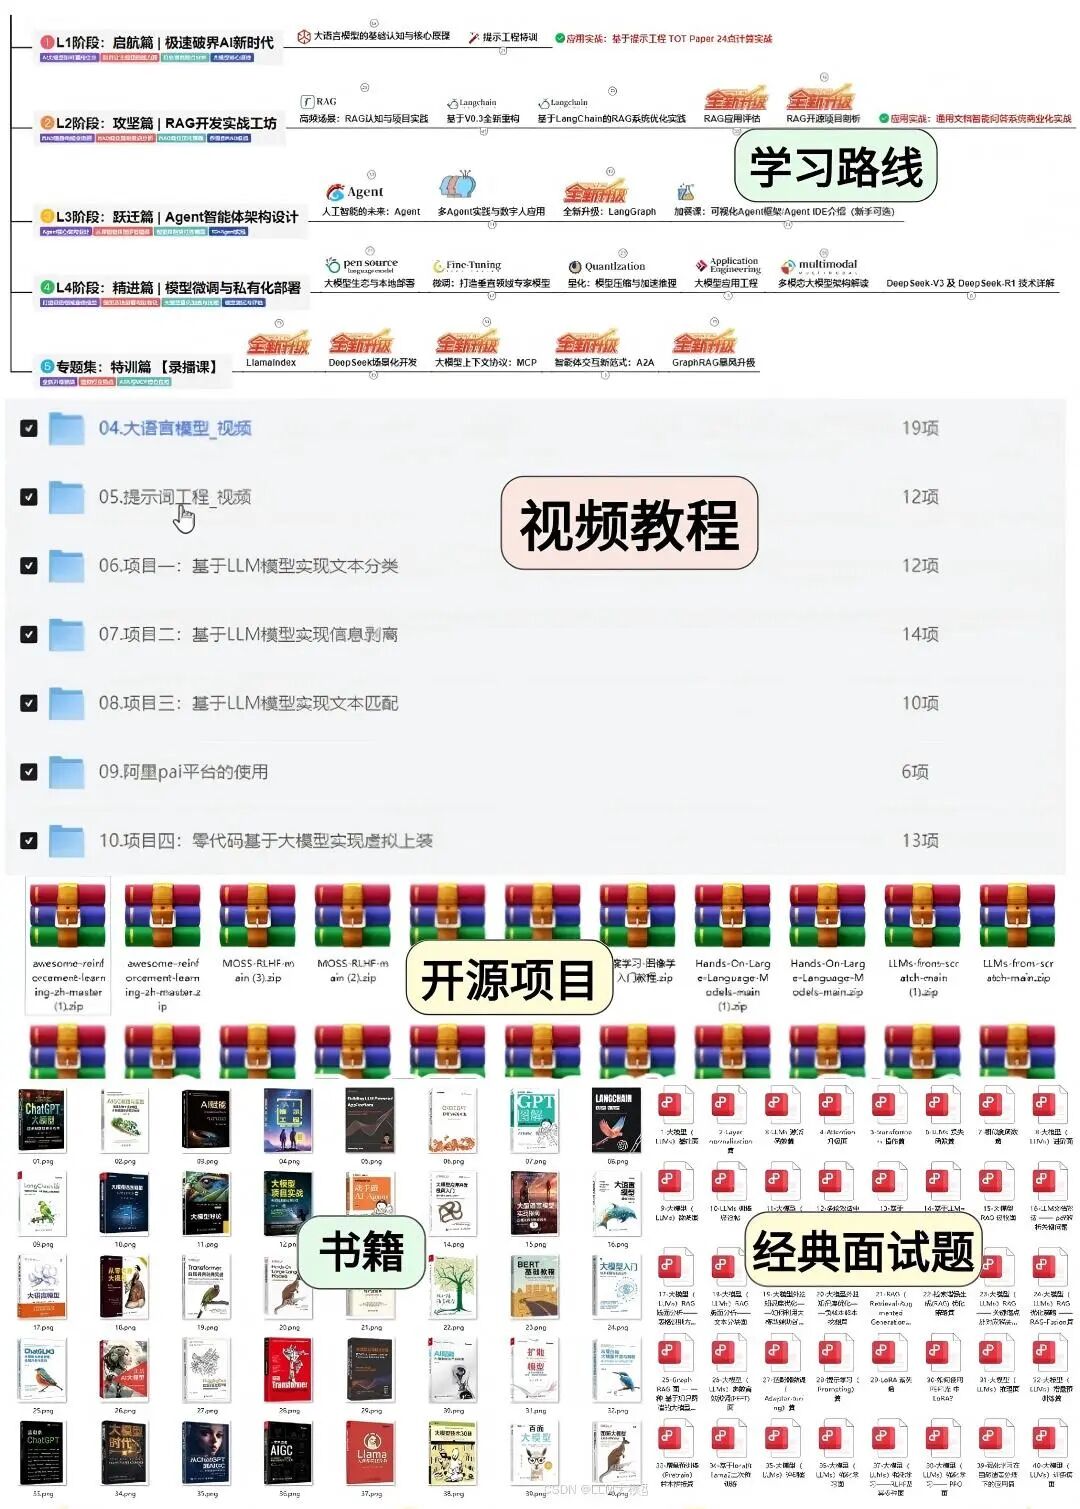
配套文档资源+全套AI 大模型 学习资料,朋友们如果需要可以微信扫描下方二维码免费领取【保证100%免费】👇👇

转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/m0_74942241/article/details/166368253