
摘要:本文从 HTTP 协议的基础概念讲起,介绍其“请求—响应”的通信方式与学习价值;随后借助 Fiddler 抓包工具演示如何观察真实请求和响应,并详细拆解请求行、URL 组成、请求方法、请求头以及响应状态码等核心格式;最后引入 HTTPS,说明对称加密、非对称加密与证书机制如何解决窃听、篡改和身份冒充问题,帮助读者系统理解 HTTP 与 HTTPS 的工作原理。
http协议简单介绍
介绍:
HTTP(HyperText Transfer Protocol,超文本传输协议) 是一种应用层协议,主要用于客户端和服务器之间进行数据通信。我们平时使用浏览器访问网页、登录账号、搜索内容、提交表单,本质上很多操作都是通过 HTTP 请求和 HTTP 响应完成的。
HTTP 采用“请求—响应”的通信方式:客户端向服务器发送请求,服务器处理请求后再返回对应的响应。HTTP 本身主要规定了双方传输数据时的格式和规则,并不负责底层的数据传输,底层通常由 TCP 等协议来完成。
为什么要学习:
我们平时使用交互的过程:用户通过前端发起操作,前端把操作转换成 HTTP 请求交给后端,后端处理后返回 HTTP 响应,前端再把结果展示给用户,所以我们要学习以及认识具体的http协议里面的相关格式以及注意事项
抓包工具辅助学习
抓包是什么
抓包简单理解一下就是将我们在网络中发送以及接收的数据包捕获下来查看一下具体的信息,这里面包含的信息就是我们需要学习的
抓包演示
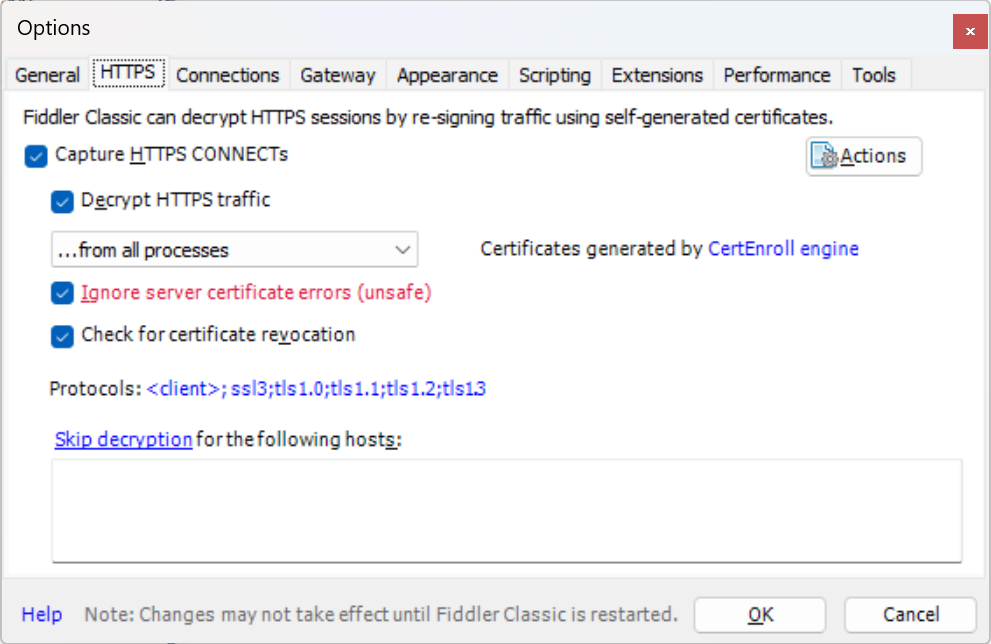
抓包我这边介绍的是fiddler这样一个代理工具,我们首次使用的时候需要把这个https的设置打开,接下来我来演示一下如何抓包,假设我先点开一个百度的网站,在左边找到我们刚刚打开的百度,右边点击raw来更好的查看我们请求以及响应的格式,也可以右下角用记事本打开
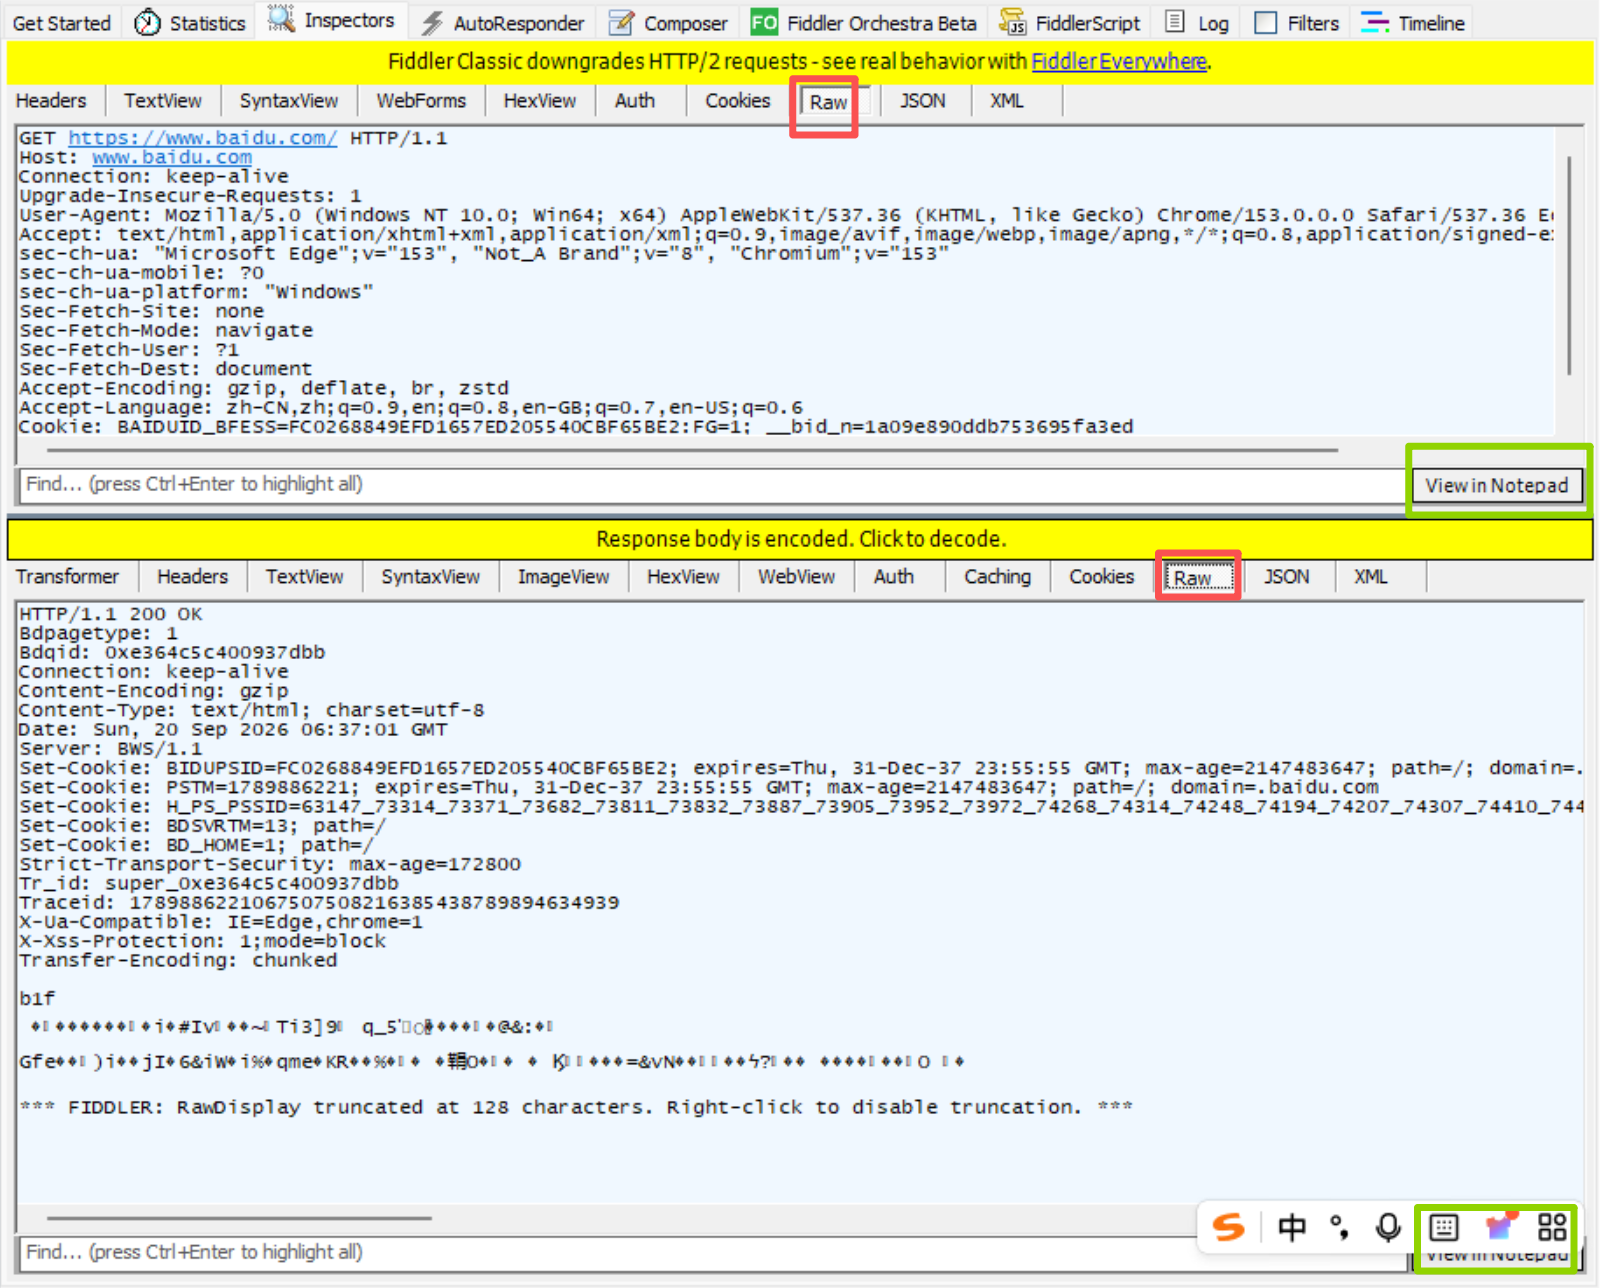
请求以及响应格式
先通过一张图来简单大概的扫一眼
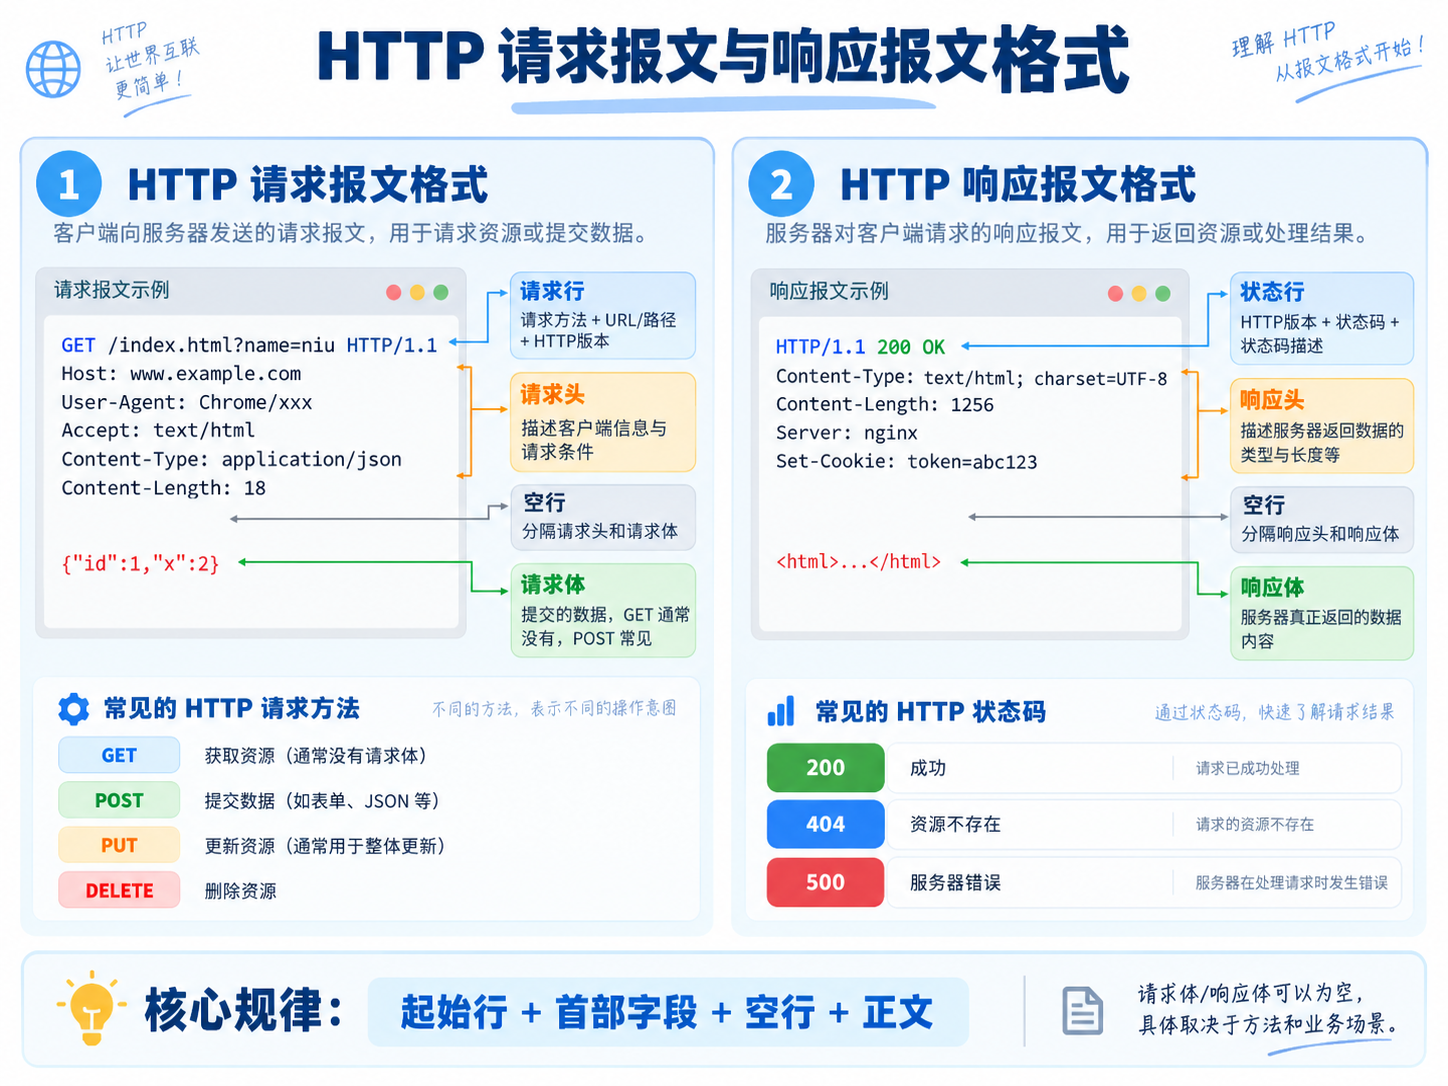
请求
请求行
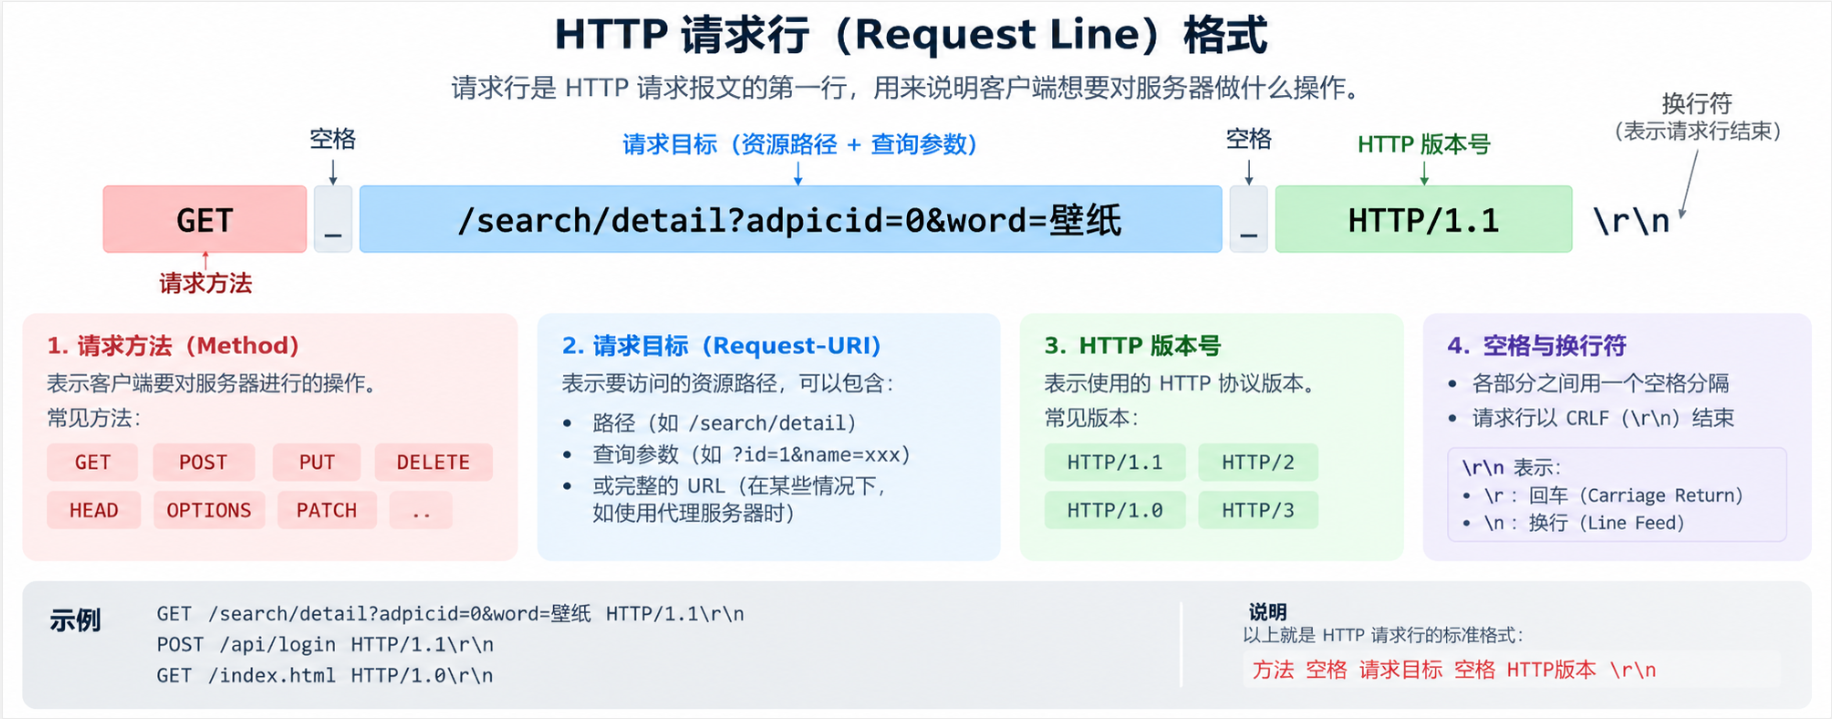
URL
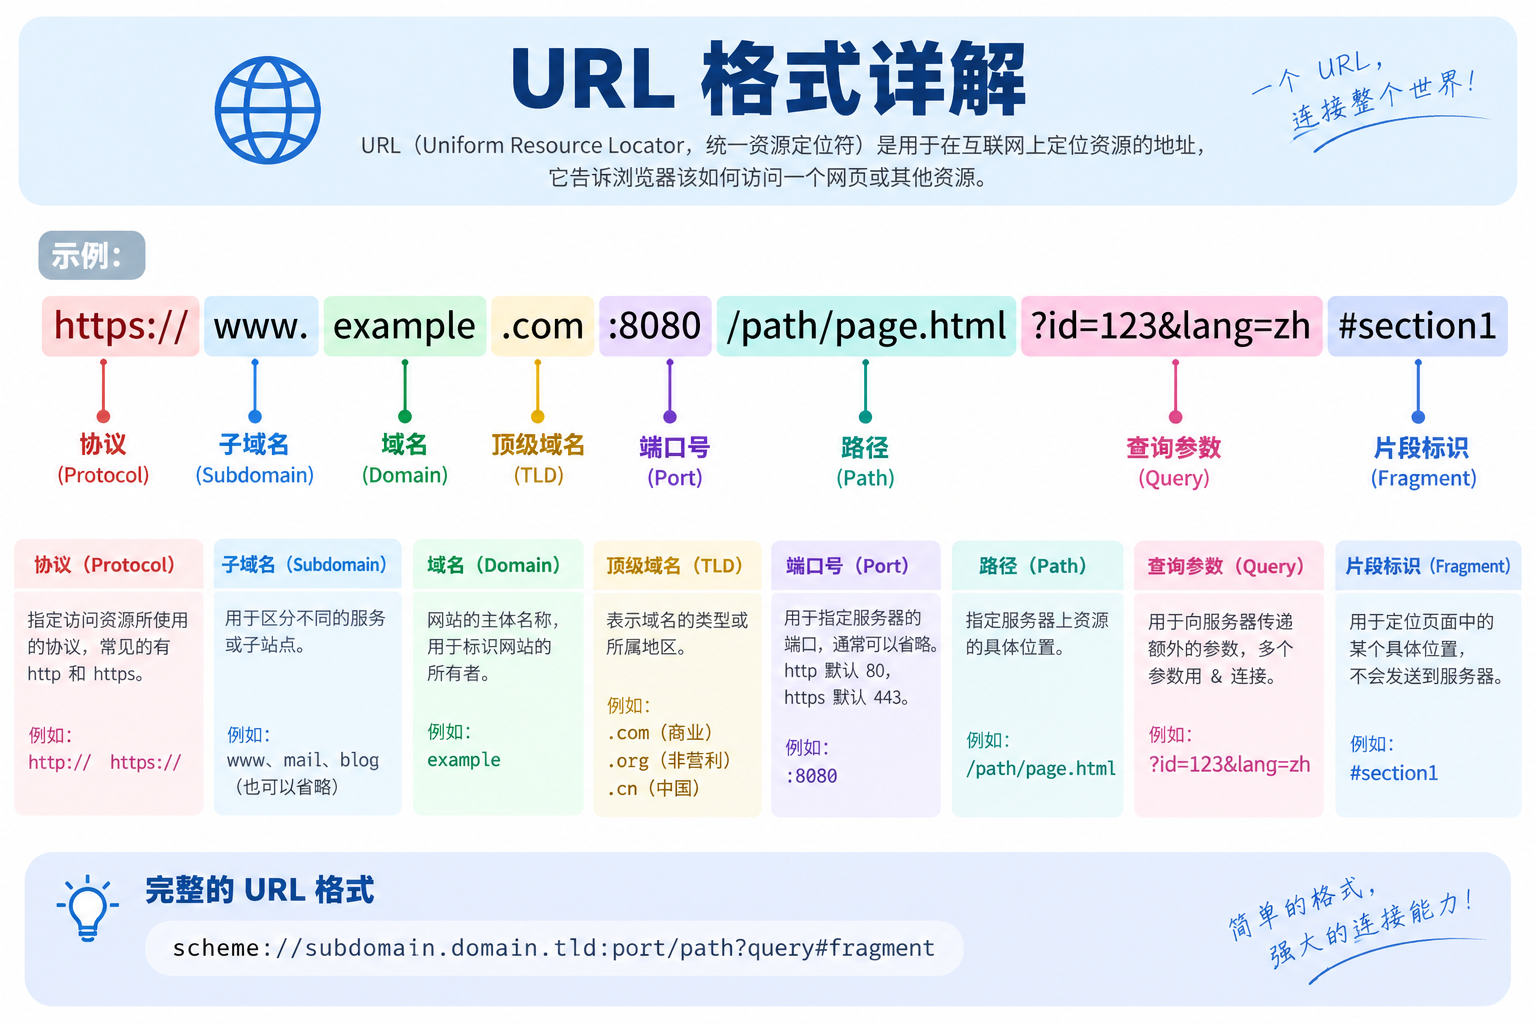
URL(统一资源定位符)标识一个网络上的资源位置,分别由上面这些共同的部分组成。
协议:一般就是http或者https,https是http的一个加密版本
接下来的子域名,域名以及顶级域名一起构成了一个服务器的地址
端口:8080 就是一个端口号,一般这个端口号是根据协议默认的,比如 HTTP 默认 80,HTTPS 默认 443,你平时看网站的 URL 时,一般没有看到端口号,说明就是默认了的;看到这里可能会有一个疑惑,不是说端口号是区分应用程序的吗,在我的理解里面不应该是百度自己一个端口号,抖音一个端口号,那按我这么说的不是他们两个都是 HTTPS 的话,那么端口号也就一致了吗:没错,端口号是一样的,都是 443,但是前面有个观点是错的,就是端口不是直接确认应用程序,端口对应的是“某台主机上的网络服务入口”,不是某个网站或者某个 App 的编号,网络服务入口就是外部网络请求想找到这台主机里的某个网络程序的时候,要通过哪个端口进去,所以我们确认某个应用程序的时候还要结合网址一起来看,也就呼应我们前面说到的五元组。
路径:这个就标识了你现在访问的这个页面是在哪个路径下的,不过你自己看的url里面,他们的服务器可能并不一定真的有这个文件夹,更像是一个路由地址
查询参数(query string):这个是键值对格式的数据,通过&来分割,=左边是key,右边是value,这个是由程序员来决定的,一般标识了某个内容的具体信息
片段标识:一般区分一个网页中的具体内容,这个一般是在文档类的网站上容易看到,为了让浏览器跳到当前页面里的某个具体位置,这个可以有可以没有,看具体情况
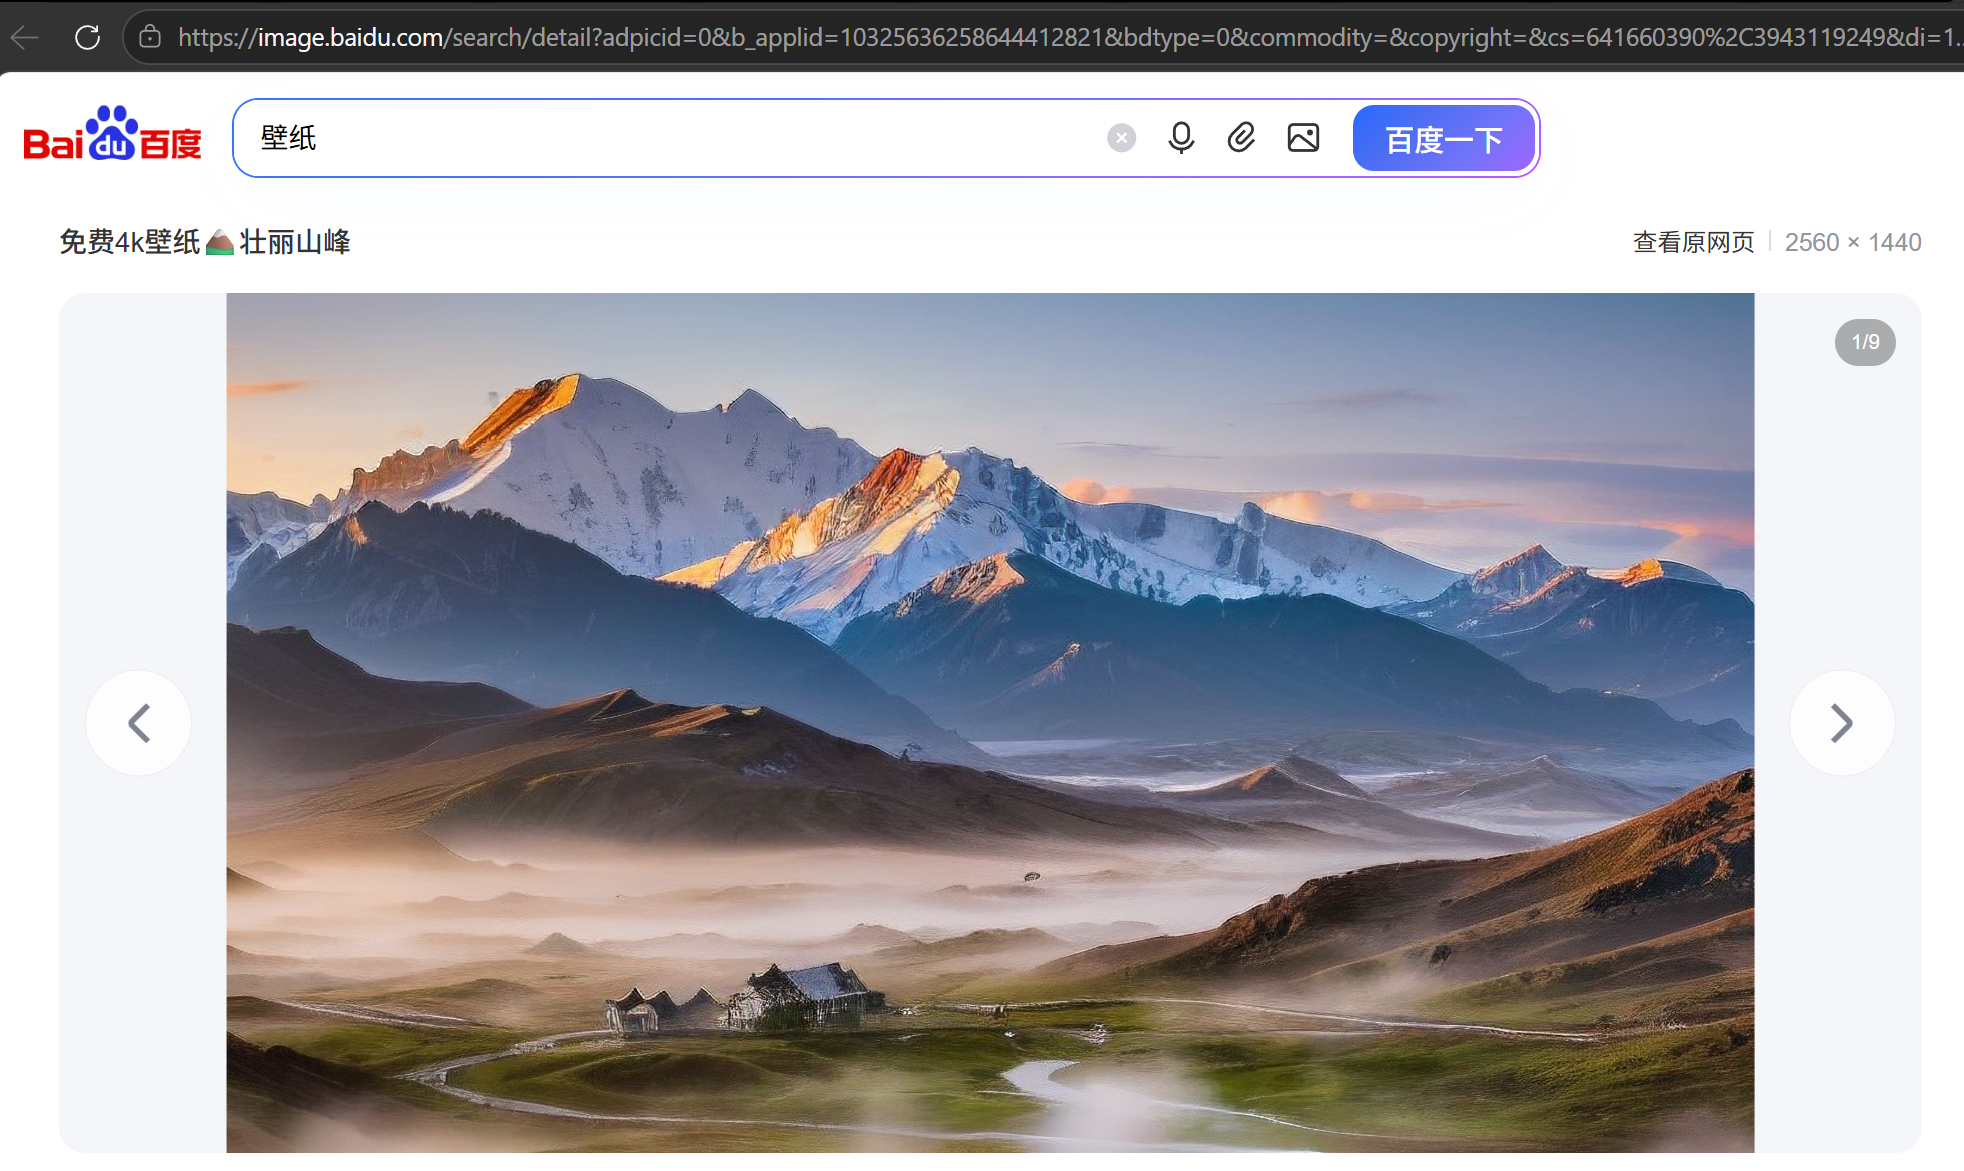
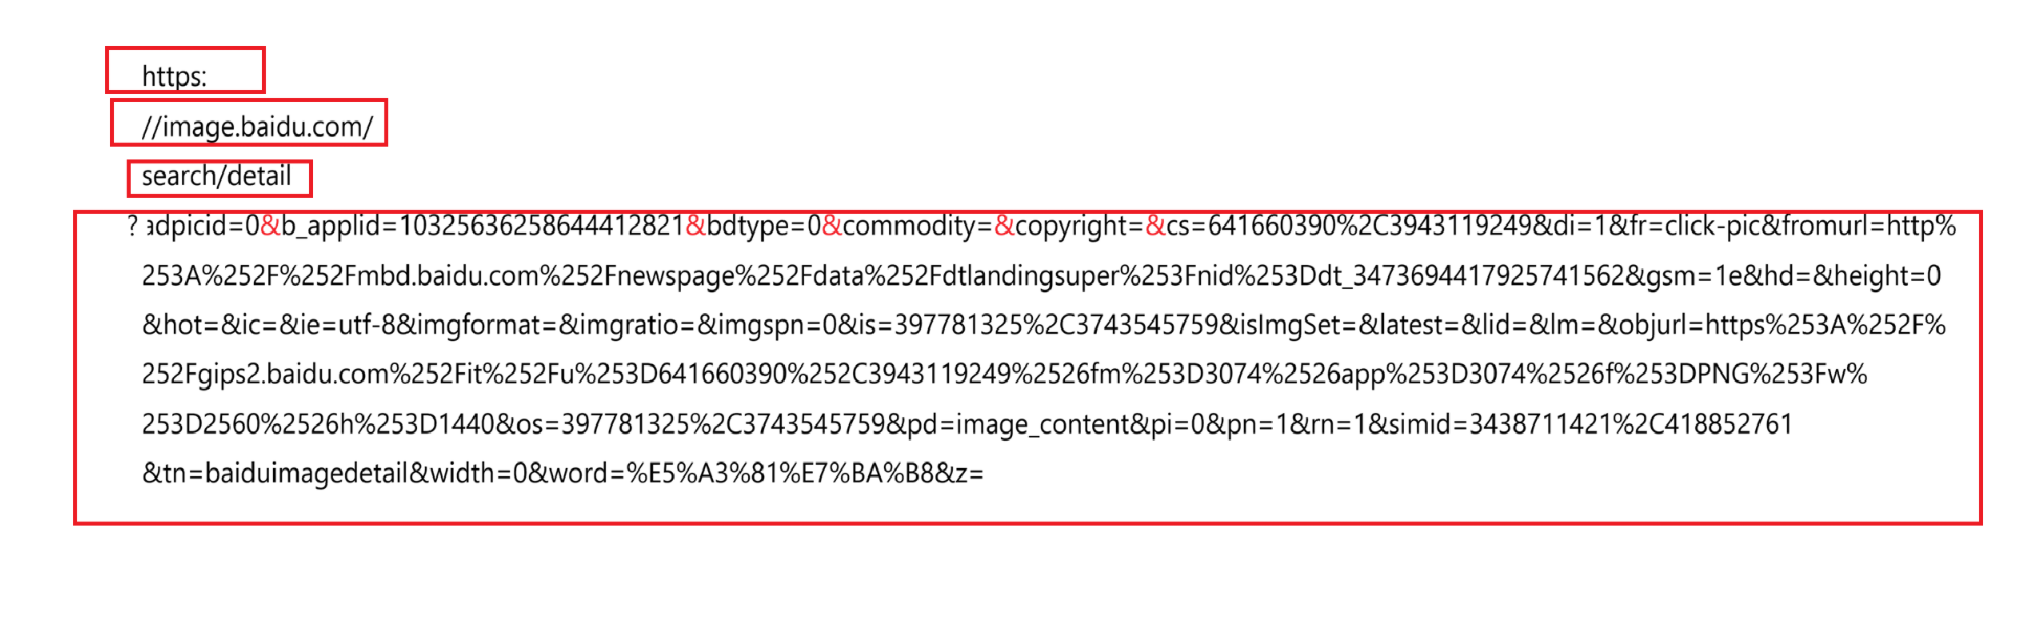
我们结合这个具体的url来分析一下,这个是我点开百度壁纸图片里的具体的一张图片的url
https就是协议,image.baidu.com就是服务器的地址,这里协议是https,所以默认端口是443,不过这个可能不会写,然后search/detail就是路径,可能百度的服务器并不一定真的有这么一个文件夹来存储我搜到的这个图片,更像是要通过更像是告诉服务器“我要访问图片搜索中的详情功能”,而后面的 ?xxx=xxx 查询参数,则进一步告诉服务器“我具体想看哪一张图片”。
URL encode
当 query string 里包含了特殊符号的时候,我们就得进行 encode 转码,具体操作就是将 query string 的每个字节拿到,根据 ASCII 码表的 16 进制表示,并且在前面加上 %,就比如 + 号通过 ASCII 码的 16 进制表示是 0X2B,所以通过转码就是 %2B。
方法
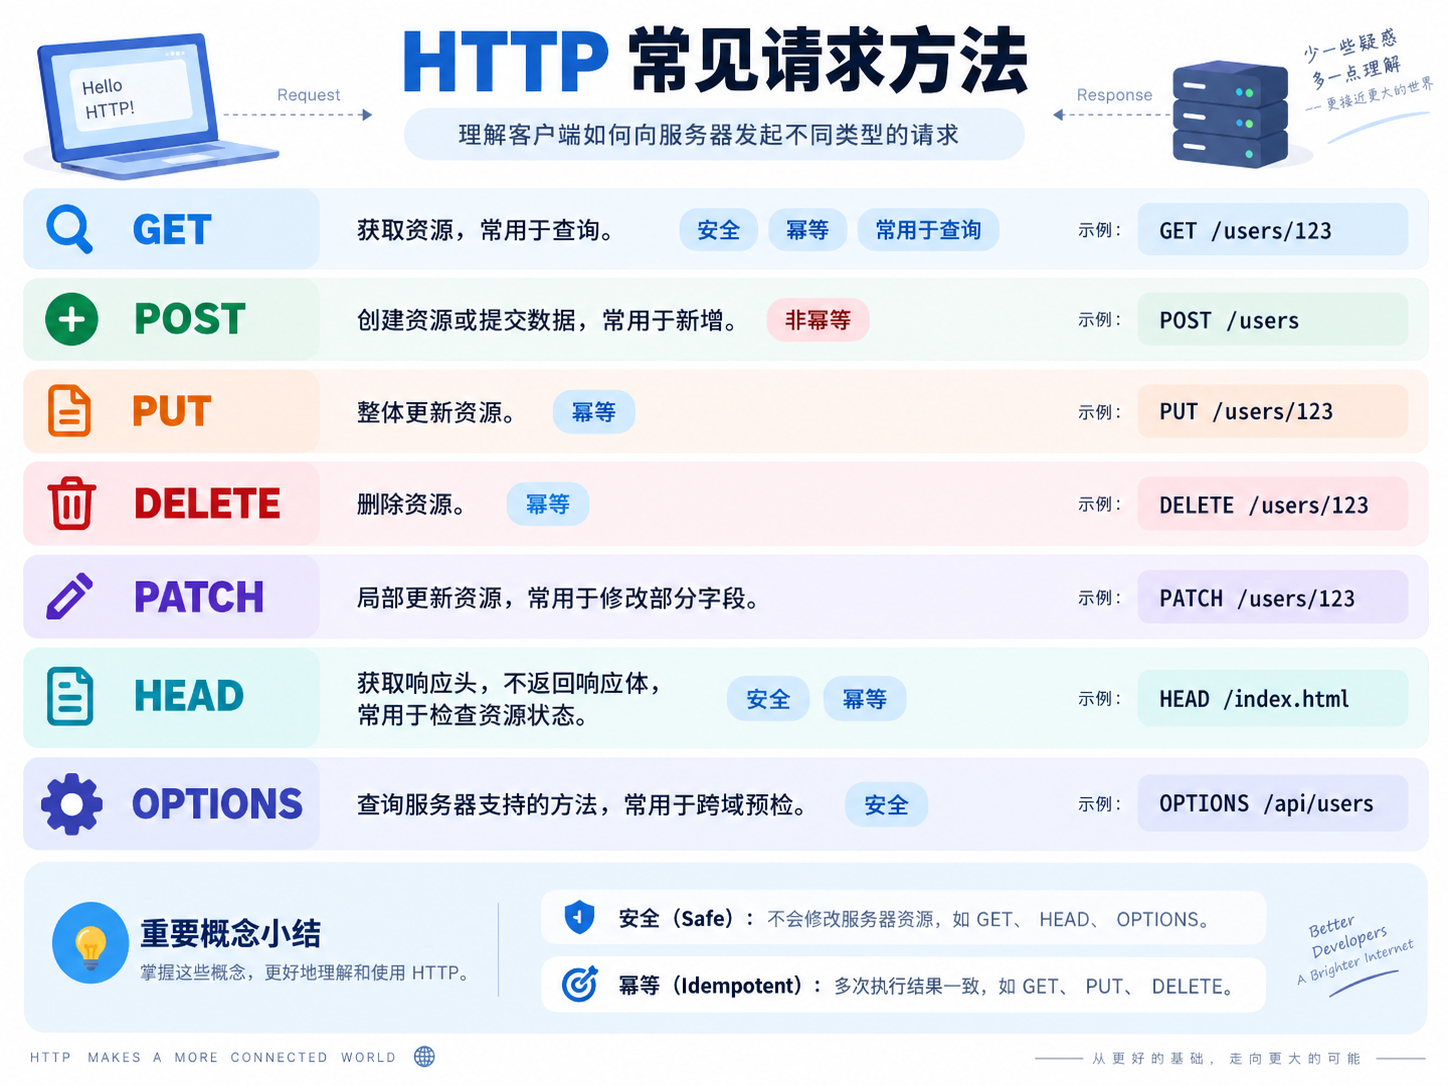
方法就是url前面的GET/POST之类的,我们来对常见的方法进行一个介绍,请求方法一般是程序员在代码里决定的,并且这些作用是最开始http开发的时候开发者的一个美好期望,不是说post不能获取资源,这个一般是程序员决定的,并且GET是最常用的
GET:从服务器中拿取数据,get一般没有body,一般get的信息会写在query string里面,就比如我在百度里面搜索一个java,然后通过抓包工具拿到请求观察一下
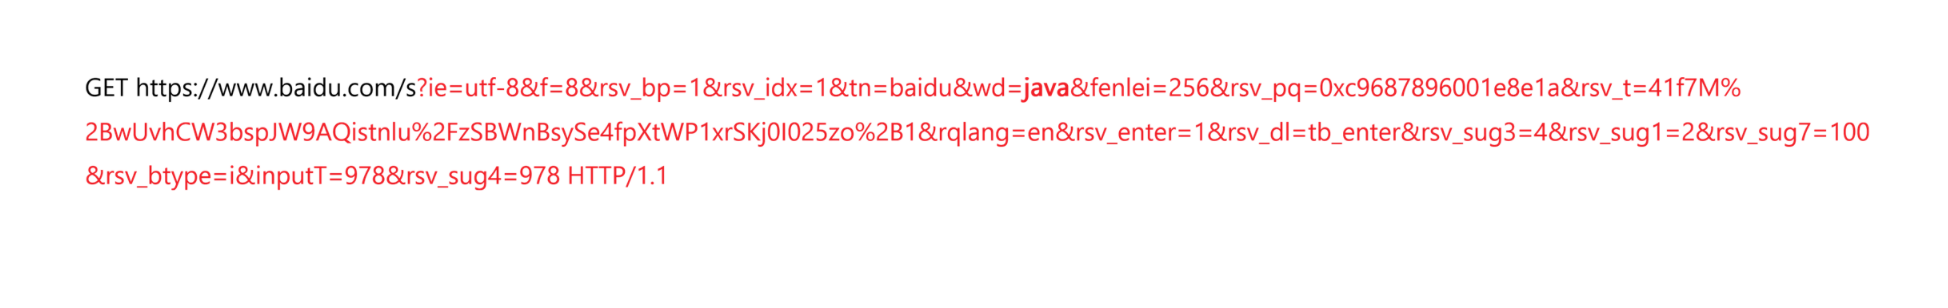
里面就可以看到我们刚刚搜索的java,以及一些其他的信息
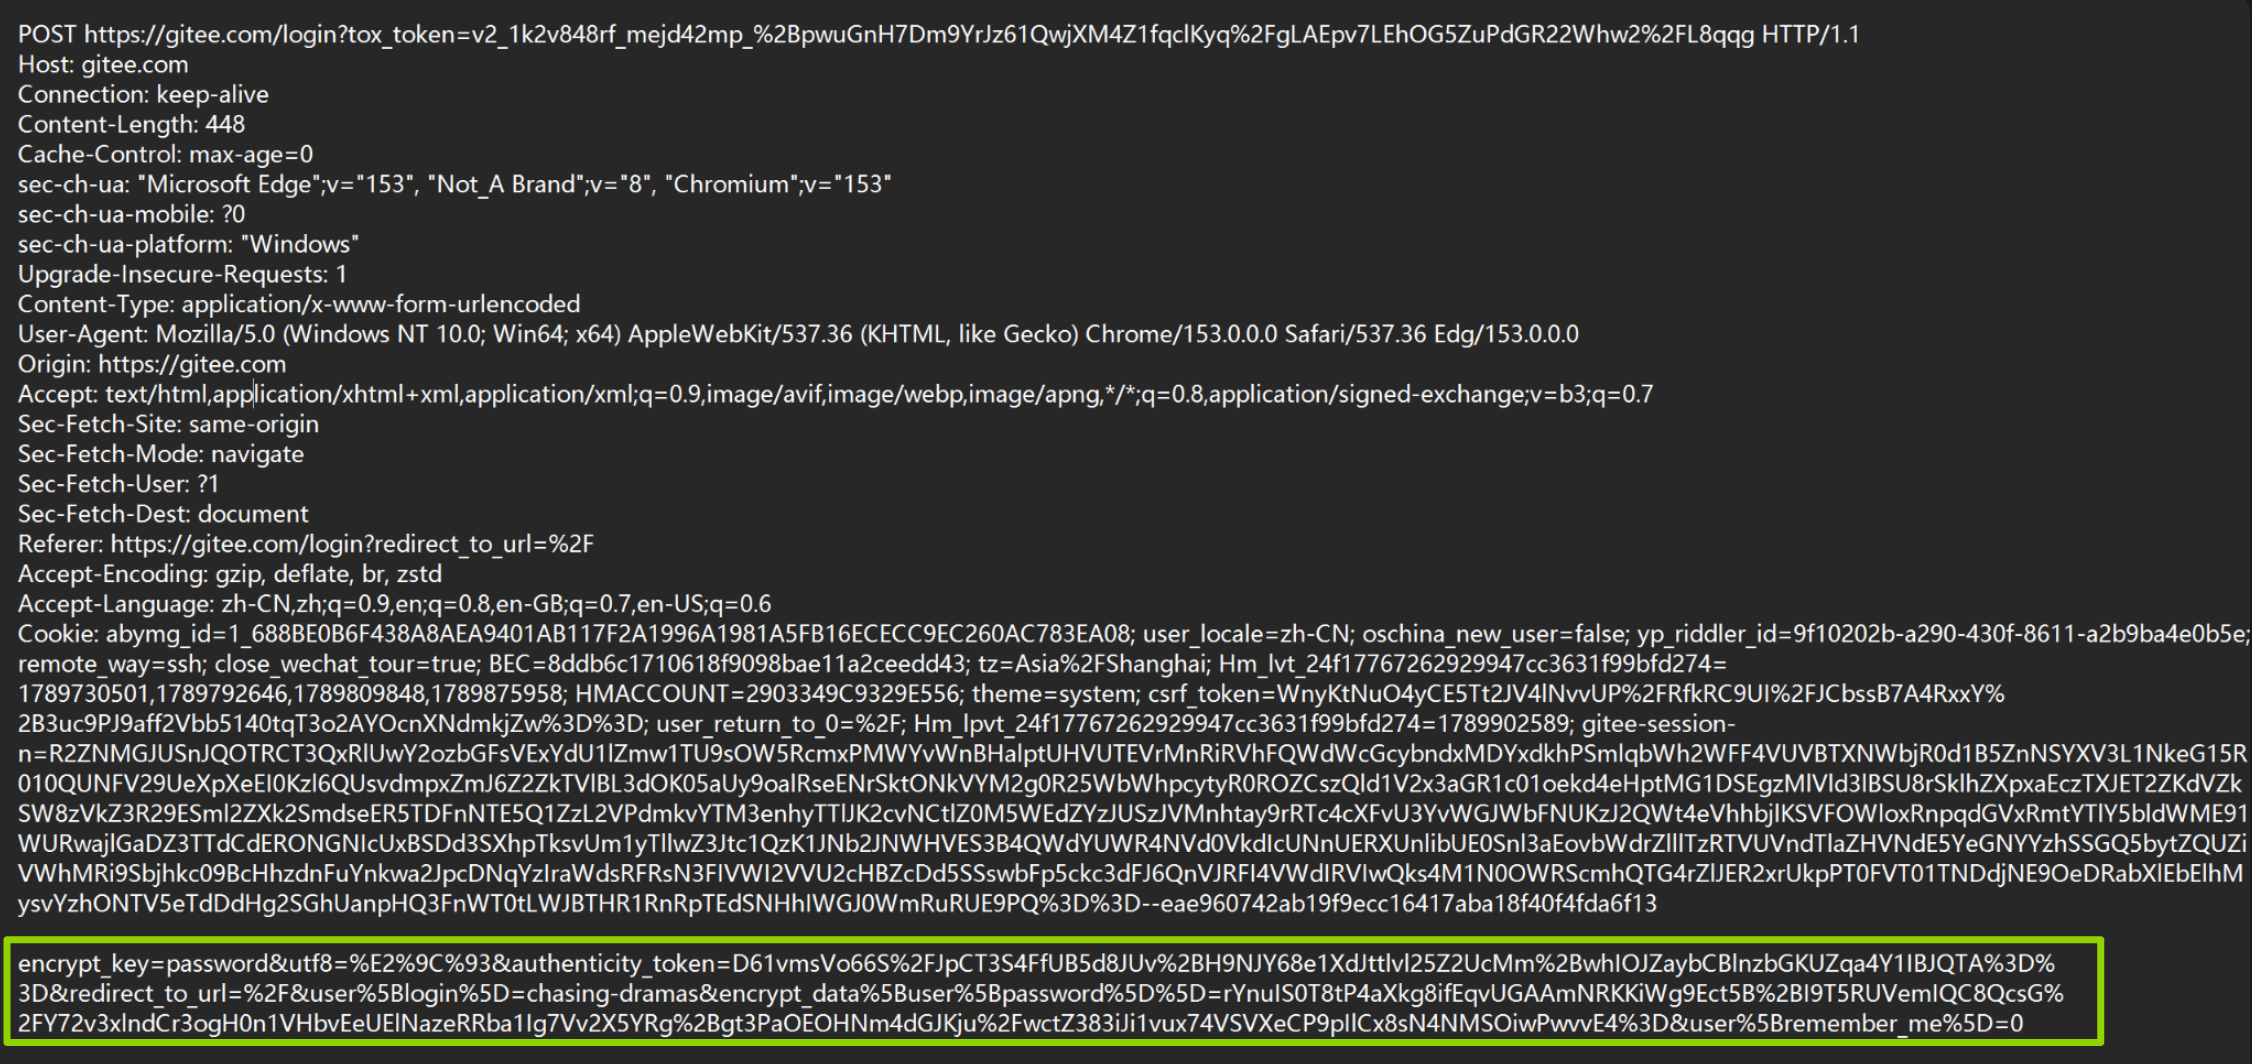
POST:post一般有body,并且一般在登录以及上传一个文件的时候多见,比如下面这个就是我在登录gitee之后抓的包,里面方法就是post
GET和POST的区别(面试考点):
1,GET 请求一般实现成幂等,POST 一般没有这个要求【什么是幂等:如果这个请求重复产生以后结果不明确,就是不幂等,就好比抖音的视频页面你刷新就会有不一样的视频,通过大数据进行分析给你想要的结果,这当然是不幂等】
2,GET 偏查询,参数通常放 URL,POST 偏提交,数据通常放 Body
3,POST 并不天然比 GET 安全,安全传输依赖 HTTPS
PUT:一般用于更新,数据也放在body
DELETE:删除,类似于get,没有body
请求头
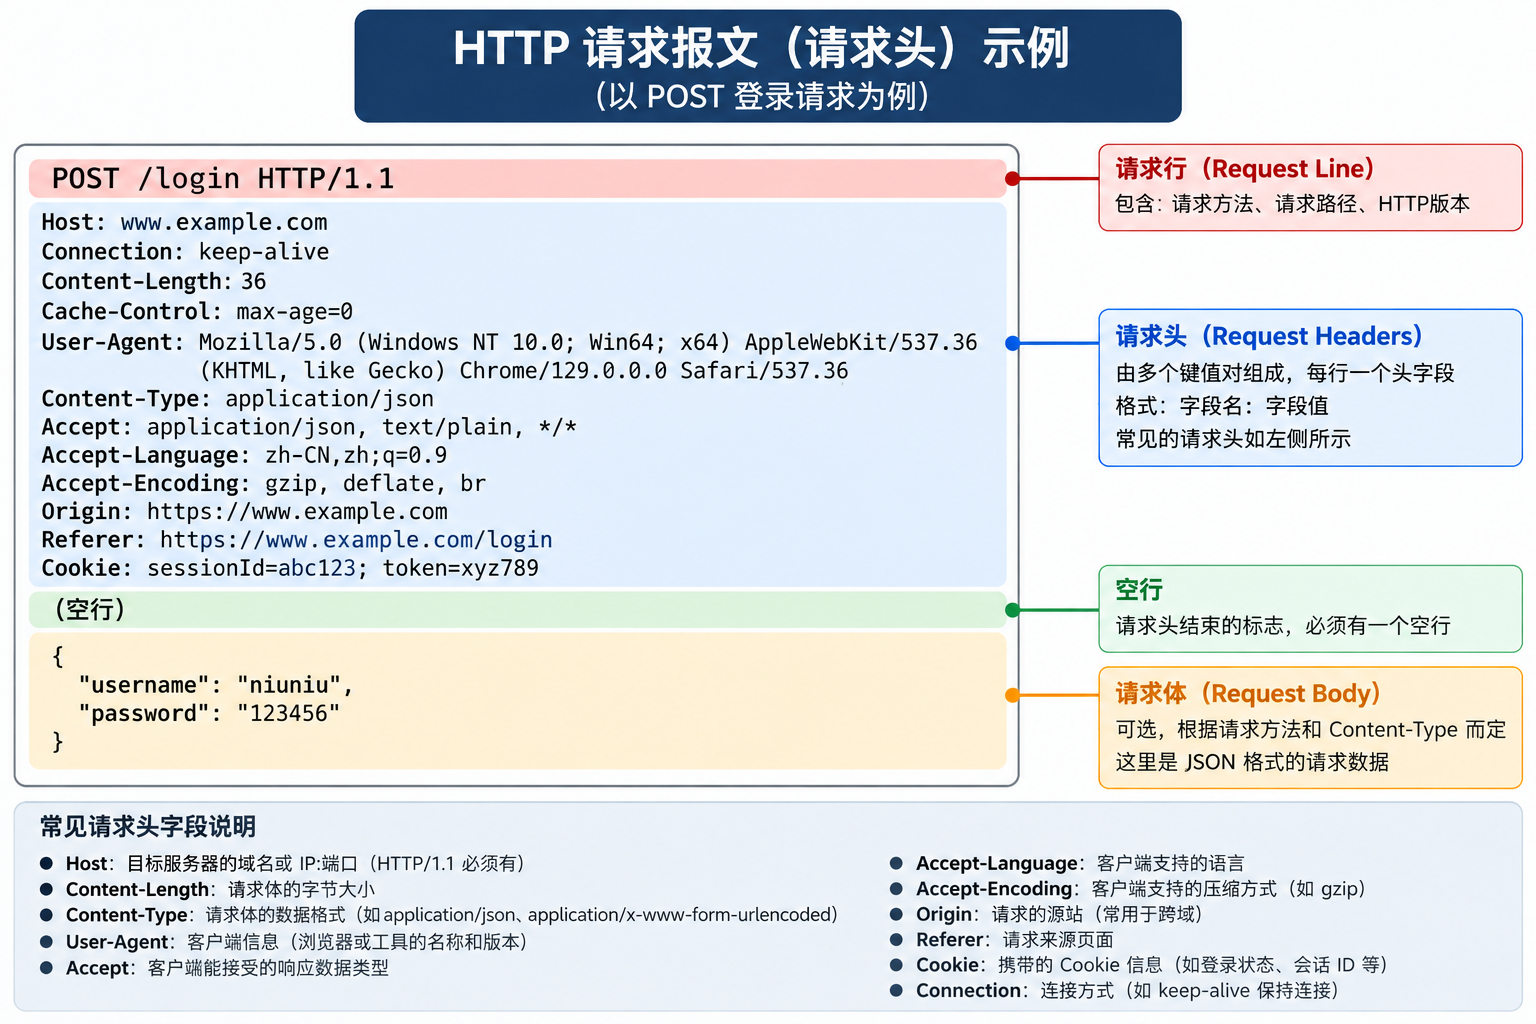
Host:表示服务器主机的地址和端口
Content-Length:表示body中的数据长度,因为tcp是面向字节流的,所以可能出现粘包问题【http3一下的版本都是tcp传输的】
Content-Type:表示body数据的格式
| Content-Type | 用途 |
|---|---|
application/json | JSON 数据,前后端接口最常见 |
application/x-www-form-urlencoded | 普通表单提交 |
multipart/form-data | 文件上传 + 表单数据 |
text/html | HTML 页面 |
text/plain | 普通文本 |
application/xml / text/xml | XML |
image/jpeg | JPEG 图片 |
image/png | PNG 图片 |
application/octet-stream | 通用二进制数据/文件下载 |
User-Agent:告诉服务器客户端是什么浏览器、系统等

Mozilla/5.0 主要是历史兼容标识,不代表当前浏览器就是 Mozilla;真正的浏览器身份要看 UA 后面的具体字段,这里也可以看到我们的操作系统版本以及多少位
Referer:表示这个页面是从哪个页面跳转过来的

这个就可以看出是从gitee登录页面跳转来的,这个跳转就涉及到一个很有趣的事情了,就是我们的广告系统是通过广告主那边的点击数量以及我网站的服务器维护的一个日志进行匹配来看多少钱的,所以在早些年的时候,运营商会截胡请求,然后修改里面的referer来源,来赚取利益,所以后面都转战https了,因为https有加密,这个后面会聊
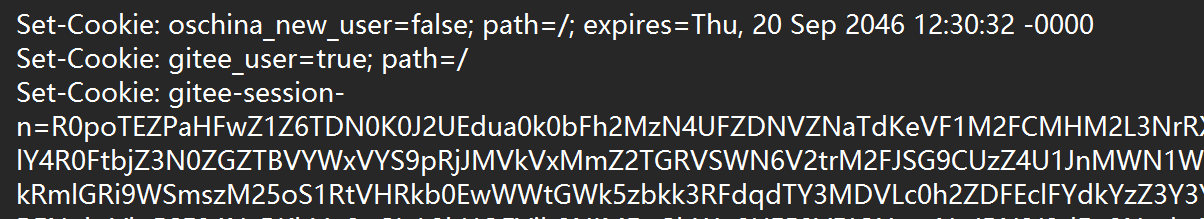
Cookie:浏览器这端本地存储数据的方式,这个cookie哪里来的,是服务器返回的,按照字符串(键值对)的形式存储,按照域名划分,每个域名有自己的cookie,本地存储之后,后续访问同一个网站,就会把cookie的内容通过请求报头,传输给服务器
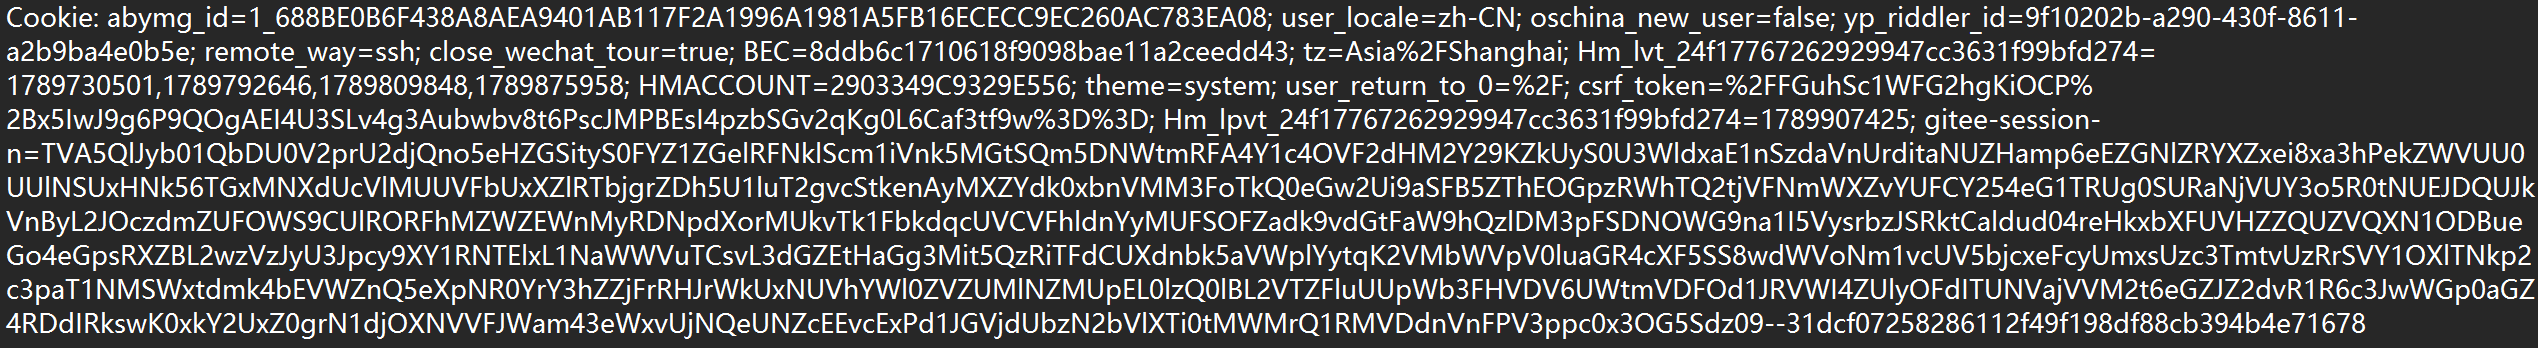
下面这个是返回的响应
apifox
这是一个构造请求的工具
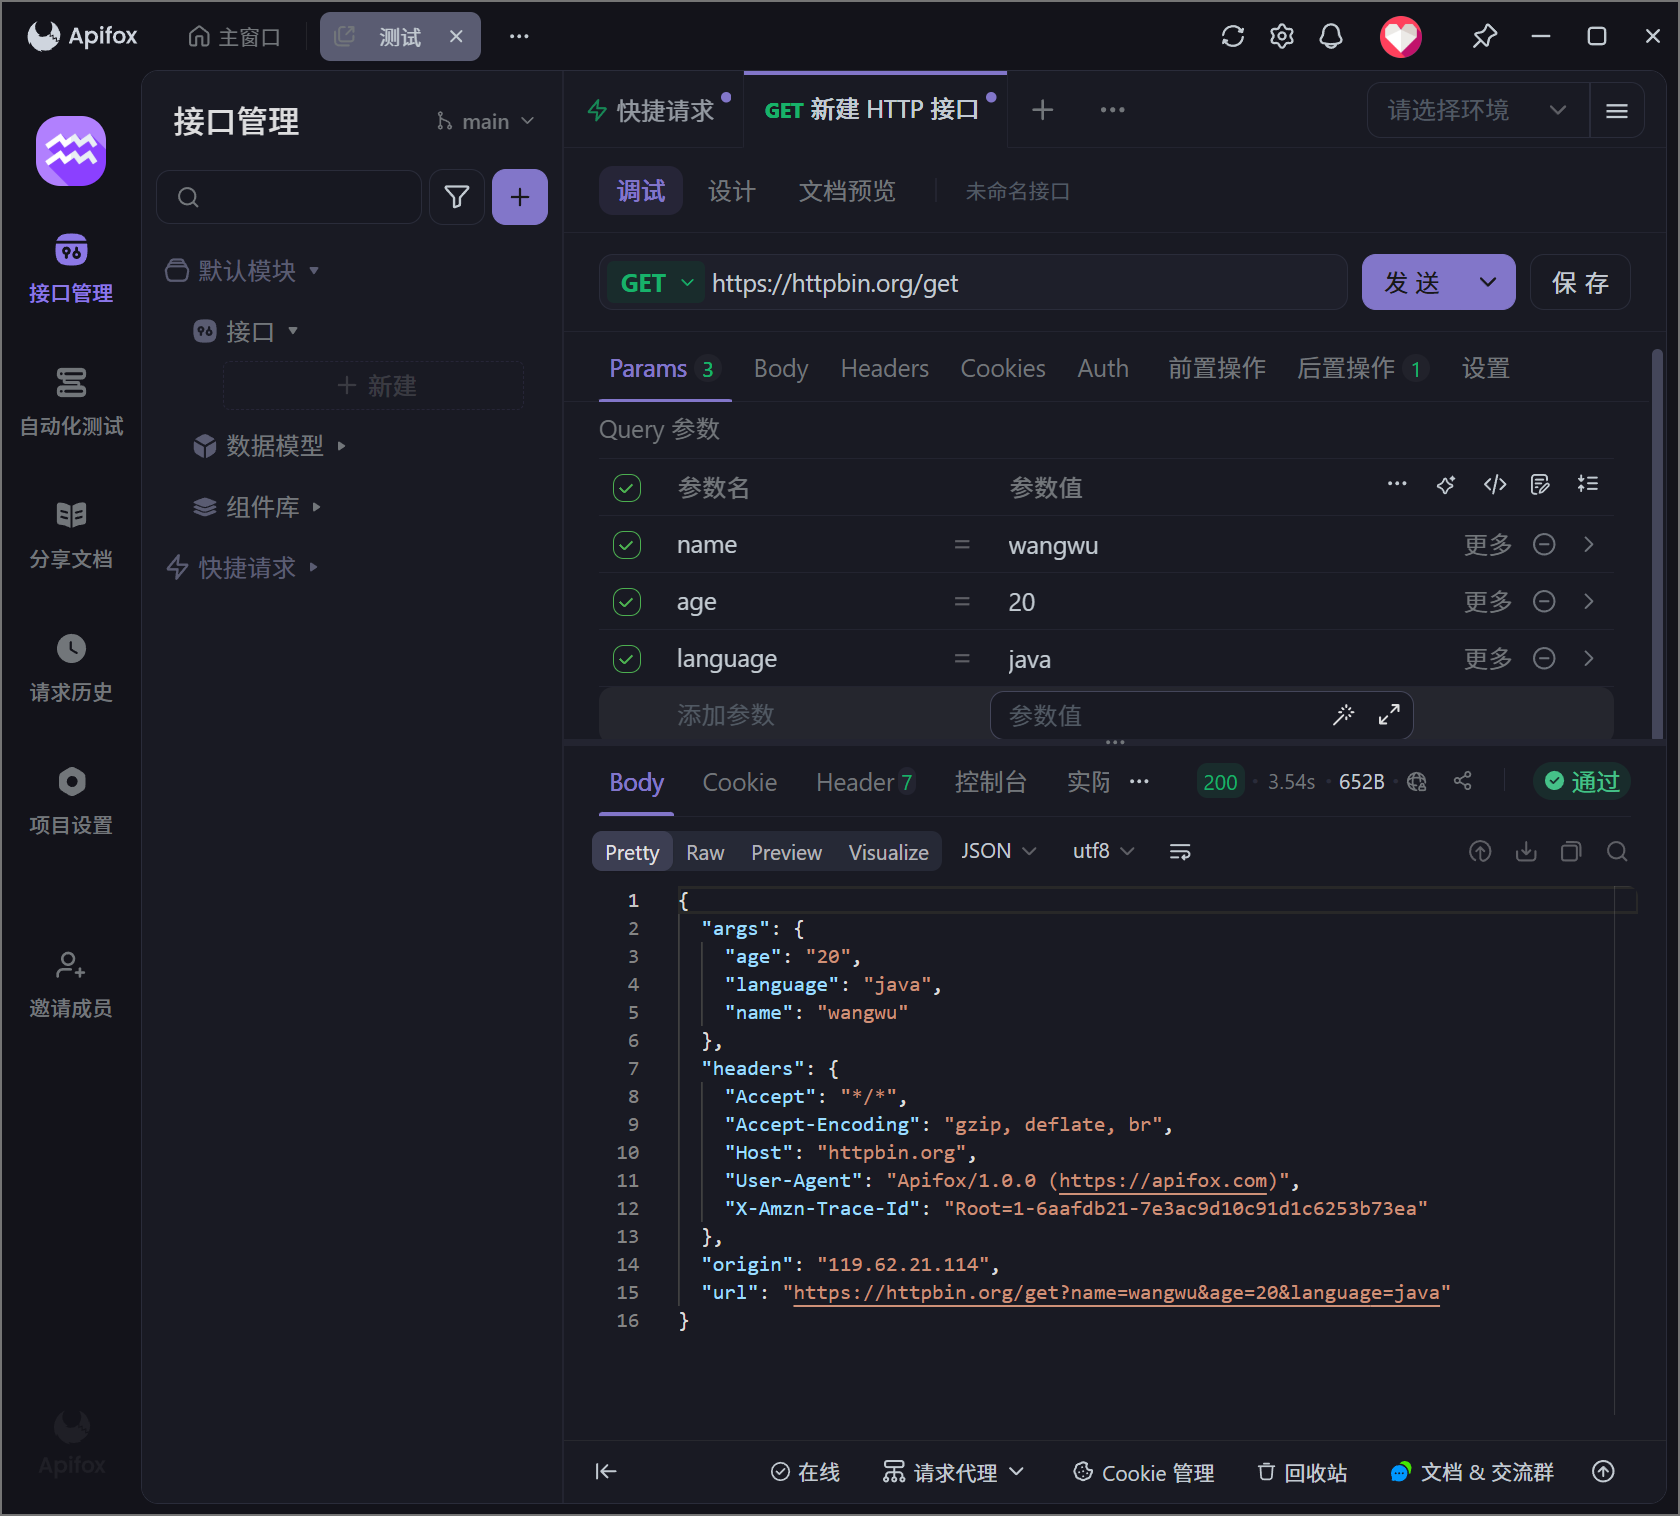
我们以这个为例,这是一个专门测试http的网站,会将你的请求回显回来,这个软件就是模拟前端,主动给后端发 HTTP 请求,然后看后端返回什么,也可以帮助我们学习http的格式
响应
状态码
认识常见的状态码
| 范围 | 含义 | 常见理解 |
|---|---|---|
1xx | 信息类 | 请求还在处理中 |
2xx | 成功 | 请求成功 |
3xx | 重定向 | 需要去别的地址/使用缓存 |
4xx | 客户端错误 | 请求本身有问题 |
5xx | 服务器错误 | 后端处理出问题 |
200 → 成功
400 → 请求有问题
401 → 未认证
403 → 无权限
404 → 找不到
405 → 请求方法不允许
500 → 后端异常
502 → 网关错误
503 → 服务不可用
504 → 网关超时
https
为什么要引入https:
HTTP 主要有三个问题:
- 容易被窃听:账号、密码、Cookie、请求内容可能被别人看到。
- 容易被篡改:传输中的数据可能被中间人偷偷修改。
- 无法可靠确认服务器身份:你以为连的是正规网站,实际上可能被中间人冒充。
所以引入了 HTTPS:
HTTPS = HTTP + TLS
我们先简单介绍一下加密
明文:要传输的原始数据
密文:把明文进行加密
然后我们还要介绍两个很重要的概念
对称加密:加密和解密使用同一把密钥
非对称加密:两把钥匙,公钥加密 → 私钥解密
我们通过画图来简单介绍一下这两个加密,以及可能会被黑客攻击的场景
对称加密:由于我们加密解密都是使用这一把钥匙,所以每个人的钥匙肯定是不一样的,这个钥匙可以通过客户端随机决定的,那么当我们客户端决定了一个钥匙,肯定要将这个钥匙通过网络传输交给服务器,这样才能进行后续的加密以及解密
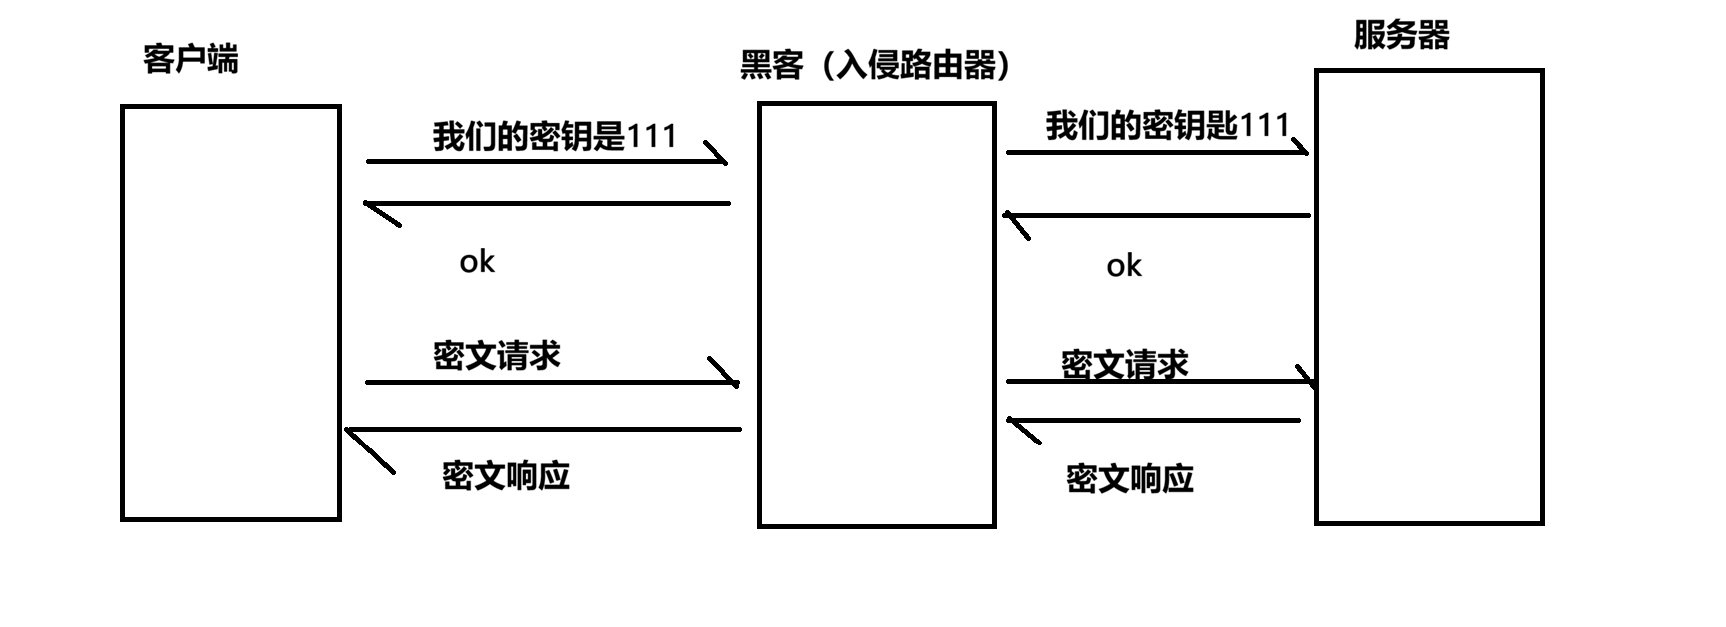
所以就像是这样的情况,我们就会被黑客攻击
所以我们就要引入非对称加密
非对称加密:我们通过公钥来加密,用私钥来解密,这个非对称加密的首要任务就是通过这个形式来加密传输一个对称加密时候用到的共同密钥,因为我们对称加密的效率是更高的,以及消耗是更少的,所以我们一般都是通过对称加密的形式来传输,但是对称加密传输的密文又容易被黑客截胡,所以我们先通过非对称的形式来传递这个对称密钥,之后再对称加密
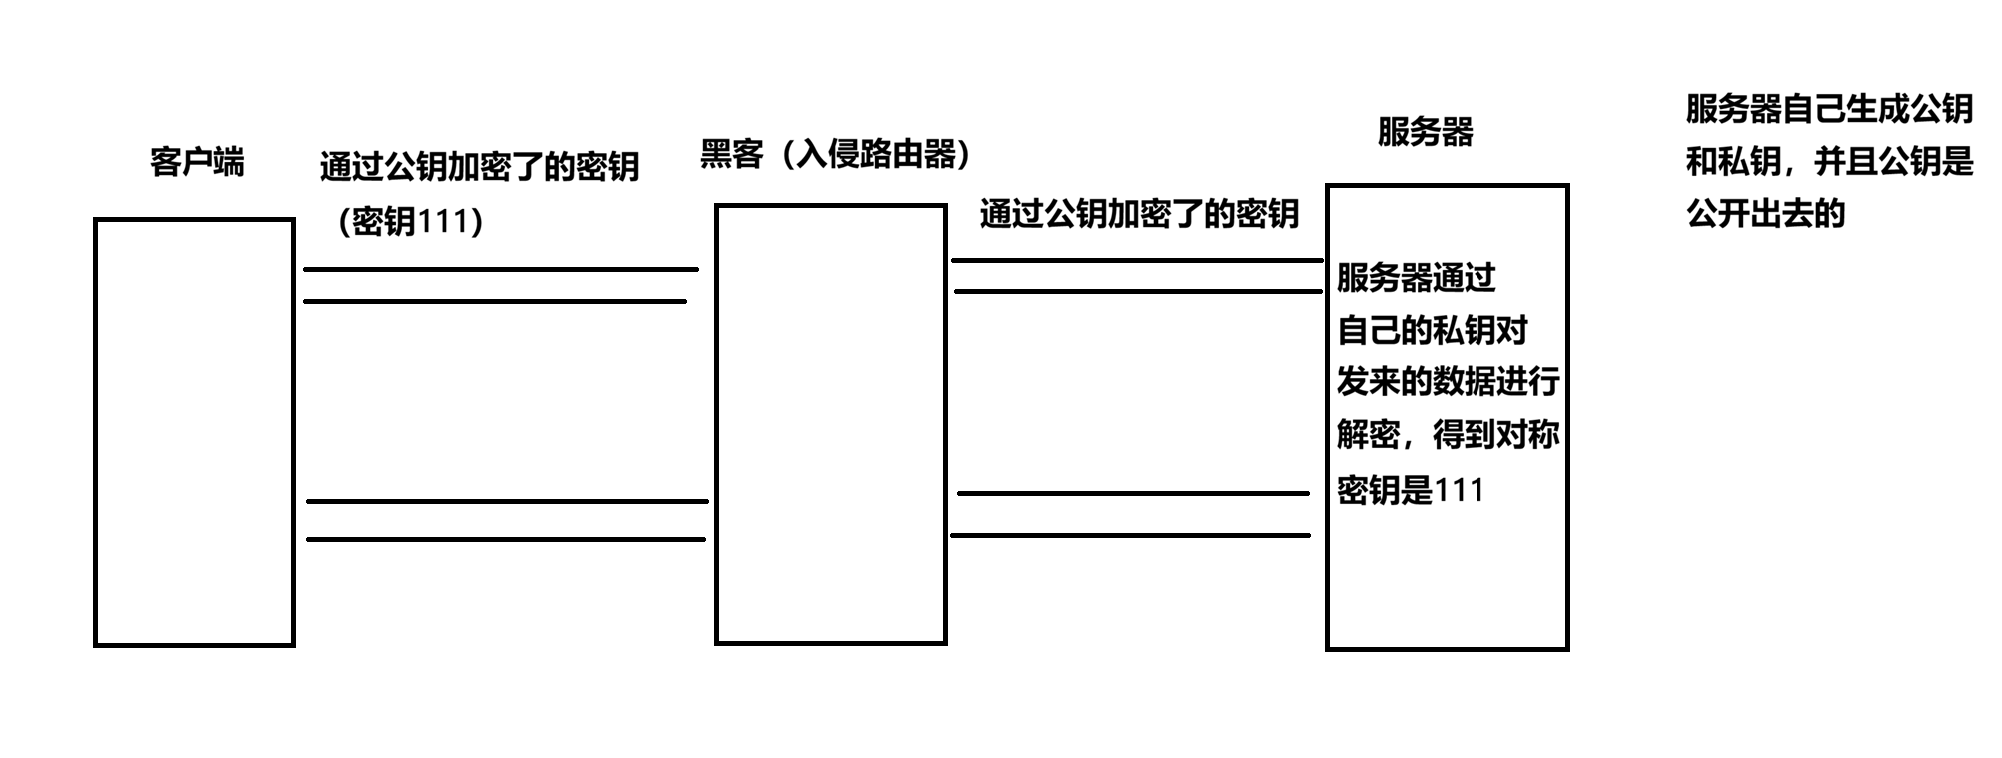
但是这种方式真的是安全的吗,不是的,因为有下面这种情况
由于客户端以及服务器并不知道给他们发消息的是谁,他们不知道这是黑客,所以只能对他们发来的信息选择相信,在黑客拿到客户端的密钥111的时候,为了不打草惊蛇,不引起服务器的怀疑,就拿着服务器的公钥来发送解密后的111,这样在接下来客户端以及服务器都不知情的情况下,双方正常进行通信,殊不知中间有一个黑客
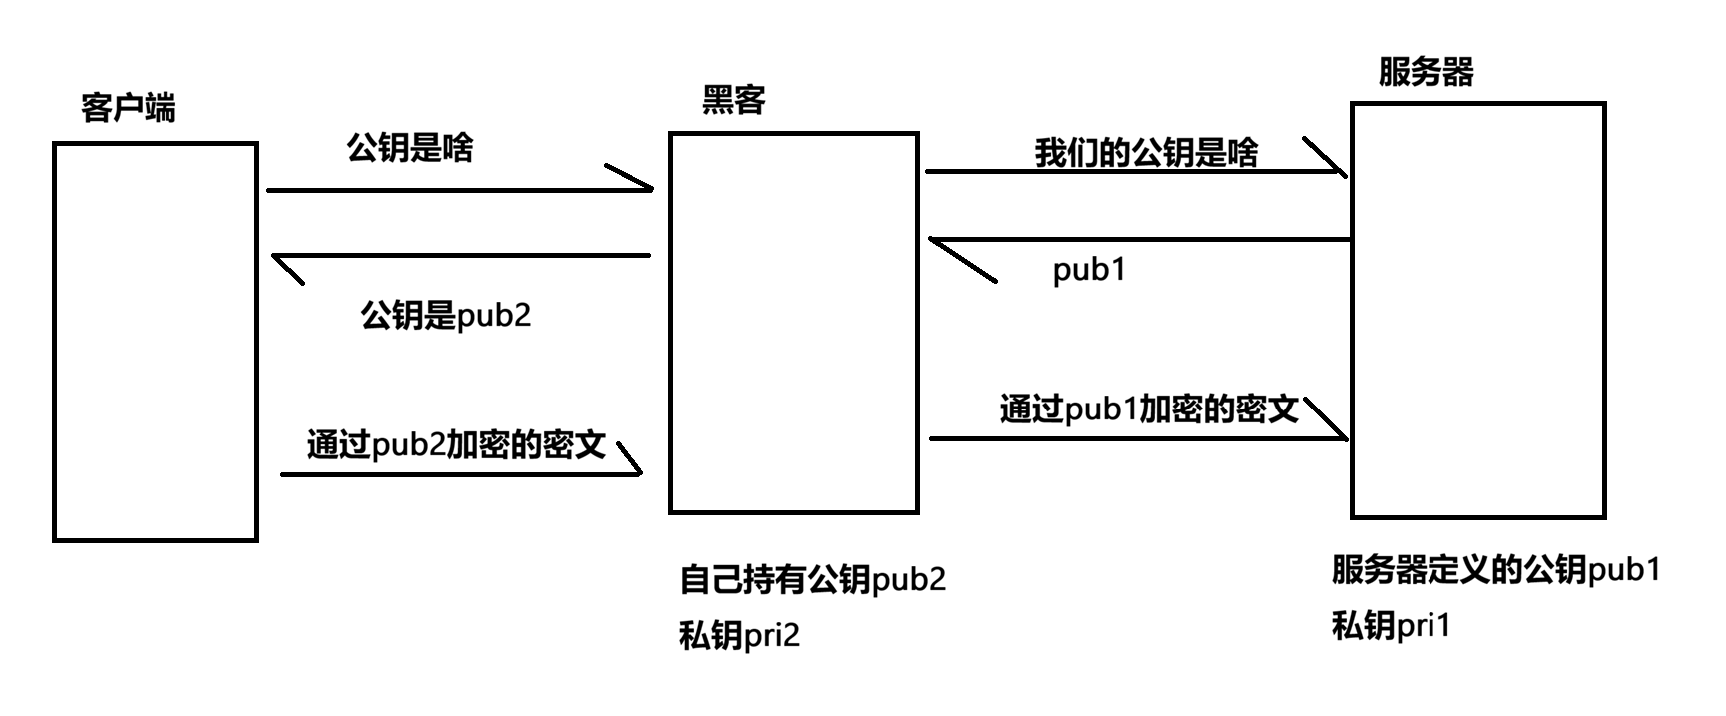
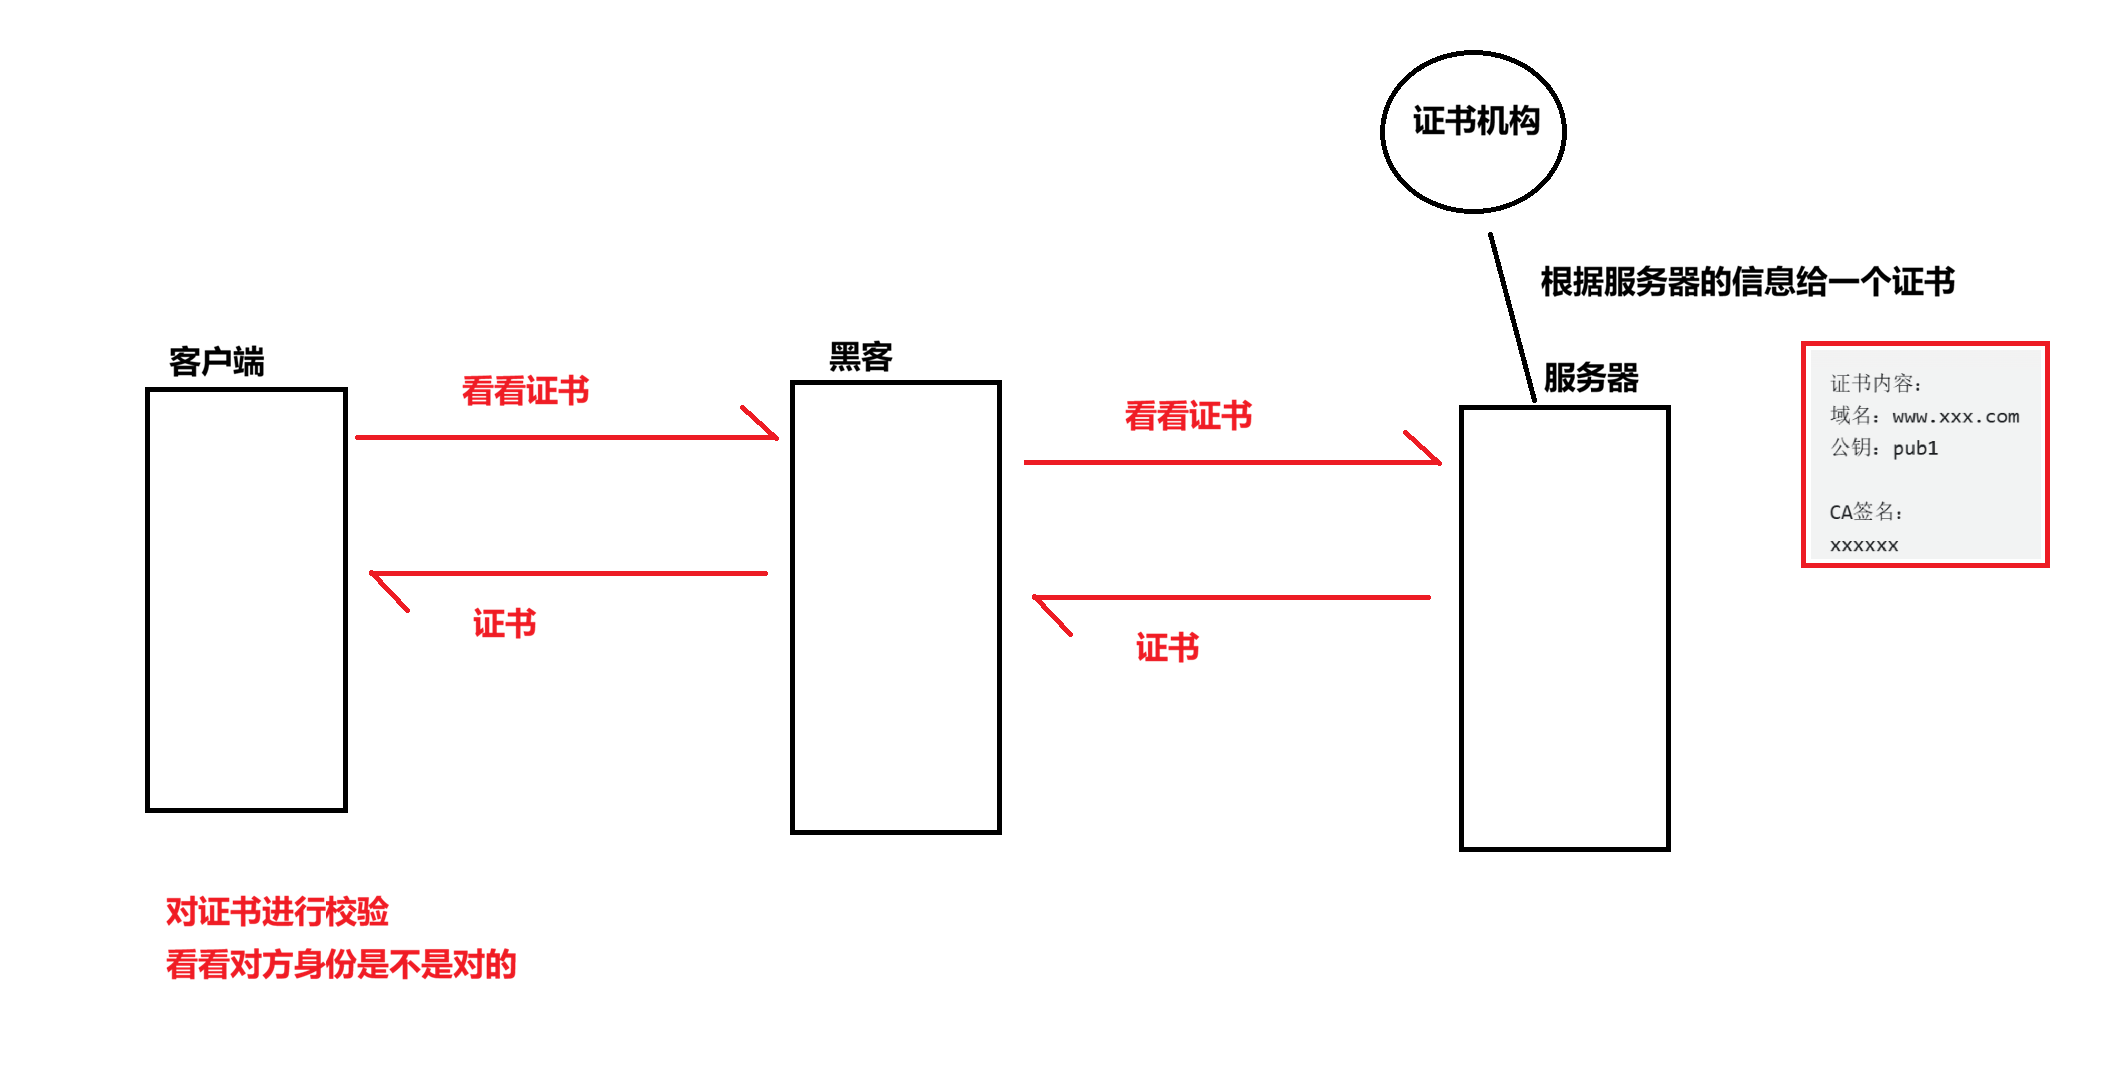
为了应对黑客这样骗两头的情况,我们引入了证书
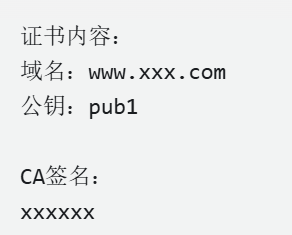
证书机构会通过服务器给的一些资质域名啥的给一个证书,这个证书大致长下面这样,这个公钥是证书机构给的,然后这个签名是基于证书机构的私钥生成的,CA 私钥负责生成签名,CA 公钥可以验证这个签名是不是对应私钥生成的,所以信息由黑客到达客户端并且把公钥给成自己的之后,客户端会进行一个验证,首先会根据证书的内容进行hash,得到一个验证值1,如果根据这个证书机构给的公钥对签名进行一个验证2,如果验证1和验证2是一样的,那么就说明对方是正常的,如果黑客改了pub1,那么就和验证2的结果对不上,那黑客可能就想着把签名也改了,因为第二个验证是拿着公钥计算签名得来的,但是黑客改不了这个签名,因为签名是需要私钥才能生成一个合法的,如果自己编造的不合法的,在公钥计算签名的时候就会直接出错,直接识别黑客
在非对称传输对称密钥之前,我们就会根据这个证书的证明来看对方是不是服务器。
所以说https为什么安全:先用证书确认“你是谁”,再通过非对称密码机制安全协商密钥,最后使用对称加密高效传输 HTTP 数据。(这都是https会干的事情)也就是TLS核心的机制
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/java_nnnn/article/details/165490270