
目录
本文内容概要
本文主要介绍 MySQL 学习过程中需要掌握的基础知识,首先从数据库的基本概念出发,了解为什么需要数据库以及常见的主流数据库;随后介绍 MySQL 服务器、数据库与数据表之间的关系,并从整体上认识 MySQL 的体系架构以及存储引擎;最后介绍 SQL 语句的基本分类,为后续学习数据库与数据表操作、数据增删改查、索引、事务等知识打下基础。
一、数据库基础
1.1 为什么需要数据库
在计算机系统中,数据是非常重要的资源。例如:一个电商系统需要保存用户、商品、订单等数据;一个学校管理系统需要保存学生、课程、成绩等数据。
其中对数据的存储最简单的方式是直接将数据保存到文件中:
student.txt
1 张三 19 计科
2 李四 20 软工
3 王五 21 数媒
当数据量较小时,使用文件保存数据并没有太大的问题。但是,随着数据量不断增加以及应用程序越来越复杂,仅仅依靠普通文件管理数据会变得越来越困难。
- 数据查询困难
- 数据修改和删除困难
- 难以处理大量数据
- 难以处理并发访问
- 难以保证数据安全和可靠性
当数据规模和应用程序复杂度不断增加时,仅仅依靠普通文件已经难以高效、可靠地完成数据的存储、查询、修改和管理,因此需要专门的数据库系统来统一管理数据。
1.2 什么是数据库
数据库(Database, DB):一种按照一定规则组织、存储和管理数据的集合。
例如:
学校需要记录学生:张三、李四、王五的基本信息:
张三 19岁 计科
李四 20岁 软工
王五 21岁 数媒
在没有数据库的情况下,程序员可以通过 C/C++ 等高级语言来对文件进行读写,将学生信息保存到文件中。
对于文件的写入操作是很容易的,但是,如果希望程序能够准确地读取并解析每一条学生记录,就需要约定数据的组织格式。例如:
[姓名长度][姓名][年龄][专业长度][专业]程序按照约定好的格式对数据进行序列化和反序列化,才能正确地保存和读取数据。
而数据库提供一种功能:把数据按照一定的结构进行组织并提供相关接口,方便程序员对数据进行保存、获取、查询等功能。
| ID | 姓名 | 年龄 | 专业 |
| 1 | 张三 | 19 | 计科 |
| 2 | 李四 | 20 | 软工 |
| 3 | 王五 | 21 | 数媒 |
1.3 主流数据库
| 类型 | 主流数据库 | 特点 |
|---|---|---|
| 关系型数据库 | MySQL | 开源、应用广泛,Web/后端开发常见 |
| PostgreSQL | 功能强、SQL 标准支持较好、扩展能力强 | |
| Oracle Database | 商业数据库,大型企业场景常见 | |
| Microsoft SQL Server | 微软生态中常见 | |
| SQLite | 轻量、嵌入式、无需独立服务器 | |
| 键值数据库 | Redis | 内存数据库,常用于缓存、排行榜、分布式锁等 |
| 文档数据库 | MongoDB | 以文档形式存储数据,模式相对灵活 |
| 分布式/宽列数据库 | Apache Cassandra、HBase | 面向大规模分布式数据场景 |
| 搜索/分析引擎 | Elasticsearch | 全文搜索、日志检索与分析常见 |
二、MySQL 数据库基本理解
2.1 连接服务器
mysql -h 127.0.0.1 -P 3306 -u root -p-h:MySQL 服务端程序的 IP 地址
-P:MySQL 服务端程序绑定的 Port 端口号
-u:以某种身份连接 MySQL 服务端
-p:登录的密码
注意:如果没有带 -h 选项,默认采用 127.0.0.1 本地环回地址
如果没有带 -P 选项,默认采用 3306 端口号
2.2 MySQL 服务器、数据库、数据表的关系
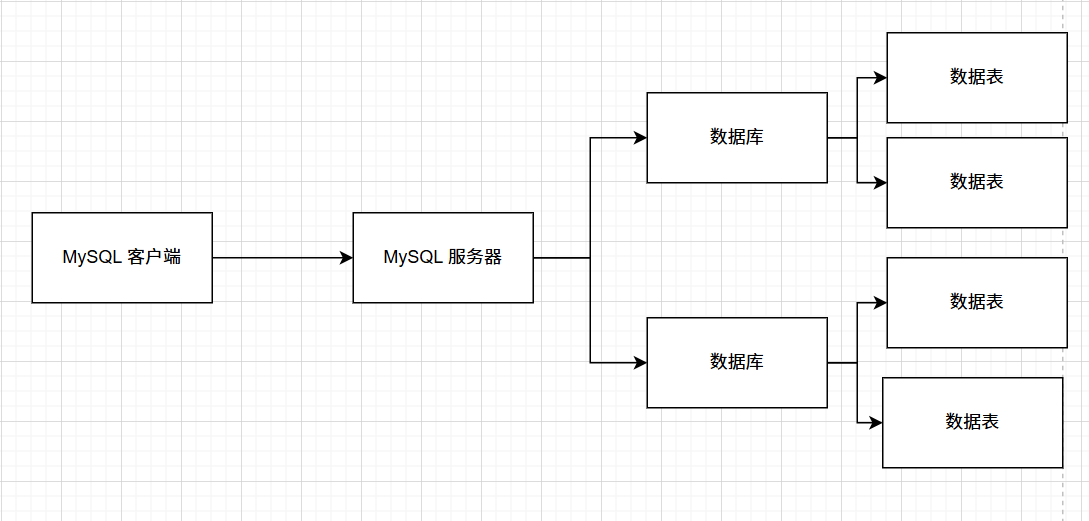
我们在命令行使用的 mysql 是 MySQL 提供的客户端,它用来连接 MySQL 服务器,而数据库和数据表的管理,均有 MySQL 服务器来管理。mysql 客户端下达对应的 SQL 语句,MySQL 解析得到后进行对数据库、数据表进行相关操作。
2.3 MySQL 的整体架构
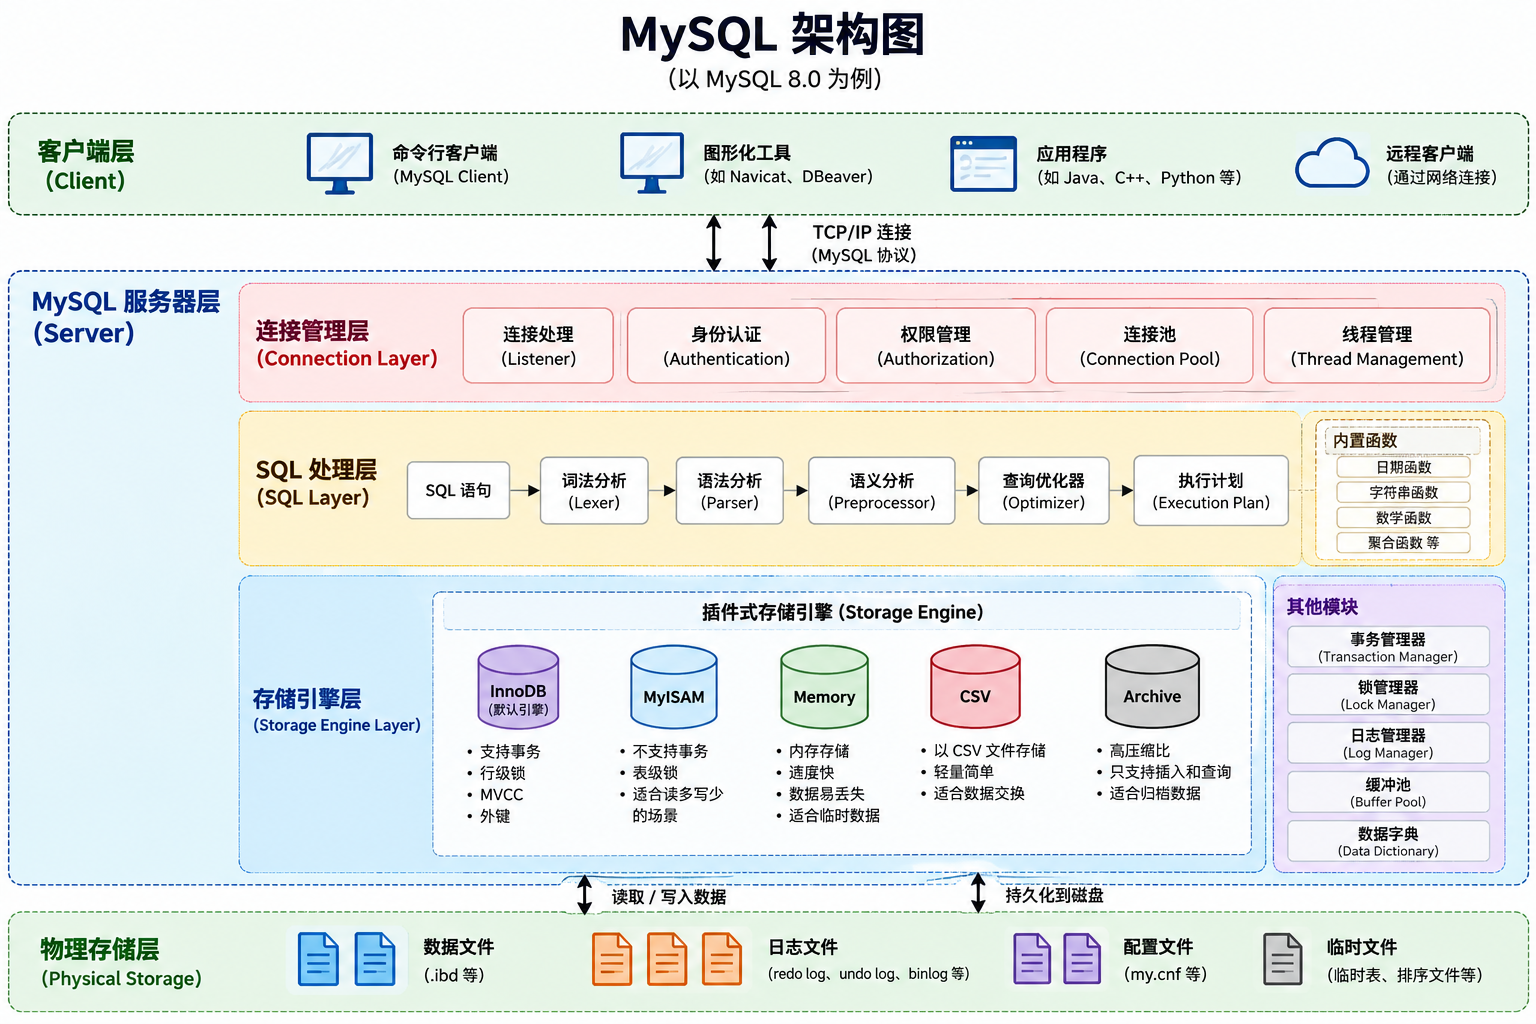
理解:一条 SQL 语句是如何被 MySQL 接收、处理,并最终完成数据读写的。
MySQL 的架构可以划分为 客户端层、MySQL Server 层、存储引擎层以及物理存储层。
2.3.1 客户端层
客户端层是用户与 MySQL Server 进行交互的入口。
我们平时使用的 MySQL 命令行客户端、Navicat、DBeaver,以及通过 C++、Java、Python 等语言编写的应用程序,本质上都属于 MySQL 的客户端。
客户端首先需要与 MySQL Server 建立连接,连接成功后便可以向服务器发送 SQL 请求,MySQL Server 接收到请求后,会对 SQL 语句进行进一步处理。
2.3.2 MySQL Server 层
MySQL Server 层是整个 MySQL 架构中非常重要的一部分,主要负责连接管理以及 SQL 语句的解析、优化和执行。
当客户端尝试连接 MySQL 时,服务器首先需要处理连接请求,并完成用户身份认证、权限检查等工作。
连接建立以后,客户端发送的 SQL 语句便会进入 SQL 处理流程。这个过程可以简单概括为:
SQL 语句 → 解析 → 优化 → 生成执行计划 → 执行
首先,MySQL 会对 SQL 语句进行词法、语法等方面的分析,判断 SQL 是否符合基本语法规则,并确定语句需要完成的操作。
随后,查询优化器会根据表结构、索引、统计信息等内容,为 SQL 选择一个成本相对较低的执行方案。
在基础学习阶段,我们只需要理解 Server 层负责理解 SQL 并决定如何执行 SQL 即可,具体的优化器原理可以在后续 SQL 优化部分继续学习。
2.3.3 存储引擎层
经过 Server 层处理以后,真正的数据读取和写入工作还需要交给存储引擎完成。
存储引擎可以理解为 MySQL 中真正负责 组织、存储和访问数据 的模块。
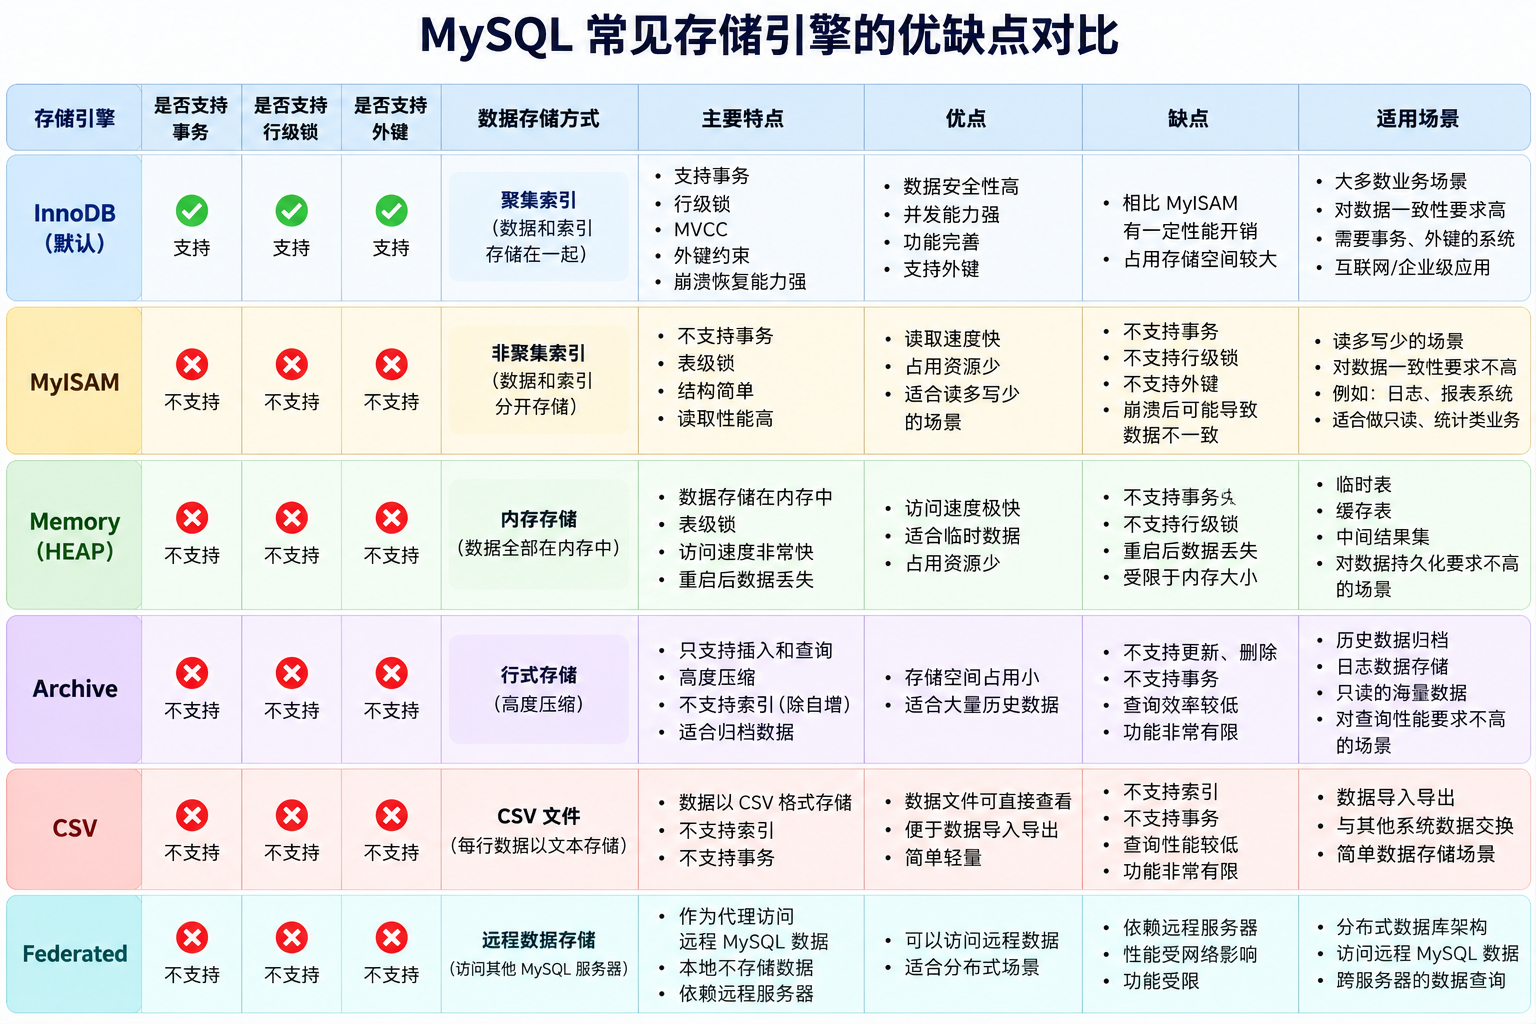
MySQL 支持多种存储引擎,例如 InnoDB、MyISAM、Memory 等,不同存储引擎具有不同的特点。
其中 InnoDB 是目前 MySQL 默认并且最常用的存储引擎,支持事务、行级锁、MVCC、外键等重要功能。因此后续学习 MySQL 的事务、锁、MVCC、索引以及数据持久化等内容时,通常都会重点围绕 InnoDB 展开。
可以通过下面的 SQL 查看当前 MySQL 支持的存储引擎:
SHOW ENGINES;2.3.4 物理存储层
最终,数据还需要真正保存到磁盘中,这便涉及 MySQL 的物理存储。
例如 InnoDB 中的数据和索引可以存储在 .ibd 等文件中,MySQL 在运行过程中还会涉及各种日志和配置文件。
因此,从整体角度来看,一条 SQL 语句的执行过程可以简单概括为:
客户端发送 SQL → MySQL Server 接收并解析 SQL → 优化器选择执行方案 → 调用存储引擎 → 存储引擎完成数据读写 → 数据最终保存到物理存储中。
需要注意的是,这里介绍的只是 MySQL 的宏观架构。实际上 InnoDB 内部还包含 Buffer Pool、锁、事务、redo log、undo log 等大量重要机制,这些内容将在后续学习 MySQL 原理时进一步展开。
通过这一架构,我们目前只需要建立一个基本认识:
Server 层主要负责 SQL 的处理与执行控制,而存储引擎主要负责数据真正的存储和访问。
理解这个分层关系以后,再学习索引、事务、锁以及 InnoDB 等内容时,就能够更加清楚这些机制分别处于 MySQL 的哪个位置,以及它们解决了什么问题。
2.4 MySQL的存储引擎
2.5 SQL语句的分类
SQL(Structured Query Language,结构化查询语言)是用于操作和管理关系型数据库的语言。根据 SQL 语句所完成的功能,可以将其划分为以下几类:
| 分类 | 全称 | 作用 | 常见关键字 |
|---|---|---|---|
| DDL | Data Definition Language | 数据定义语言,用于定义和管理数据库对象 | CREATE、ALTER、DROP |
| DML | Data Manipulation Language | 数据操作语言,用于对表中的数据进行增、删、改 | INSERT、UPDATE、DELETE |
| DQL | Data Query Language | 数据查询语言,用于查询数据库中的数据 | SELECT |
| DCL | Data Control Language | 数据控制语言,用于管理用户以及访问权限 | GRANT、REVOKE |
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/Felix_kiss_L/article/details/165355062