
参考:Andrew Koenig《C 陷阱与缺陷(第二版)》1.3节
目录
符号分两类
书里先给符号分了类:
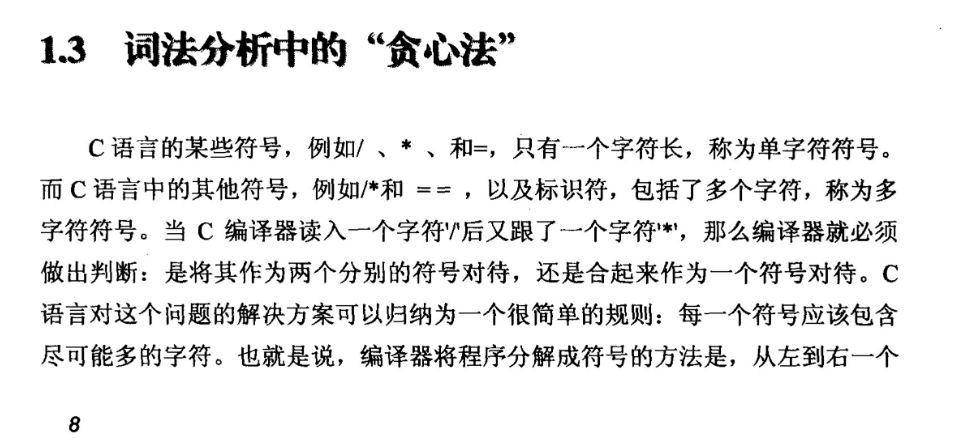
C 语言的某些符号,例如
/、*、+、=,只有一个字符长,称为单字符符号。而 C 语言中的其他符号,例如/*和==,以及标识符,包括了多个字符,称为多字符符号。
单字符符号没有歧义,一眼就能认出来。麻烦全在多字符符号上:
当 C 编译器读入一个字符
/后又跟了一个字符*,那么编译器就必须做出判断:是将其作为两个分别的符号对待,还是合起来作为一个符号对待。
/ 后面跟 *——它到底是“除号 + 解引用”,还是“注释开头”?
同一个字符序列,两种完全不同的读法。
C 语言的某些符号,例如
/、*、+、=,只有一个字符长,称为单字符符号。而 C 语言中的其他符号,例如/*和==,以及
标识符,包括了多个字符,称为多字符符号。
单字符符号没有歧义,一看就是一个。麻烦全在多字符符号上:
当 C 编译器读入一个字符
/后又跟了一个字符*,那么编译器就必须做出判断:是将其作为两个分别的符号对待,还是合起来作为一个符号对待。
/ 后面跟 *——它到底是"除号 + 解引用",还是"注释开头"?
同一个字符序列,两种完全不同的读法。
规则
C 语言对这个问题的解决方案可以归纳为一个很简单的规则:每一个符号应该包含尽可能多的字符。
书里紧接着给了完整过程:
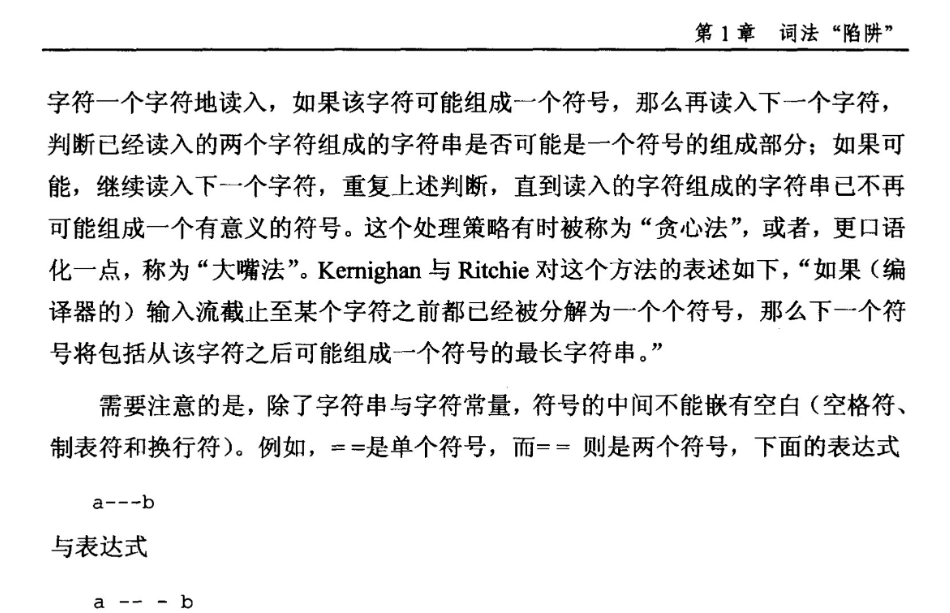
字符一个字符地读入,如果该字符可能组成一个符号,那么再读入下一个字符,判断已经读入的两个字符组成的字符串是否可能是一个符号的组成部分;
如果可能,继续读入下一个字符,重复上述判断,直到读入的字符组成的字符串已不再可能组成一个有意义的符号。
这个处理策略有时被称为"贪心法",或者,更口语化一点,称为"大嘴法"。
贪心法这个名字还好理解一点,这个大嘴法是怎么叫出来的?
大嘴法 = 嘴张到最大,能吞多少就吞多少,吞不下才吐。
词法分析器面对一串字符,规则只有一条:从当前位置开始,尽可能多地吃字符,直到再多吃一个就"不成词"为止,然后退回上一个成词的状态,把嘴里那段吐出来当一个符号。
同一段里,作者还引了 Kernighan 与 Ritchie (C语言的共同奠基人)的原文表述——
这是这本书里少见的"请出祖师爷":
如果(编译器的)输入流截止至某个字符之前都已经被分解为一个个符号,那么下一个符号将包括从该字符之后可能组成一个符号的最长字符串。
最长字符,这件事就讲完了。下面看两个例子
a---b
书里的原话很干脆:
例如,
==是单个符号,而= =则是两个符号,下面的表达式a---b与表达式a -- - b的含义相同,而与a - -- b的含义不同。
按贪心法,a---b 是这样被一点点吃掉的:
a---b
  │
  ├─ 读到 a      → 标识符从这里开始
  ├─ 下一个是 -  → 标识符不能含 '-',所以 a 到此为止,切出符号 a
  ├─ 读到 -      → 再看下一个,也是 -,'--' 是合法符号(自减),继续吃
  ├─ 再看下一个  → 是 -,'---' 不是合法符号,退回,只吃 '--'
  └─ 剩下        → - b
结果:(a--) - b
实测
#include <stdio.h>

int main()
{
	int a = 10;
	int b = 20;
	int c = a--- b;
	printf("%d %d", a, b);
	return 0;
}
#include <stdio.h>
int main()
{
int a = 10;
int b = 20;
int c = a- --b;
printf("%d %d", a, b);
return 0;
}两行的差值一模一样,但减的是不同的东西:第一段减了 a,第二段减了 b。
a、b 的变化是关键——只有它们显示了编译器到底切了哪个符号。
y = x/*p
接下来这个例子更直接。
同样地,如果
/是为判断下一个符号而读入的第一个字符,而/之后紧接着*,那么无论上下文如何,这两个字符都将被当作一个符号/*,表示一段注释的开始。
无论上下文如何——这五个字是关键。词法分析器不看语义,它只看字符。
书里给的代码,本意是"用 x 除以 p 所指向的值":
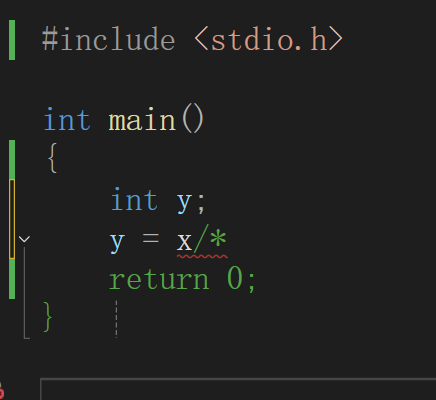
y = x/*p /* p 指向除数 */;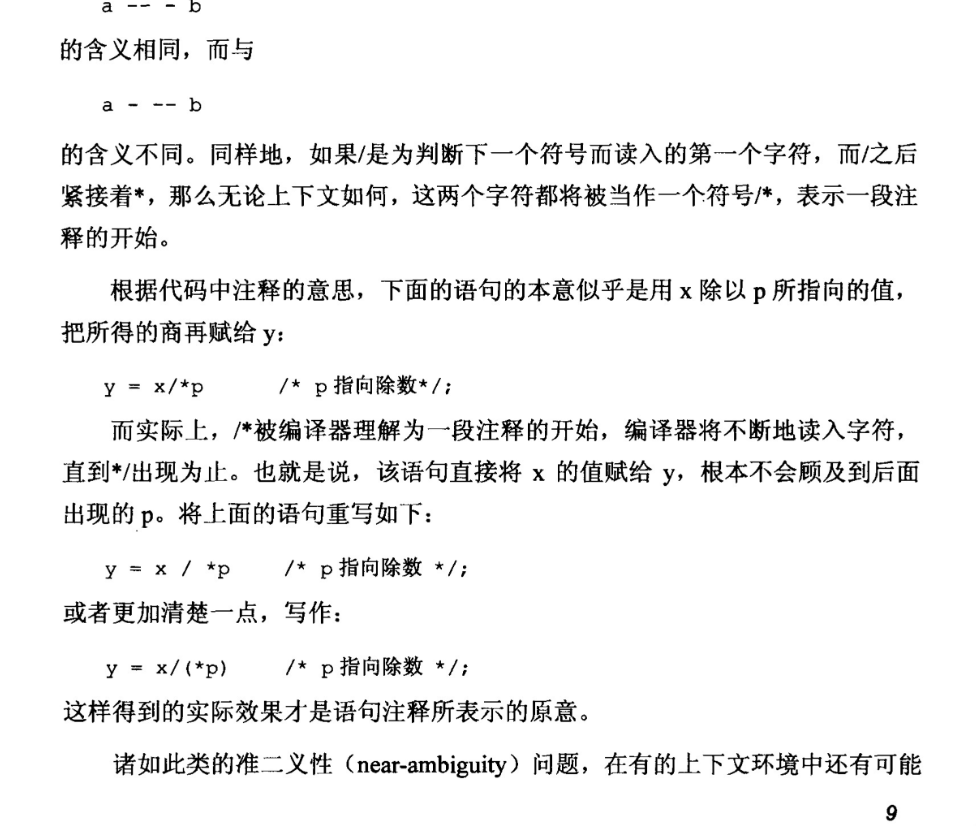
书里的判词:
而实际上,
/*被编译器理解为一段注释的开始,编译器将不断地读入字符,直到*/出现为止。也就是说,该语句直接将 x 的值赋给 y,根本不会顾及到后面出现的 p。
书里给了两种修法:
y = x / *p    /* p 指向除数 */;
y = x/(*p)    /* p 指向除数 */;
符号中间不能嵌空白
同页还有一句容易漏掉的规则:
除了字符串与字符常量,符号的中间不能嵌有空白(空格符、制表符和换行符)。
也就是说 == 是一个符号,而 = = 是两个符号。
这对复合赋值运算符影响最大——+=、-=、>>= 必须连写,中间加一个空格就不再是那个符号了。
这条规则的历史
书里最后半页讲了个有意思的历史。
老版本 C 语言里,=+ 就是现在的 +=:
这种老版本的 C 编译器会将
a=-1;理解为下面的语句
a =- 1;亦即
a = a - 1;因此,如果程序员的原意是
a = -1;,那么所得结果将使其大吃一惊。
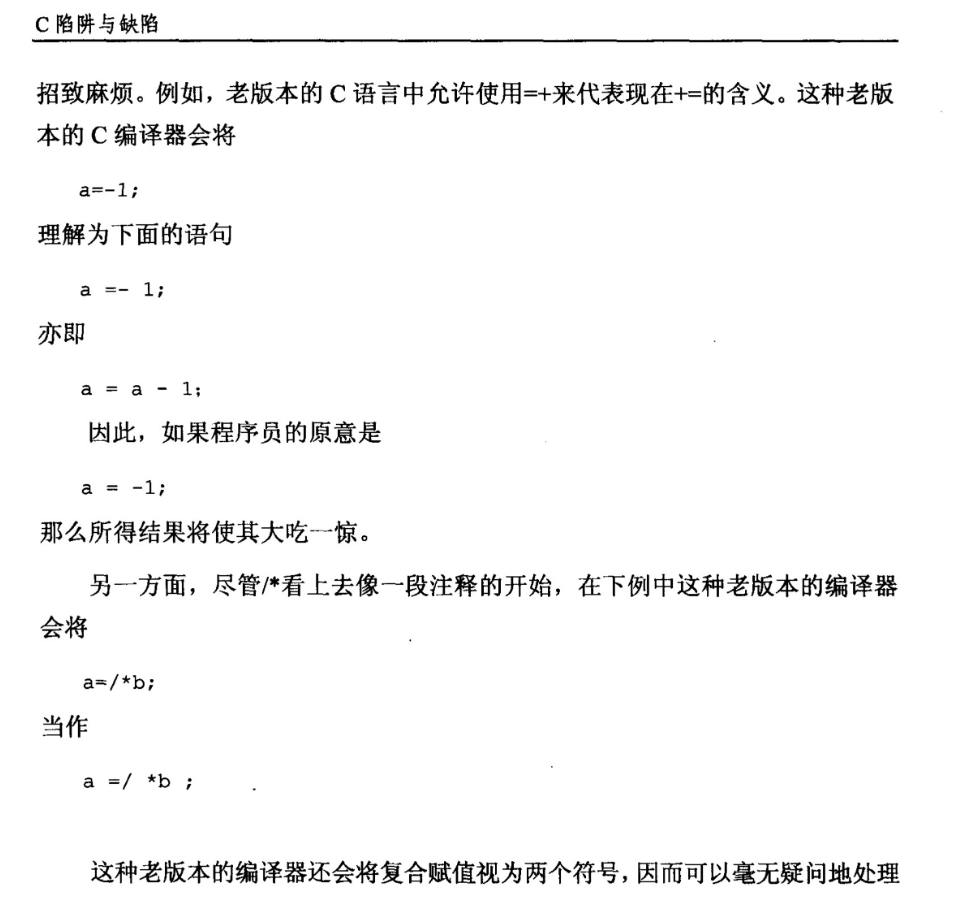
同一段里还有一个如今已经不可能复现的例子:
另一方面,尽管
/*看上去像一段注释的开始,在下例中这种老版本的编译器会将a=/*b;当作a =/ *b ;这种老版本的编译器还会将复合赋值视为两个符号,因而可以毫无疑问地处理
a >> = 1;,而一个严格的 ANSI C 编译器则会报错。
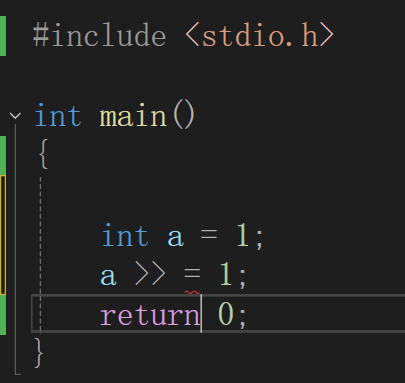
也就是说,老编译器把 >>= 看成 >> 和 = 两个符号,所以 a >> = 1 中间有空格也能过;
而今天的编译器按贪心法处理,>> 后遇到空格就断了,于是报错。
表格
| 写下的 | 编译器切出的 | 说明 |
|
|
| 贪心吃到 |
|
|
| 空格切断了贪心 |
|
|
|
|
|
| 除法 + 解引用 | 空格救回来 |
|
| 两个符号 | 符号中间不能嵌空白 |
|
| 一个符号 | 今天的编译器只认这个 |
词法分析器不看编译者想要什么,只看"再多读一个字符还能不能构成合法符号"。
转载自 CSDN-专业IT技术社区