
Kafka入门详解:核心特点与基础核心概念(通俗易懂版)
📚 专栏分类:中间件 | Kafka | 后端架构
💡 适用人群:初学Kafka、面试复习、后端开发
✨ 文章简介:本文从零讲解Kafka核心特性、基础核心概念,摒弃晦涩官方话术,结合实战场景通俗解读,新手可快速入门,同时适配面试高频考点,适合收藏学习、面试复盘。
一、Kafka 整体介绍
Kafka 是 LinkedIn 公司开源的一款分布式、基于发布/订阅模式的消息中间件,后续捐赠给 Apache 基金会,成为 Apache 顶级开源项目。
凭借超高吞吐量、低延迟、持久化存储、分布式可扩展的特性,Kafka 目前广泛应用于实时数据流处理、日志收集、系统解耦、流量削峰、大数据ETL等场景,是互联网后端、大数据领域的核心中间件之一。
二、Kafka 五大核心特点
1. 超高吞吐性能,支持海量消息收发
Kafka 核心设计目标是实现常数时间复杂度 O(1)的消息持久化与访问能力,即便面对 TB 级海量数据,依然能保持稳定的读写性能,不会随数据量增长出现性能衰减。
硬件适配性极强,普通商用服务器即可实现单机每秒 10W+ 消息的传输能力,完全满足高并发业务场景的流量需求,这也是 Kafka 碾压传统消息队列的核心优势之一。
2. 消息持久化存储,数据安全可靠
不同于部分内存型消息队列,Kafka 会将所有消息持久化落地到磁盘,而非仅存在内存中,彻底避免服务重启、宕机导致的消息丢失问题。
同时支持副本复制(Replication)机制,通过多副本冗余存储进一步保障数据可靠性。基于持久化特性,Kafka 既支持实时消息消费,也适配离线批量消费、大数据 ETL 数据同步等场景。
3. 分布式架构,支持水平无限扩容
Kafka 是天然的分布式消息系统,集群由多个 Broker 节点组成,支持消息分区存储、分布式消费。
核心特性:多分区并行处理、分区内消息有序。所有核心组件(生产者 Producer、服务端 Broker、消费者 Consumer)均支持集群部署,可根据业务流量动态横向扩容,且扩容过程无需停机、不影响业务,可用性极高。
4. 消费者 Pull 拉取模式,服务端无状态
Kafka 采用消费者主动拉取(Pull)的消费模式,区别于传统服务端推送(Push)模式。
Broker 服务端不维护消费者消费状态,属于无状态服务;消息消费的偏移量(Offset)由消费者端自主维护。该设计极大降低了 Broker 的性能压力,同时消费者可自主控制拉取频率、批量大小,有效避免消费者被大流量压垮。
5. 兼顾实时与离线,场景适配性极强
Kafka 一套架构可同时支撑在线实时数据处理和离线批量数据处理。实时场景可用于业务消息推送、日志实时分析;离线场景可对接大数据平台,实现数据同步、批量统计分析,是流批一体的经典中间件选型。
三、Kafka 核心基础概念(图解配套)
为方便大家理解,下文所有概念均搭配经典架构图解逻辑,文末附完整架构图说明,新手可对照图形快速吃透核心组件关系。
1. Broker(服务节点)
Kafka 集群中的每一台服务器节点,都称之为 Broker。
一个完整的 Kafka 集群由多个 Broker 组成,Broker 负责接收生产者发送的消息、持久化存储消息、响应消费者的拉取请求,是 Kafka 数据存储和交互的核心服务节点。
2. Topic(主题)
Topic 是 Kafka 中消息的分类/载体,所有发送到 Kafka 的消息,都必须归属一个指定的 Topic。
核心特性:
-
物理隔离:不同 Topic 的消息在磁盘上分开存储,互不干扰
-
逻辑统一:一个 Topic 的消息可分散存储在多个 Broker 节点上,使用者无需关心数据物理存储位置,只需指定 Topic 即可生产/消费消息
简单理解:Topic 就是消息的文件夹,用来区分不同业务的数据流,例如订单消息、日志消息、用户行为消息可分为不同 Topic。
3. Partition(分区)
Partition 是 Topic 的物理拆分单元,是 Kafka 实现高吞吐、并行处理的核心。
一个 Topic 可以拆分为一个或多个 Partition,每个 Partition 都是一个有序的消息队列,底层基于磁盘顺序日志文件存储。
核心要点:
-
Partition 内的消息严格有序,每条消息拥有唯一的有序偏移量 Offset
-
不同 Partition 之间消息无序
-
分区越多,并行读写能力越强,集群吞吐越高
通俗理解:Topic 是大文件夹,Partition 就是文件夹下的多个有序文件,用来拆分海量数据流,实现并行处理。
4. Producer(生产者)
Kafka 消息的发送端,是负责向指定 Topic 推送消息数据的客户端。
生产者可根据分区策略,将消息分发到 Topic 的不同 Partition 中,支持批量发送、消息压缩、异步发送等优化策略,保障高并发写入性能。
5. Consumer(消费者)
Kafka 消息的接收端,是负责从指定 Topic 拉取消息、处理业务逻辑的客户端。
消费者主动向 Broker 发起拉取请求,根据维护的 Offset 定位消费位置,逐条或批量处理消息,支持断线重连、断点续消费。
6. Consumer Group(消费者组)
消费者组是 Kafka 实现消息单播、广播的核心机制,也是实现消费并行度扩容的关键。
每一个 Consumer 都必须归属一个 Consumer Group,未指定组名时默认归属默认组。同一个 Topic 可以被多个消费者组消费,组之间相互独立、互不影响。
核心消费模型(面试高频):
-
单播(负载均衡消费):多个消费者属于同一个消费组,一条消息只会被组内任意一个消费者消费,实现消费负载均衡,提升消费并行度
-
广播(全量消费):多个消费者属于不同消费组,Topic 的消息会同步分发到所有消费组,每个组的消费者都能消费到全量消息
核心优势:无需创建多个 Topic,仅通过消费者组配置,即可灵活实现单播/广播两种消费模式,极大简化业务架构。
四、配套图解说明(可直接复制配图)
图1:Kafka 整体架构图
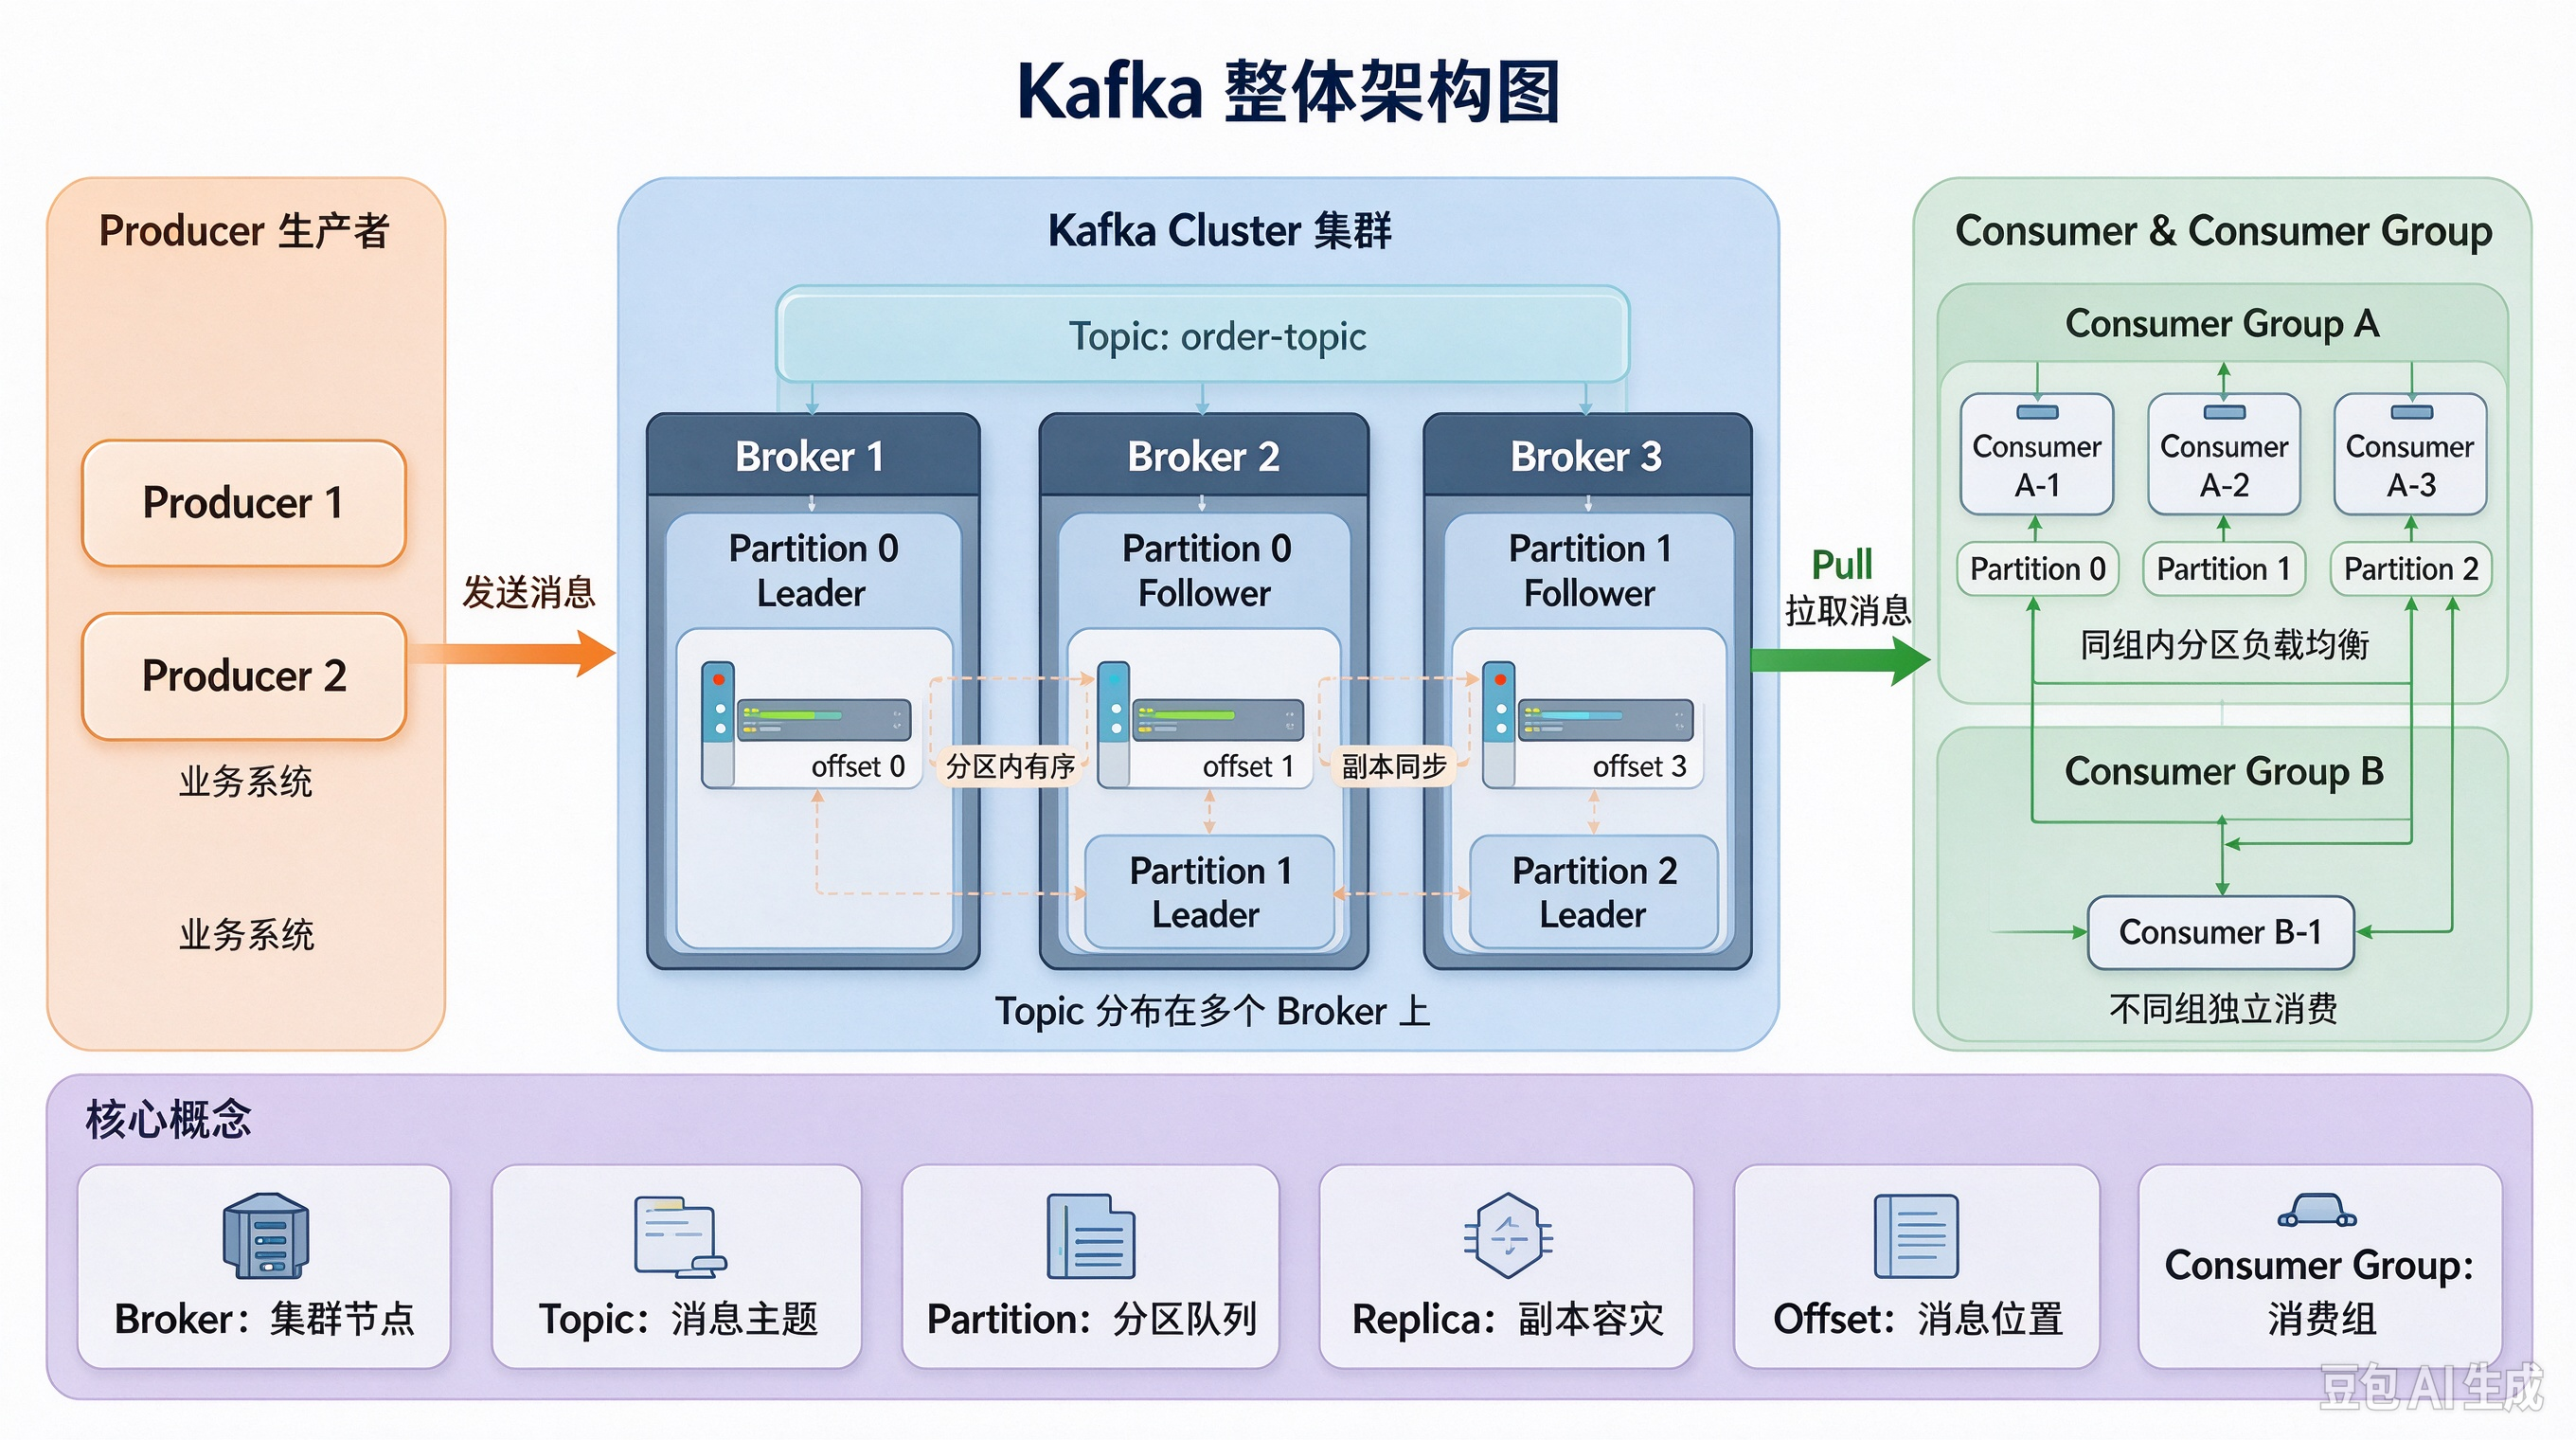
Kafka 整体消息流转分为:生产者发送消息 → 集群分区存储 → 消费者拉取消费三大流程,全程基于发布订阅模式工作。
1. 生产者发送消息
生产者(Producer)负责产生业务消息,并将消息发送到 Kafka 集群指定的 Topic(主题)。
生产者不会直接指定 Broker 节点,而是根据分区策略将消息分发到 Topic 的不同 Partition(分区)中。同一分区消息有序,不同分区并行写入,极大提升吞吐量。
2. Broker 集群存储消息
Kafka 集群由多个 Broker 节点组成,Topic 的分区会分散存储在不同 Broker 上。
每个 Partition 分为 Leader 副本和 Follower 副本:
-
Leader:负责处理所有读写请求
-
Follower:被动同步数据,用于故障容灾
消息以磁盘顺序追加方式持久化保存,每条消息拥有唯一 Offset(偏移量),作为消息的唯一坐标。
3. 消费者拉取消费消息
Kafka 采用经典的 Pull 拉取模式,消费者主动从 Broker 拉取数据,而非服务端推送。
消费者自己维护 Offset 偏移量,记录消费位置,实现断点续消费、重复消费、回溯消费。Broker 无状态,压力极小,支撑高并发消费场景。
图2:消费者组单播/广播原理图
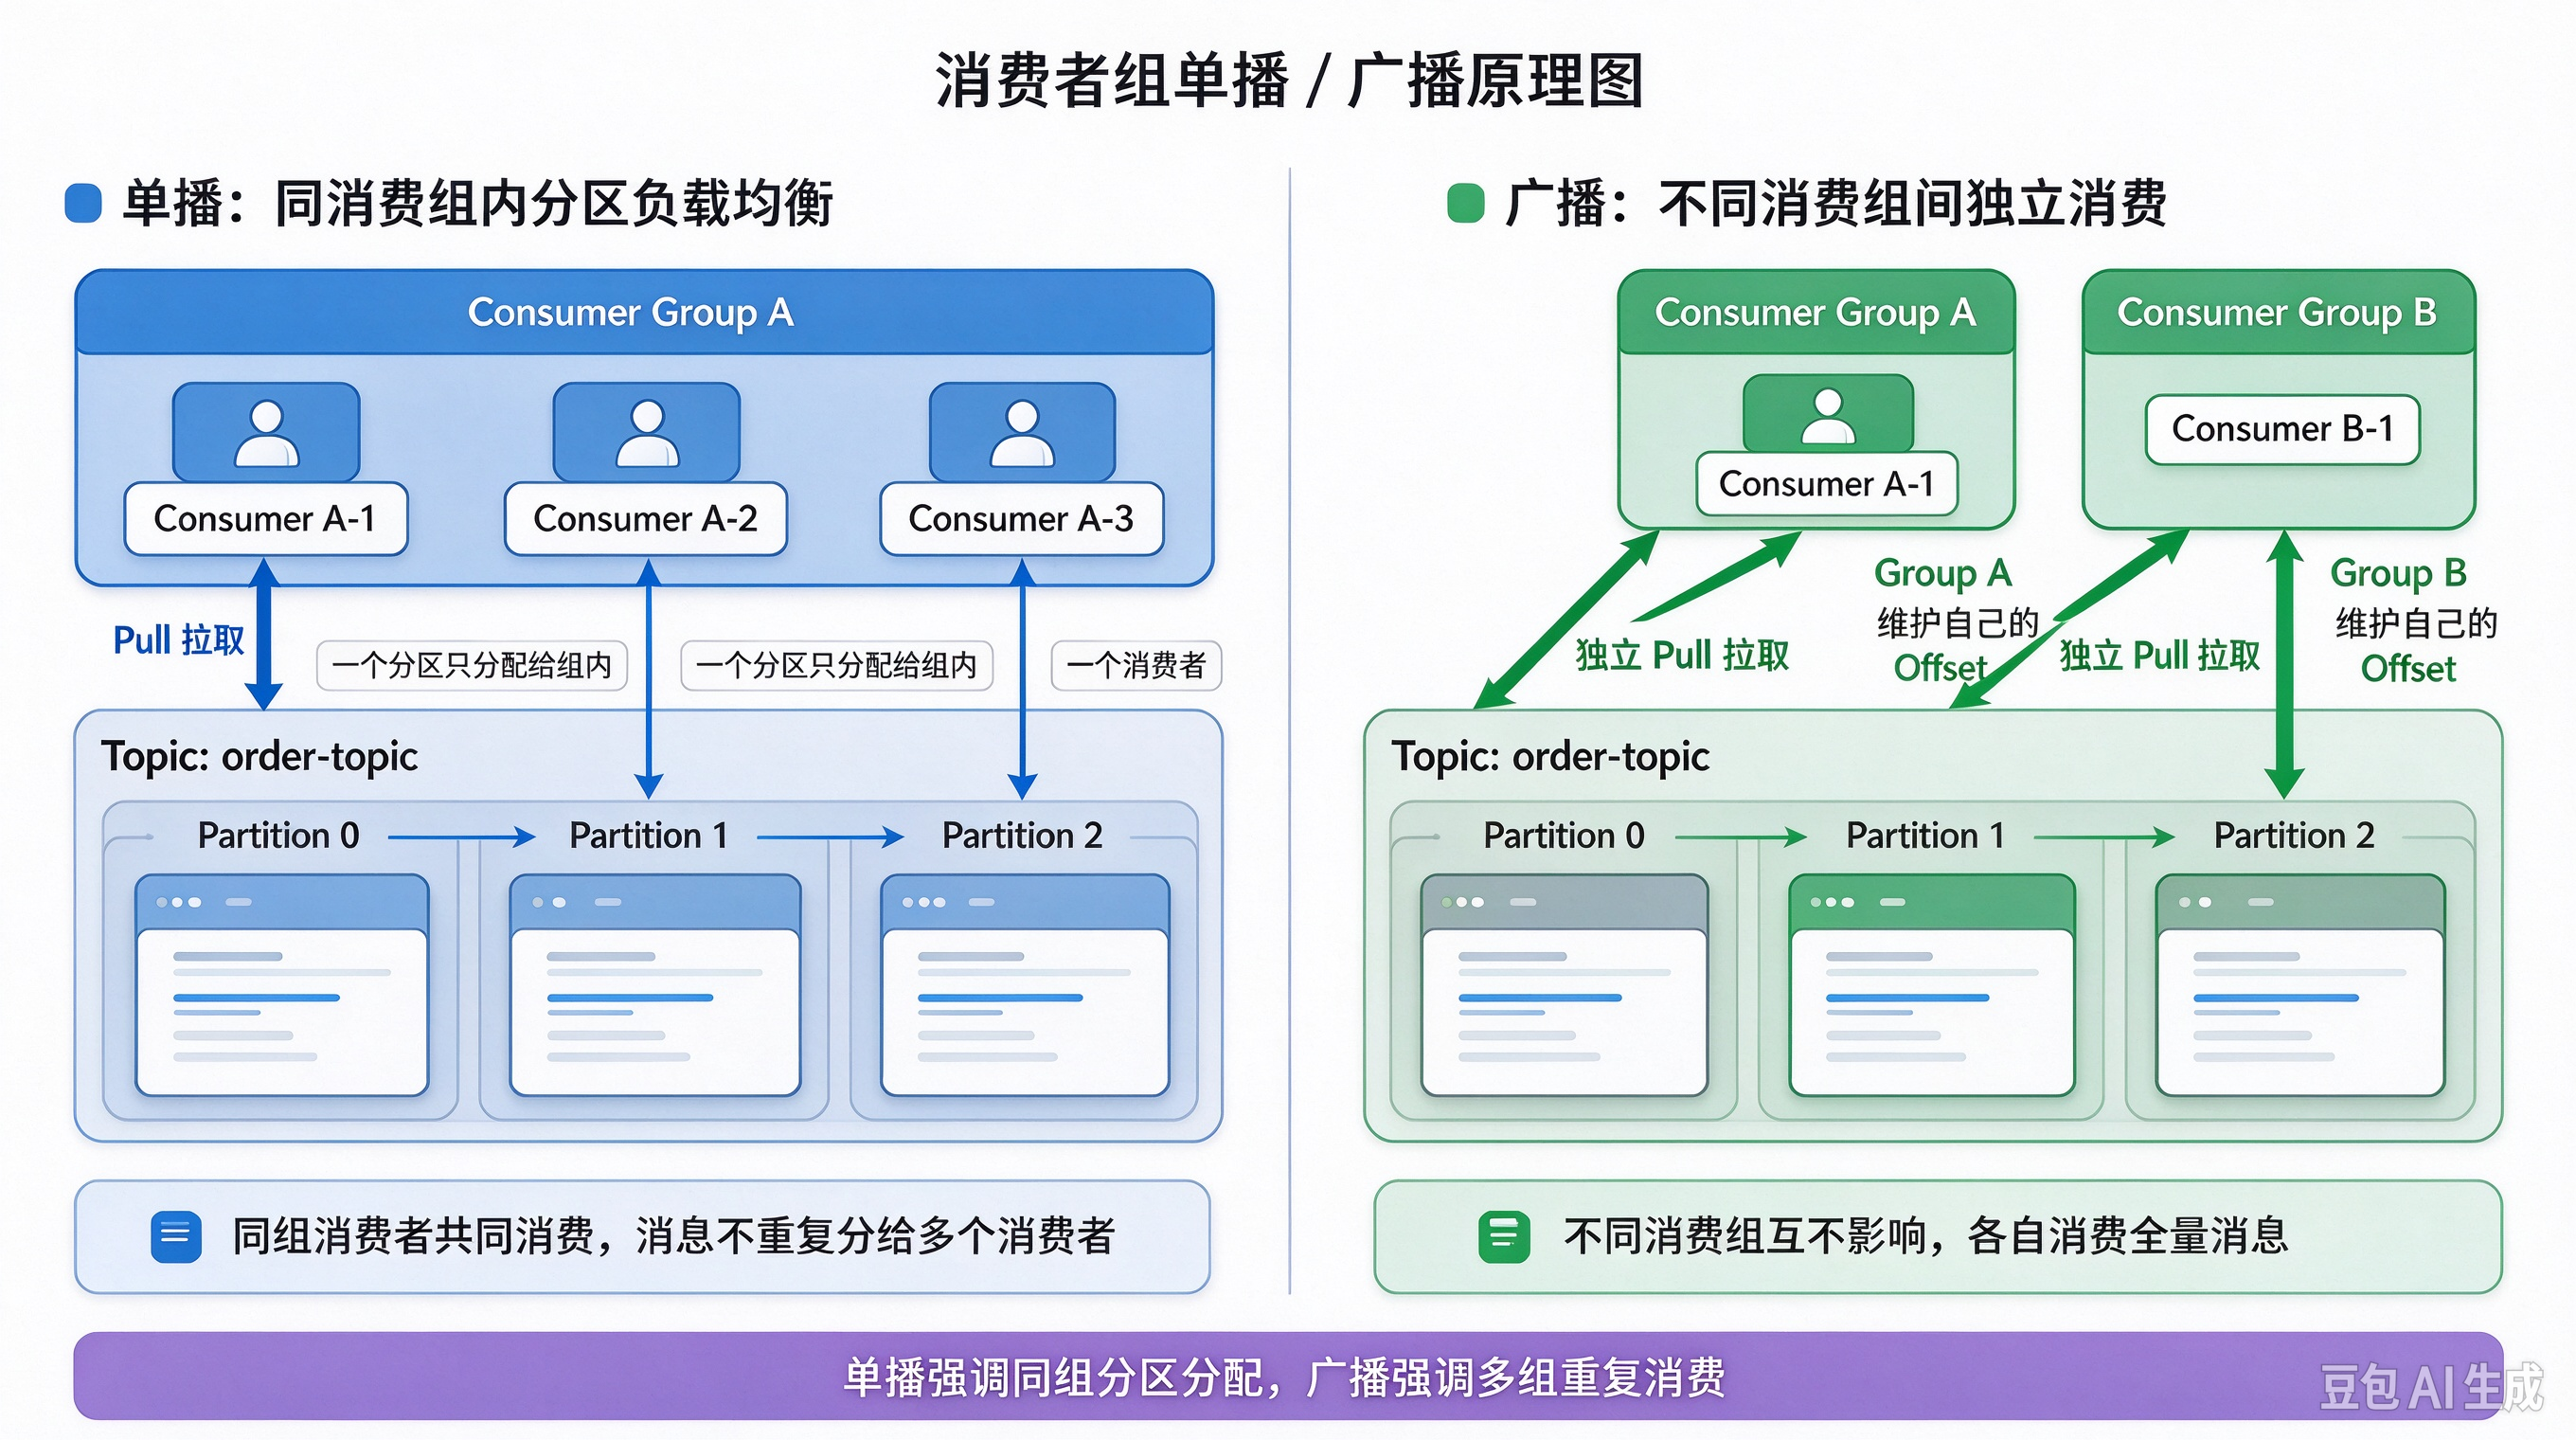
1. 单播模式(负载均衡)
规则:同一消费者组内,一个分区只能被一个消费者消费。
如果多个消费者属于同一个 Consumer Group,Kafka 会自动进行分区分配,不同消费者消费不同分区。消息只会被消费一次,实现负载均衡、提高消费吞吐量。
适用场景:订单消费、异步通知、日志处理、业务解耦。
2. 广播模式(全量消费)
规则:不同消费者组相互独立,互不影响。
若消费者属于不同的 Consumer Group,每个消费组都可以独立消费 Topic 的全部消息,实现消息广播效果。
多系统、多业务模块可以同时订阅同一个 Topic,互不干扰。
适用场景:多业务订阅、消息推送、多维度日志分析、数据同步。
五、总结
1. Kafka 核心优势:高吞吐、持久化、分布式、无状态Pull消费、流批一体,适配绝大多数高并发、大数据流场景;
2. 核心组件链路:生产者(Producer)→Topic主题→Partition分区→Broker集群→消费者(Consumer)→消费者组(Consumer Group);
3. 消费者组是Kafka的核心设计,灵活实现负载均衡单播和业务广播,是面试和实战的核心考点。
💖 码字不易,欢迎点赞、收藏、关注,后续持续更新Kafka高阶知识点(消息丢失、重复消费、分区副本、ISR、调优方案)!
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_45235440/article/details/166783035