
Linux开发工具详解(一):软件包管理、Vim、GCC/G++、Makefile与进度条实战
文章目录
- Linux开发工具详解(一):软件包管理、Vim、GCC/G++、Makefile与进度条实战
- 一、Linux软件包管理
- 二、apt / dnf / yum常用操作
- 三、什么是软件源?
- 四、Vim:Linux终端中的经典编辑器
- 五、Vim最重要的三个模式
- 六、Vim模式切换必须先掌握
- 七、Vim正常模式常用命令
- 八、Vim查找
- 九、Vim常用配置
- 十、GCC与G++到底是什么?
- 十一、一个C程序到底是怎样变成可执行文件的?
- 十二、第一阶段:预处理
- 十三、第二阶段:编译
- 十四、第三阶段:汇编
- 十五、第四阶段:链接
- 十六、为什么printf不用自己实现?
- 十七、静态库与动态库
- 十八、GCC/G++常用选项
- 十九、为什么需要Makefile?
- 二十、make与Makefile是什么关系?
- 二十一、Makefile最核心的规则
- 二十二、make如何判断要不要重新构建?
- 二十三、一个多文件Makefile
- 二十四、clean为什么要写成.PHONY?
- 二十五、Makefile变量
- 二十六、自动变量
- 二十七、模式规则
- 二十八、一份更实用的Makefile
- 二十九、综合实践:Linux终端进度条
- 三十、\r与\n不是一回事
- 三十一、为什么必须fflush(stdout)?
- 三十二、先写一个倒计时
- 三十三、进度条核心代码
- 三十四、进度条为什么能够“动起来”?
- 三十五、完整开发流程总结
- 总结
前言:Linux开发并不是只会写代码
1. 从“写代码”到“完成一个程序”
刚开始学习 C/C++ 时,我们可能只关心:
写代码
↓
点一下运行
↓
得到结果
IDE 已经帮我们完成了大量工作。
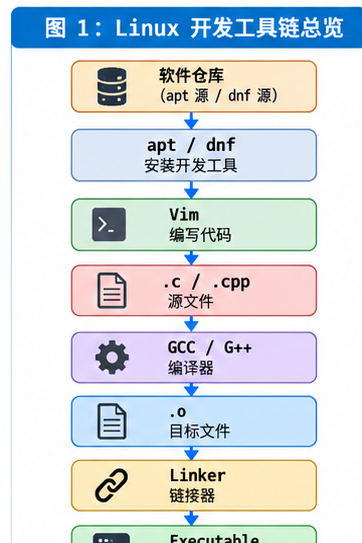
但在 Linux 中,如果直接使用命令行开发,一个程序通常会经历:
安装开发工具
    ↓
编辑源代码
    ↓
编译
    ↓
链接
    ↓
生成可执行程序
    ↓
运行
    ↓
修改
    ↓
重新构建
分别会涉及:
apt / dnf / yum
        ↓
软件包管理

Vim
        ↓
代码编辑

GCC / G++
        ↓
编译与链接

make / Makefile
        ↓
自动化构建
本文就从这条开发链开始。
一、Linux软件包管理
1. 为什么需要软件包管理器?
1.1 直接从源码安装有什么问题?
理论上,Linux 软件完全可以:
下载源码
↓
配置
↓
编译
↓
链接
↓
安装
例如:
./configure
make
sudo make install
但问题是:
编译耗时
依赖复杂
版本不好管理
卸载困难
因此 Linux 发行版通常会把软件提前:
编译
打包
建立依赖关系
形成:
软件包
然后放入:
软件仓库 Repository
用户通过包管理器完成安装。
2. 软件包与包管理器是什么关系?
2.1 可以类比手机应用商店
可以粗略理解为:
软件包
≈ App

软件仓库
≈ 应用商店服务器

包管理器
≈ 应用商店客户端
用户执行:
sudo apt install git
背后实际上可能经历:
查询仓库
↓
找到 git 软件包
↓
分析依赖
↓
下载依赖
↓
下载 git
↓
安装
↓
记录安装信息
因此包管理器最重要的价值之一就是:
自动处理依赖
3. 不同Linux发行版使用什么包管理器?
3.1 Debian / Ubuntu
主要使用:
apt
例如:
sudo apt update
sudo apt install gcc
3.2 CentOS 7等较老的Red Hat系环境
很多课程环境使用:
yum
例如:
sudo yum install gcc
3.3 Fedora、RHEL 8/9等较新的系统
现代 Red Hat 系环境核心已经转向:
dnf
例如:
sudo dnf install gcc
部分系统中的:
yum
主要作为兼容入口继续存在。
所以实际使用时应先确定:
cat /etc/os-release
查看自己的发行版。
二、apt / dnf / yum常用操作
1. 查询软件
1.1 Ubuntu
apt search git
查看详细信息:
apt show git
1.2 RHEL / Fedora
dnf search git
也可以:
dnf info git
旧环境可能使用:
yum list | grep git
2. 安装软件
2.1 Ubuntu
sudo apt install -y git
2.2 Fedora / RHEL
sudo dnf install -y git
旧 CentOS:
sudo yum install -y git
其中:
sudo
↓
以管理员权限执行

-y
↓
自动确认安装
3. 删除软件
Ubuntu:
sudo apt remove git
Fedora / RHEL:
sudo dnf remove git
4. 更新软件包索引
Ubuntu 常见:
sudo apt update
升级:
sudo apt upgrade
Fedora / RHEL:
sudo dnf upgrade
三、什么是软件源?
1. 软件到底从哪里下载?
执行:
sudo apt install vim
并不是从:
互联网随机搜索 Vim
而是从已经配置好的:
软件仓库
下载。
2. 为什么会有镜像源?
官方软件源可能距离用户较远。
于是很多组织建立:
Mirror
镜像站
定期同步官方仓库。
这样用户就可以:
从距离较近的服务器下载软件
通常速度更稳定。
3. 国内常见镜像站
常见的有:
清华大学 TUNA
中国科学技术大学 USTC
阿里云镜像站
上海交通大学镜像站
具体是否需要更换,应根据:
所在网络
发行版
当前下载速度
决定。
四、Vim:Linux终端中的经典编辑器
1. vi与Vim是什么关系?
1.1 vi
vi 是 Unix/Linux 中非常经典的:
多模式文本编辑器
1.2 Vim
Vim:
Vi IMproved
可以理解成:
vi 的增强版本
增加了很多功能,例如:
语法高亮
更丰富的命令
插件能力
可视模式
五、Vim最重要的三个模式
1. 正常模式 Normal Mode
进入 Vim:
vim test.c
默认进入:
正常模式
这里主要用于:
移动
复制
删除
粘贴
查找
执行命令
而不是普通地输入文本。
2. 插入模式 Insert Mode
在正常模式按:
i
即可开始输入。
常用方式:
i
↓
在当前光标位置前开始输入

a
↓
在当前光标位置后开始输入

o
↓
在当前行下方创建新行
返回正常模式:
Esc
3. 末行模式 Command-line Mode
正常模式输入:
:
进入末行模式。
常用于:
保存
退出
配置
替换
跳转
例如:
:w
保存。
:q
退出。
:wq
保存并退出。
:q!
放弃修改并强制退出。
六、Vim模式切换必须先掌握
1. 最核心切换关系
                 i / a / o
       Normal ─────────────→ Insert
          ↑                     |
          └──────── Esc ────────┘


                 :
       Normal ─────────────→ Command-line
          ↑                     |
          └──────── Esc ────────┘
如果刚开始使用 Vim 时发现:
键盘输入出来的不是文字
第一反应应该是:
我现在处于什么模式?
七、Vim正常模式常用命令
1. 光标移动
1.1 基础移动
h → 左
j → 下
k → 上
l → 右
这是 Vim 最经典的一组按键。
1.2 按单词移动
w
↓
下一个单词开头

e
↓
当前/下一个单词结尾

b
↓
上一个单词开头
1.3 行内移动
0
↓
行开头

^
↓
本行第一个非空白字符

$
↓
行末尾
1.4 文件移动
gg
↓
文件开头

G
↓
文件结尾
跳到第 50 行:
50G
2. 删除
删除当前字符:
x
删除当前行:
dd
删除 5 行:
5dd
3. 复制和粘贴
复制当前行:
yy
复制 5 行:
5yy
粘贴:
p
于是经典组合:
yy
p
就是:
复制当前行
↓
粘贴
4. 撤销与重做
撤销:
u
重做:
Ctrl + r
八、Vim查找
1. 向下查找
/main
继续寻找下一个:
n
反方向:
N
2. 向上查找
?main
九、Vim常用配置
1. 用户配置文件
一般使用:
~/.vimrc
例如:
vim ~/.vimrc
2. 一份基础配置
syntax on

set number

set tabstop=4
set shiftwidth=4
set expandtab

set autoindent
set smartindent

set cursorline
其中:
set number
↓
显示行号

tabstop
↓
Tab 显示宽度

shiftwidth
↓
自动缩进宽度

expandtab
↓
把 Tab 转为空格
对于刚开始学习 Linux 开发来说,不需要一开始就在 Vim 上安装大量插件。
先掌握:
编辑
保存
查找
复制
删除
模式切换
更重要。
十、GCC与G++到底是什么?
1. GCC
GCC 可以理解为:
GNU Compiler Collection
其中支持:
C
C++
Fortran
...
多种语言。
2. gcc与g++
日常使用中:
gcc test.c
通常用于 C。
g++ test.cpp
通常用于 C++。
对于 C++ 项目更推荐直接使用:
g++
因为它会自动按照 C++ 的方式完成:
编译
以及
C++ 标准库链接
十一、一个C程序到底是怎样变成可执行文件的?
1. 四个阶段
从:
hello.c
到:
hello
通常可以分成:
源文件 .c
   |
   | 预处理
   v
.i 文件
   |
   | 编译
   v
.s 汇编文件
   |
   | 汇编
   v
.o 目标文件
   |
   | 链接
   v
可执行程序
也就是:
预处理
↓
编译
↓
汇编
↓
链接
十二、第一阶段:预处理
1. 预处理主要做什么?
例如:
宏替换
头文件展开
条件编译
去除注释
代码:
#include <stdio.h>

#define NUM 10
这些:
以 # 开头的预处理指令
首先由预处理器处理。
2. 只进行预处理
gcc -E hello.c -o hello.i
其中:
-E
↓
完成预处理后停止
可以:
vim hello.i
查看展开后的结果。
你会发现一个非常小的:
#include <stdio.h>
最终可能展开出非常多内容。
十三、第二阶段:编译
1. 从C代码到汇编
执行:
gcc -S hello.i -o hello.s
得到:
hello.s
这里会进行:
语法分析
语义分析
中间表示
优化
代码生成
最终得到:
汇编代码
2. 为什么要经过汇编?
C/C++ 是:
高级语言
CPU 真正能够执行的是:
机器指令
汇编语言可以看作:
机器指令的人类可读表示
所以编译器需要逐步把高级语义转换成底层机器代码。
十四、第三阶段:汇编
执行:
gcc -c hello.s -o hello.o
得到:
hello.o
.o 文件已经包含:
机器代码
但通常还不能直接运行。
因为程序中可能还引用:
printf
malloc
其他源文件中的函数
这些符号还没有全部解决。
十五、第四阶段:链接
gcc hello.o -o hello
得到:
hello
然后:
./hello
运行。
十六、为什么printf不用自己实现?
假设:
#include <stdio.h>

int main()
{
    printf("hello\n");
}
stdio.h 主要提供:
printf 的声明
真正的实现位于:
C 标准库
中。
链接器负责把:
程序中对 printf 的引用
与库中的:
printf 实现
联系起来。
十七、静态库与动态库
1. Linux中的常见扩展名
静态库:
.a
动态库:
.so
Windows 常见:
.lib
.dll
2. 静态链接
静态链接时:
需要的库代码
↓
进入最终可执行文件
优点:
运行时对外部库依赖较少
部署简单
缺点:
可执行文件通常更大
多个程序可能重复包含相同库代码
库升级后通常需要重新链接
3. 动态链接
动态链接时:
程序文件
+
运行时需要的共享库
共同完成执行。
优点:
多个程序可共享同一个库
程序体积通常更小
库升级更方便
缺点:
运行环境必须存在兼容的共享库
4. 查看程序依赖的动态库
ldd ./hello
可能看到:
libc.so.6
libstdc++.so.6
...
5. 查看文件类型
file hello
这是排查:
ELF 类型
架构
是否动态链接
是否包含调试信息
非常常用的命令。
十八、GCC/G++常用选项
1. 输出文件
gcc main.c -o app
2. 仅编译不链接
gcc -c main.c -o main.o
3. 生成调试信息
gcc main.c -g -o app
后面的 GDB 调试依赖:
-g
生成的调试信息。
4. 开启警告
推荐:
gcc main.c \
    -Wall \
    -Wextra \
    -o app
需要注意:
-Wall
并不是“开启世界上所有 GCC 警告”。
它代表:
开启一组常用的重要警告
而:
-Wextra
会再增加一组检查。
对于学习阶段非常建议:
不要用 -w 把警告全部关掉
很多编译器 Warning 正是在提前帮你发现 Bug。
5. 优化选项
常见:
-O0
-O1
-O2
-O3
-Og
-Os
其中:
-O0
↓
基本不优化,也是默认等级

-O2
↓
常见发布构建优化等级

-O3
↓
更加激进的优化

-Og
↓
兼顾一定优化与调试体验
学习 GDB 时可以:
gcc main.c \
    -g \
    -O0 \
    -Wall \
    -Wextra \
    -o app
避免过度优化导致:
变量被优化掉
代码执行顺序和源码差异较大
十九、为什么需要Makefile?
1. 一个文件时还没问题
只有:
main.c
时:
gcc main.c -o app
非常简单。
2. 多文件项目开始麻烦
假设:
main.c
process.c
process.h
util.c
util.h
手工:
gcc -c main.c
gcc -c process.c
gcc -c util.c

gcc main.o process.o util.o -o app
如果:
只修改了 process.c
其实只需要重新:
编译 process.c
↓
重新链接
没有必要重新编译所有文件。
于是需要:
自动分析依赖
+
增量构建
这就是:
make
+
Makefile
二十、make与Makefile是什么关系?
1. make
make
是:
构建工具
2. Makefile
Makefile
是:
描述构建规则的文件
可以理解成:
Makefile
↓
说明项目应该怎么构建

make
↓
读取这些规则并执行
二十一、Makefile最核心的规则
1. 基本语法
target: prerequisites
	command
注意:
command前通常必须是 Tab,不是普通空格。
例如:
app: main.c
	gcc main.c -o app
这里:
target
↓
app

prerequisite
↓
main.c

recipe
↓
gcc main.c -o app
二十二、make如何判断要不要重新构建?
1. 基于文件修改时间
假设:
app: main.o
	gcc main.o -o app
make 会比较:
main.o 的修改时间

和

app 的修改时间
如果:
main.o 比 app 更新
说明:
依赖发生了变化
于是重新执行链接。
所以 make 能实现:
增量构建
二十三、一个多文件Makefile
app: main.o process.o
	gcc main.o process.o -o app

main.o: main.c process.h
	gcc -c main.c -o main.o

process.o: process.c process.h
	gcc -c process.c -o process.o
依赖图:
        app
       /   \
      /     \
 main.o   process.o
   |        |
main.c   process.c
     \     /
     process.h
修改:
process.c
时:
只重新构建 process.o
↓
重新链接 app
二十四、clean为什么要写成.PHONY?
1. 普通clean
clean:
	rm -f *.o app
使用:
make clean
2. 潜在问题
如果目录中恰好真的存在:
clean
这个文件,make 可能认为目标:
clean
已经存在并且无需构建。
3. 声明伪目标
.PHONY: clean

clean:
	rm -f *.o app
.PHONY 的含义不是简单的:
忽略所有时间比较
更准确地说:
clean不代表一个真正需要生成的文件,而代表一个需要执行的动作。
因此:
make clean
会执行对应 recipe,而不会把它当普通文件目标处理。
二十五、Makefile变量
1. 定义变量
CC = gcc
TARGET = app
使用:
$(CC)
$(TARGET)
例如:
CC = gcc
TARGET = app

$(TARGET): main.c
	$(CC) main.c -o $(TARGET)
二十六、自动变量
Makefile 中非常重要的一组变量:
$@
↓
当前目标

$<
↓
第一个依赖

$^
↓
所有依赖
例如:
app: main.o process.o
	gcc $^ -o $@
展开:
gcc main.o process.o -o app
二十七、模式规则
例如:
%.o: %.c
	gcc -c $< -o $@
表示:
任意 xxx.o
依赖
同名 xxx.c
于是:
main.o ← main.c
process.o ← process.c
util.o ← util.c
都可以复用这一条规则。
二十八、一份更实用的Makefile
CC = gcc

CFLAGS = -Wall -Wextra -g
TARGET = processbar

SRC = $(wildcard *.c)
OBJ = $(SRC:.c=.o)

$(TARGET): $(OBJ)
	$(CC) $^ -o $@

%.o: %.c
	$(CC) $(CFLAGS) -c $< -o $@

.PHONY: clean

clean:
	rm -f $(OBJ) $(TARGET)
执行:
make
编译。
清理:
make clean
二十九、综合实践:Linux终端进度条
1. 为什么这个案例值得做?
它可以一次串联:
\r 和 \n
stdout 缓冲
fflush
数组
字符串
函数拆分
多文件编译
Makefile
三十、\r与\n不是一回事
1. \n:换行
printf("hello\n");
让输出进入下一行。
2. \r:回车
printf("\r");
表示:
光标回到当前行开头
而不一定进入下一行。
因此:
10%
20%
30%
如果想让它们一直刷新在:
同一行
就可以利用:
\r
三十一、为什么必须fflush(stdout)?
1. stdout通常存在缓冲
例如:
printf("hello");

sleep(3);
你可能发现:
hello
没有立刻显示。
原因之一是:
stdout 缓冲机制
2. 手动刷新
printf("hello");

fflush(stdout);

sleep(3);
fflush(stdout):
要求把当前标准输出缓冲中的内容立即提交
进度条之所以能够:
实时刷新
很大程度上依赖:
fflush(stdout);
三十二、先写一个倒计时
#include <stdio.h>
#include <unistd.h>

int main(void)
{
    int i = 10;

    while (i >= 0)
    {
        printf("%-2d\r", i);

        fflush(stdout);

        --i;

        sleep(1);
    }

    printf("\n");

    return 0;
}
关键:
\r
↓
不断回到行首

fflush
↓
立即显示
三十三、进度条核心代码
#include <stdio.h>
#include <string.h>
#include <unistd.h>

#define WIDTH 50

void ProgressBar(void)
{
    char bar[WIDTH + 1];

    memset(
        bar,
        0,
        sizeof(bar)
    );

    const char* spinner =
        "|/-\\";

    int spinner_len =
        strlen(spinner);

    for (int i = 0;
         i <= 100;
         ++i)
    {
        int count =
            i * WIDTH / 100;

        memset(
            bar,
            '=',
            count
        );

        bar[count] = '\0';

        printf(
            "[%-50s] [%3d%%] [%c]\r",
            bar,
            i,
            spinner[
                i % spinner_len
            ]
        );

        fflush(stdout);

        usleep(50000);
    }

    printf("\n");
}
三十四、进度条为什么能够“动起来”?
1. 第一次打印
[===== ] [10%]
末尾:
\r
光标回到本行开头。
2. 下一次重新覆盖
[========== ] [20%]
并没有:
打印 100 行
而是不断:
覆盖同一行
于是视觉上产生动画效果。
三十五、完整开发流程总结
现在可以把 Linux 基础开发工具串起来:
apt / dnf
    ↓
安装开发工具
    ↓
Vim
    ↓
编辑 C/C++
    ↓
GCC / G++
    ↓
预处理 → 编译 → 汇编 → 链接
    ↓
Makefile
    ↓
自动化构建
    ↓
运行程序
这套流程的意义并不是:
“以后不用 IDE”
而是让我们真正知道:
IDE 的 Build、Run、Clean、Debug 按钮背后究竟发生了什么。
总结
这一阶段最重要的不是死记几十条命令,而是理解整个 Linux 开发工具链。
1. 软件包管理
apt
dnf
yum
解决:
软件安装
依赖处理
升级
卸载
2. Vim
核心是:
Normal
Insert
Command-line
三个模式之间的切换。
3. GCC/G++
代码经历:
.c/.cpp
↓
预处理
↓
编译
↓
汇编
↓
链接
↓
可执行程序
4. Makefile
本质是:
描述依赖关系
+
描述依赖生成方法
让:
重复手工编译
变成:
make
5. 最终形成
编辑
↓
构建
↓
运行
↓
修改
↓
重新构建
这才是一个真正的开发循环。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/Face_FeaR/article/details/166992765