
一、vector 的基础遍历与迭代器
这个函数只做一件事:把同一个 vector 用五种方式读出来/改出来,借此展示 C++ 容器的各种访问接口。
void test01()
{
    vector<int> v1;
    v1.push_back(1); v1.push_back(2);
    v1.push_back(3); v1.push_back(4);
    // ① 下标访问
    for (size_t i = 0; i < v1.size(); i++)
        cout << v1[i] << " ";
    cout << endl;
    // ② 正向迭代器
    vector<int>::iterator it1 = v1.begin();
    while (it1 != v1.end()) { cout << *it1 << " "; ++it1; }
    cout << endl;
    // ③ 范围 for(引用,可改值)
    for (auto& a : v1) { ++a; }
    cout << endl;
    // ④ 反向迭代器
    vector<int>::reverse_iterator it2 = v1.rbegin();
    while (it2 != v1.rend()) { cout << *it2 << " "; ++it2; }
    cout << endl;
    // ⑤ 只读 const_iterator
    vector<int>::const_iterator it3 = v1.begin();
    while (it3 != v1.end()) { //--(*it3); cout << *it3 << " "; ++it3; }
    cout << endl;
}
准备:构造一个 vector
vector<int> v1;是默认构造:得到一个空的动态数组,size == 0、capacity == 0,底层还没分配任何元素空间。v1.push_back(1..4)连续在尾部追加 4 个元素,此时v1内是{1,2,3,4}。push_back是 vector 最常用的写操作,专门在末尾追加——因为 vector 是一个"连续内存的数组",尾部追加最快。
① 下标访问 v1[i]
v1[i]调用的是operator[],按下标直接定位到第 i 个元素,时间复杂度 O(1)。- 关键陷阱:
operator[]不做越界检查。i 超出size不会报错,而是未定义行为(可能读到垃圾值或崩溃)。想安全访问应该用v1.at(i)(越界会抛std::out_of_range)。- 返回的是引用,所以既能读也能写:
v1[i] = 99是合法的。v1.size()返回类型是size_t(无符号整数),所以循环下标也用size_t i,避免符号/无符号比较的告警。
② 正向迭代器 begin() / end()
- 迭代器是 STL 的核心概念:能指向容器中的某个元素,并支持
*(解引用取值)、++(前进到下一个)、!=(比较是否相等)。begin()指向第一个元素;end()指向最后一个元素的下一个位置,叫"哨兵/尾后迭代器"。这是一个半开区间[begin, end)。- 循环条件
it1 != v1.end()判断"还没走到末尾";++it1让迭代器前进一位。*it1解引用得到元素本身。这里只读输出1 2 3 4。- 为什么要用迭代器而不是下标?因为迭代器对所有容器通用(list、map、set 都能用),而下标只对支持随机访问的容器可用。学 STL 就要习惯"用迭代器而不是下标去遍历"。
③ 范围 for
- 范围 for 是 C++11 引入的语法糖,本质就是把"迭代器遍历"包装成更简洁的写法,等价于上面的
while循环。- 这里的
auto& a是引用:a是容器里每个元素的别名,所以++a会直接修改容器里的值。执行后 v1 变成{2,3,4,5}。- 如果写成
for (auto a : v1)(没有&),那a只是每个元素的拷贝,++a改的是副本,容器不变。这是"想改值必须用&"的最典型场景。- 只想读、不想改时,写成
for (const auto& a : v1)更安全、也更省拷贝。- 注意:此处
cout << endl只是打一个换行,没有输出内容。
④ 反向迭代器 rbegin() / rend()
- 反向迭代器让"从尾部往前遍历"变得和正向一样自然。
rbegin()指向最后一个元素(反向意义上的 begin),rend()指向第一个元素之前(反向哨兵)。区间仍是[rbegin, rend),只是方向反了。++it2在反向迭代器上意味着向容器头部移动。- 在 v1 已被改成
{2,3,4,5}后,反向输出是5 4 3 2。- 反向迭代器用起来和普通迭代器几乎一样,唯一的心理落差是"
++居然在倒退"。这是它最重要的记忆点。
⑤ 只读 const_iterator
const_iterator解引用后得到 const 引用,只能读、不能写。- 被注释的
--(*it3)如果放开,会编译报错——因为*it3是 const 的,不允许自减。编译器在编译期就拦住了这类误写。- 有意思的是:即使
v1本身不是 const 对象,你也可以显式用const_iterator强制"只读遍历",作为纪律性的手段。- 此时 v1 是
{2,3,4,5},只读输出仍是2 3 4 5。
同一个 vector,五种视角(示意)2345begin()end()→rbegin()←rend()v1[2] → 4下标[]、正向迭代器、范围for、反向迭代器、const_iterator 五种方式都在这条连续内存上工作示意,非精确布局
vector 的元素存放在一段连续内存里,五种访问方式只是视角不同
小结:遍历方式本身不难,真正要记住的是三个区别——下标无越界检查、范围 for 想改值必须用
&引用、const_iterator 只读。
二、构造、扩容、insert 与 erase
这个函数在演示三件事:用"个数+值"构造 vector、观察 capacity 是怎么翻倍增长的、以及 insert/erase 怎么在中间增删元素。
void test02()
{
    vector<int> v1(10, 2);
    for (size_t i = 0; i < v1.size(); ++i) cout << v1[i] << " ";
    cout << endl;

    vector<size_t> v2;
    size_t old = v2.capacity();
    cout << old << endl;                       // 0
    for (size_t i = 0; i < 100; ++i) {
        v2.push_back(i);
        if (old != v2.capacity()) { old = v2.capacity(); cout << old << endl; }
    }

    v2.insert(v2.begin(), 1000);          // 头插
    v2.insert(v2.begin(), 10);
    for (auto& a : v2) cout << a << " ";
    cout << endl;

    v2.insert(v2.begin() + 8, 10);      // 任意位置插
    for (auto& a : v2) cout << a << " ";
    cout << endl;

    size_t x; cin >> x;
    auto it = find(v2.begin(), v2.end(), x);
    if (it != v2.end()) v2.insert(it, 10000);
    for (auto& a : v2) cout << a << " ";
    cout << endl;

    size_t t; cin >> t;
    it = find(v2.begin(), v2.end(), t);
    if (it != v2.end()) v2.erase(it);
    for (auto& a : v2) cout << a << " ";
    cout << endl;
}
① vector<int> v1(10, 2):fill 构造
- 这是 vector 的填充构造函数:第一个参数是元素个数,第二个是每个元素的初值。这里得到 10 个值全部为 2 的元素。
- 如果只写
vector<int> v1(10),那就是 10 个元素,初值为该类型的默认值(int 为 0)。- 注意它和
vector<int> v1{10, 2}的区别:大括号是列表初始化,会解释成"两个元素:10 和 2"。小括号才是"个数 + 值"。这是新手最容易踩的坑。
② capacity 与扩容机制(核心中的核心)
- 先厘清两个概念:
size()是当前实际元素个数;capacity()是当前已分配的内存能容纳的元素个数。后者是"预留容量",两者常常不相等。- 空 vector 的 capacity 为 0,所以第一次打印 old 是
0。- 循环里连续
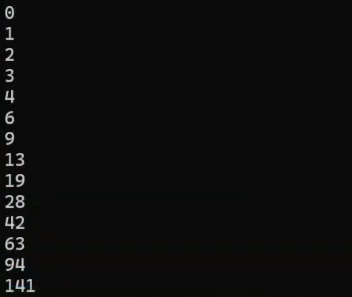
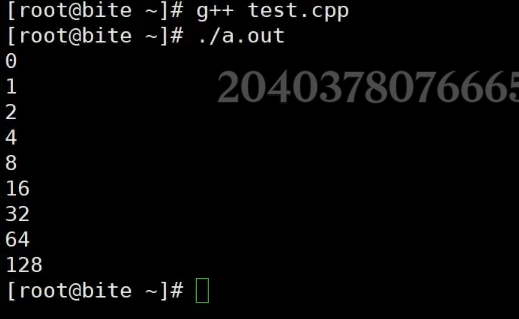
push_back100 次,每次检查 capacity 是否变化,在vs里面第一次是二倍扩容,后面都是1.5倍扩容。- 这个"翻倍增长"就是 vector 高效的原因之一:
push_back的均摊时间复杂度是 O(1)——虽然扩容一次要搬动所有元素(O(n)),但扩容次数少(log n 次),均摊下来每次追加几乎都是常数时间。- 扩容的内部步骤:① 申请一块更大的新数组 → ② 把旧元素逐个拷贝/移动过去 → ③ 释放旧数组 → ④ 更新
_ptr、_size、_capacity。每次扩容都会让所有迭代器/引用/指针失效。
扩容四步(示意,以 capacity 2 → 4 为例)旧数组(cap=2)AB① 申请更大的新数组(cap=4)????②③④ 拷贝旧元素 + 释放旧数组 + 更新指针ABCD示意
扩容 = 申请新内存 + 搬运旧元素 + 释放旧内存;A/B 是原有元素,C/D 是刚 push 进去的新元素
vs下的扩容:
Linux下的扩容:
③ 头插 insert
insert(pos, val)把val插到迭代器pos指向的位置之前。v2.begin()是头部,所以两次insert(begin(), …)都是头插:先插 1000 再插 10,最终 10 在最前面、1000 在第二位。- 代价:头部插入会让后面所有元素整体后移,复杂度 O(n)。在 vector 里频繁头插是非常低效的——这种场景应该用
deque或list。- 插入前 vector 已有 100 个元素(0..99)。
④ 任意位置插入 insert
v2.begin() + 8用到了迭代器的随机访问能力(vector 的迭代器是随机访问迭代器,支持+n)。对 list/set 就不能这么写。- 把 10 插到"当前第 8 个元素之前",同样是 O(n) 的搬移代价。
- 扩容的连带作用:如果插入导致
size撞上capacity,会先触发一次扩容,之前拿到的begin()等迭代器会失效。
⑤ find + insert:按值定位再插入
std::find(begin, end, x)来自<algorithm>,在[begin,end)里线性查找第一个等于x的元素,返回指向它的迭代器;找不到就返回end()。- 所以
if (it != v2.end())是在判断"找到了"。v2.insert(it, 10000)把 10000 插到找到的那个元素之前。- 注意
find是线性扫描 O(n),insert也是 O(n)。
⑥ erase:删除指定位置的元素
v2.erase(it)把迭代器指向的那个元素删掉,后面的元素整体前移,size减 1。capacity不会因 erase 而缩小——删除只是逻辑上减少元素,底层内存还留着。- 迭代器失效:
erase之后,被删位置及其之后的迭代器/引用/指针都失效了,不要继续用它们。想一次删多个可用erase(it1, it2)区间版本。- 同样的
if (it != v2.end())保护:找不到就不删。
⚠ 重要提醒:insert/erase 以及触发扩容后,旧迭代器会失效。这是 C++ 里最常见的"悬空引用"事故源头——用完旧的 it 前千万别先 insert/erase。另外 find 只做线性查找,别在大数据量下期望它很快。
三、emplace_back 与 push_back 的差异
这个函数通过一个会"打印构造痕迹"的结构体 A,直观展示 push_back 和 emplace_back 在拷贝次数上的差别。
先看结构体 A:
struct A
{
    A(int a = 0, int b = 0) : _a(a), _b(b)
    {
        cout << "A(int,int)" << endl;
    }
    A(const A& a)
    {
        _a = a._a;
        _b = a._b;
        cout << "A(const A&)" << endl;
    }

    int _a, _b;
};
- 构造函数带默认参数
(int a=0, int b=0),并用成员初始化列表:_a(a), _b(b)初始化两个成员。初始化列表比在函数体里赋值更高效、更规范。- 拷贝构造函数
A(const A&)手动逐个成员拷贝,并在里面打印一行标记。这行打印就是为了让我们肉眼看见"拷贝发生了几次"——是这段代码的"观察工具"。- 因为是
struct,成员_a/_b默认公有,外面能直接访问。- 注意:这个 A 没有定义移动构造函数,所以后面出现的"移动"都会退化成调用拷贝构造。
主体:
void test03()
{
    // 对 int 而言 push_back / emplace_back 完全等价
    vector<int> v1; v1.push_back(1);
    vector<int> v2; v2.emplace_back(1);

    vector<A> v3;
    A aa1(3, 3);
    v3.push_back(aa1);          // ① 左值 → 拷贝构造 1 次
    v3.push_back(A(3, 3));    // ② 临时对象 → 构造1次 + 拷贝1次
    v3.push_back({ 3,3 });       // ③ 列表初始化临时 → 构造1次 + 拷贝1次

    vector<A> v4;
    A aa2(3, 3);
    v4.emplace_back(aa2);       // ④ 传左值 → 仍是拷贝 1 次
    v4.emplace_back(A(3, 3));  // ⑤ 传临时 → 构造+拷贝
    v4.emplace_back(3, 3);     // ⑥ 直接传构造参数 → 就地构造,0 拷贝 ✔

    // 迭代器解引用用 -> 访问成员
    vector<A>::iterator it1 = v3.begin();
    while (it1 != v3.end()) { cout << it1->_a << " : " << it1->_b << endl; ++it1; }

    // C++11 范围 for,用 . 访问成员
    for (auto& e1 : v3) cout << e1._a << " : " << e1._b << endl;

    // C++17 结构化绑定
    for (auto& [x, y] : v4) cout << x << ":" << y << endl;
}
核心对比:push_back vs emplace_back
两者都是尾部插入,唯一的区别是"怎么把元素放进容器":
push_back接受一个已经构造好的对象(左值或临时对象),把它拷贝/移动进容器。也就是说:它需要"先构造、再拷贝"两步。emplace_back接受的是构造函数的参数,在容器已分配的内存里就地构造对象——少了一次拷贝/移动。- 所以代码里的 ⑥
v4.emplace_back(3,3)是最高效的:直接把 3、3 传给 A 的构造函数,只构造一次、零拷贝,就是注释里写的"效率更高,传构造 A 的参数"。- 但是:①④ 传的是左值对象(aa1/aa2),无论 push 还是 emplace 都免不了拷贝——因为对象已经存在,必须复制一份进容器。②③⑤ 传临时对象也类似。
- 一句话总结:emplace 只有在"直接传构造参数"时才真正省一次拷贝;如果你手里已经有一个对象要放进去,两者区别不大。
构造流程对比(示意)
push_back(3,3) 做不到——必须给对象:临时 A(3,3)→ 拷贝容器里的 A(先构造、再拷贝 = 2 次动作)
emplace_back(3,3) 直接给参数:就地构造 A(3,3)→ 直接放进容器里的 A(只构造 1 次,0 拷贝)关键:emplace 的优势只在你"直接传构造参数"时才体现
emplace_back 在容器内就地构造,省掉一次拷贝/移动
三种"读对象"的方式
- 迭代器 +
->:it1->_a。因为迭代器解引用后得到对象,->等价于(*it1)._a,这是迭代器习惯的写法。- 范围 for + .:
for (auto& e1 : v3)里e1直接就是对象引用,所以用点号e1._a。- C++17 结构化绑定:
for (auto& [x, y] : v4)把每个 A 的_a、_b直接解构到x、y两个变量上。它是 C++17 的新语法,要求类型所有非静态成员都是公有的、且无基类,并按声明顺序绑定。A恰好满足,所以能编译。被注释的auto [x,y] = aa1;同理。- 三种写法都能用,日常最推荐范围 for;要同时拿多个字段就上结构化绑定。
小结:emplace_back 的省拷贝只在"直接传构造参数"时成立;读取对象的三种方式(->、.、结构化绑定)只是语法差异,本质都是访问同一个对象。
④ 杨辉三角(C++ 版:vector<vector<int>>)
用"二维动态数组"实现杨辉三角,展示 vector<vector<int>> 怎么充当二维数组。
class Solution {
public:
    vector<vector<int>> generate(int numRows) {
        vector<vector<int>> vv;
        vv.resize(numRows, vector<int>());                 // 外层先开 numRows 行空 vector
        for (size_t i = 0; i < numRows; ++i)
            vv[i].resize(i + 1, 1);                          // 第 i 行 resize 成 i+1 个元素,全置 1
        for (size_t i = 2; i < numRows; ++i) {
            for (size_t j = 1; j <= i; j++)                // ⚠ 边界细节见下文
                vv[i][j] = vv[i - 1][j] + vv[i - 1][j - 1];
        }
        return vv;
    }
};
① 理解 vector<vector<int>> 是什么
- 外层 vector 的每个元素又是一个
vector<int>。也就是说:vv是一个"装了很多个一维数组的数组"。vv[i]得到第 i 行的那个一维 vector;vv[i][j]再取这行的第 j 个元素——语法上和二维数组一模一样。- 但它是"动态"的:每行长度可以不同。普通二维数组
int a[n][n]必须每行等长,而杨辉三角每行长度是i+1,天然适合vector<vector>。
② 两遍 resize:先建骨架,再填值
vv.resize(numRows, vector<int>()):把外层扩容到 numRows 行,每行暂时是一个空的 vector。vv[i].resize(i + 1, 1):把第 i 行扩成i+1个元素,全部初始化为 1。因为杨辉三角每行两端本来就是 1,所以先把整行铺满 1,边界就不需要再单独处理。- 于是现在
vv已经是一张"边缘全是 1 的三角形骨架",只剩中间的数字要填。
③ 递推填数
- 杨辉三角的核心递推式:
vv[i][j] = vv[i-1][j] + vv[i-1][j-1],即"当前数 = 左上 + 正上"。- 从
i = 2开始(前两行全 1,不用算),对第 i 行内部j = 1 … i逐个覆盖。- 复杂度 O(n²),因为要填满整个三角形,共
n(n+1)/2个元素;空间也是 O(n²)。
⑤ 杨辉三角(C 风格:int** + malloc)
同一个问题换到 C 语言:没有容器,得自己用二级指针 + 动态内存分配"手工搭一个二维数组"。
int** generate(int numRows, int* returnSize, int** returnColumnSizes)
{
    // ① 建空间:先开"行指针数组",再给每行开数组
    int** aa = (int**)malloc(sizeof(int*) * numRows);
    for (size_t i = 0; i < numRows; i++)
        aa[i] = (int*)malloc(sizeof(int) * (i + 1));

    // ② 设置返回参数
    *returnSize = numRows;
    *returnColumnSizes = (int*)malloc(sizeof(int) * numRows);
    for (int i = 0; i < numRows; i++)
        (*returnColumnSizes)[i] = i + 1;

    // ③ 填数:两端置 1,中间递推
    for (int i = 0; i < numRows; ++i)
        for (int j = 0; j <= i; ++j) {
            if (i == j || j == 0) aa[i][j] = 1;
            else aa[i][j] = aa[i - 1][j] + aa[i - 1][j - 1];
        }
    return aa;
}
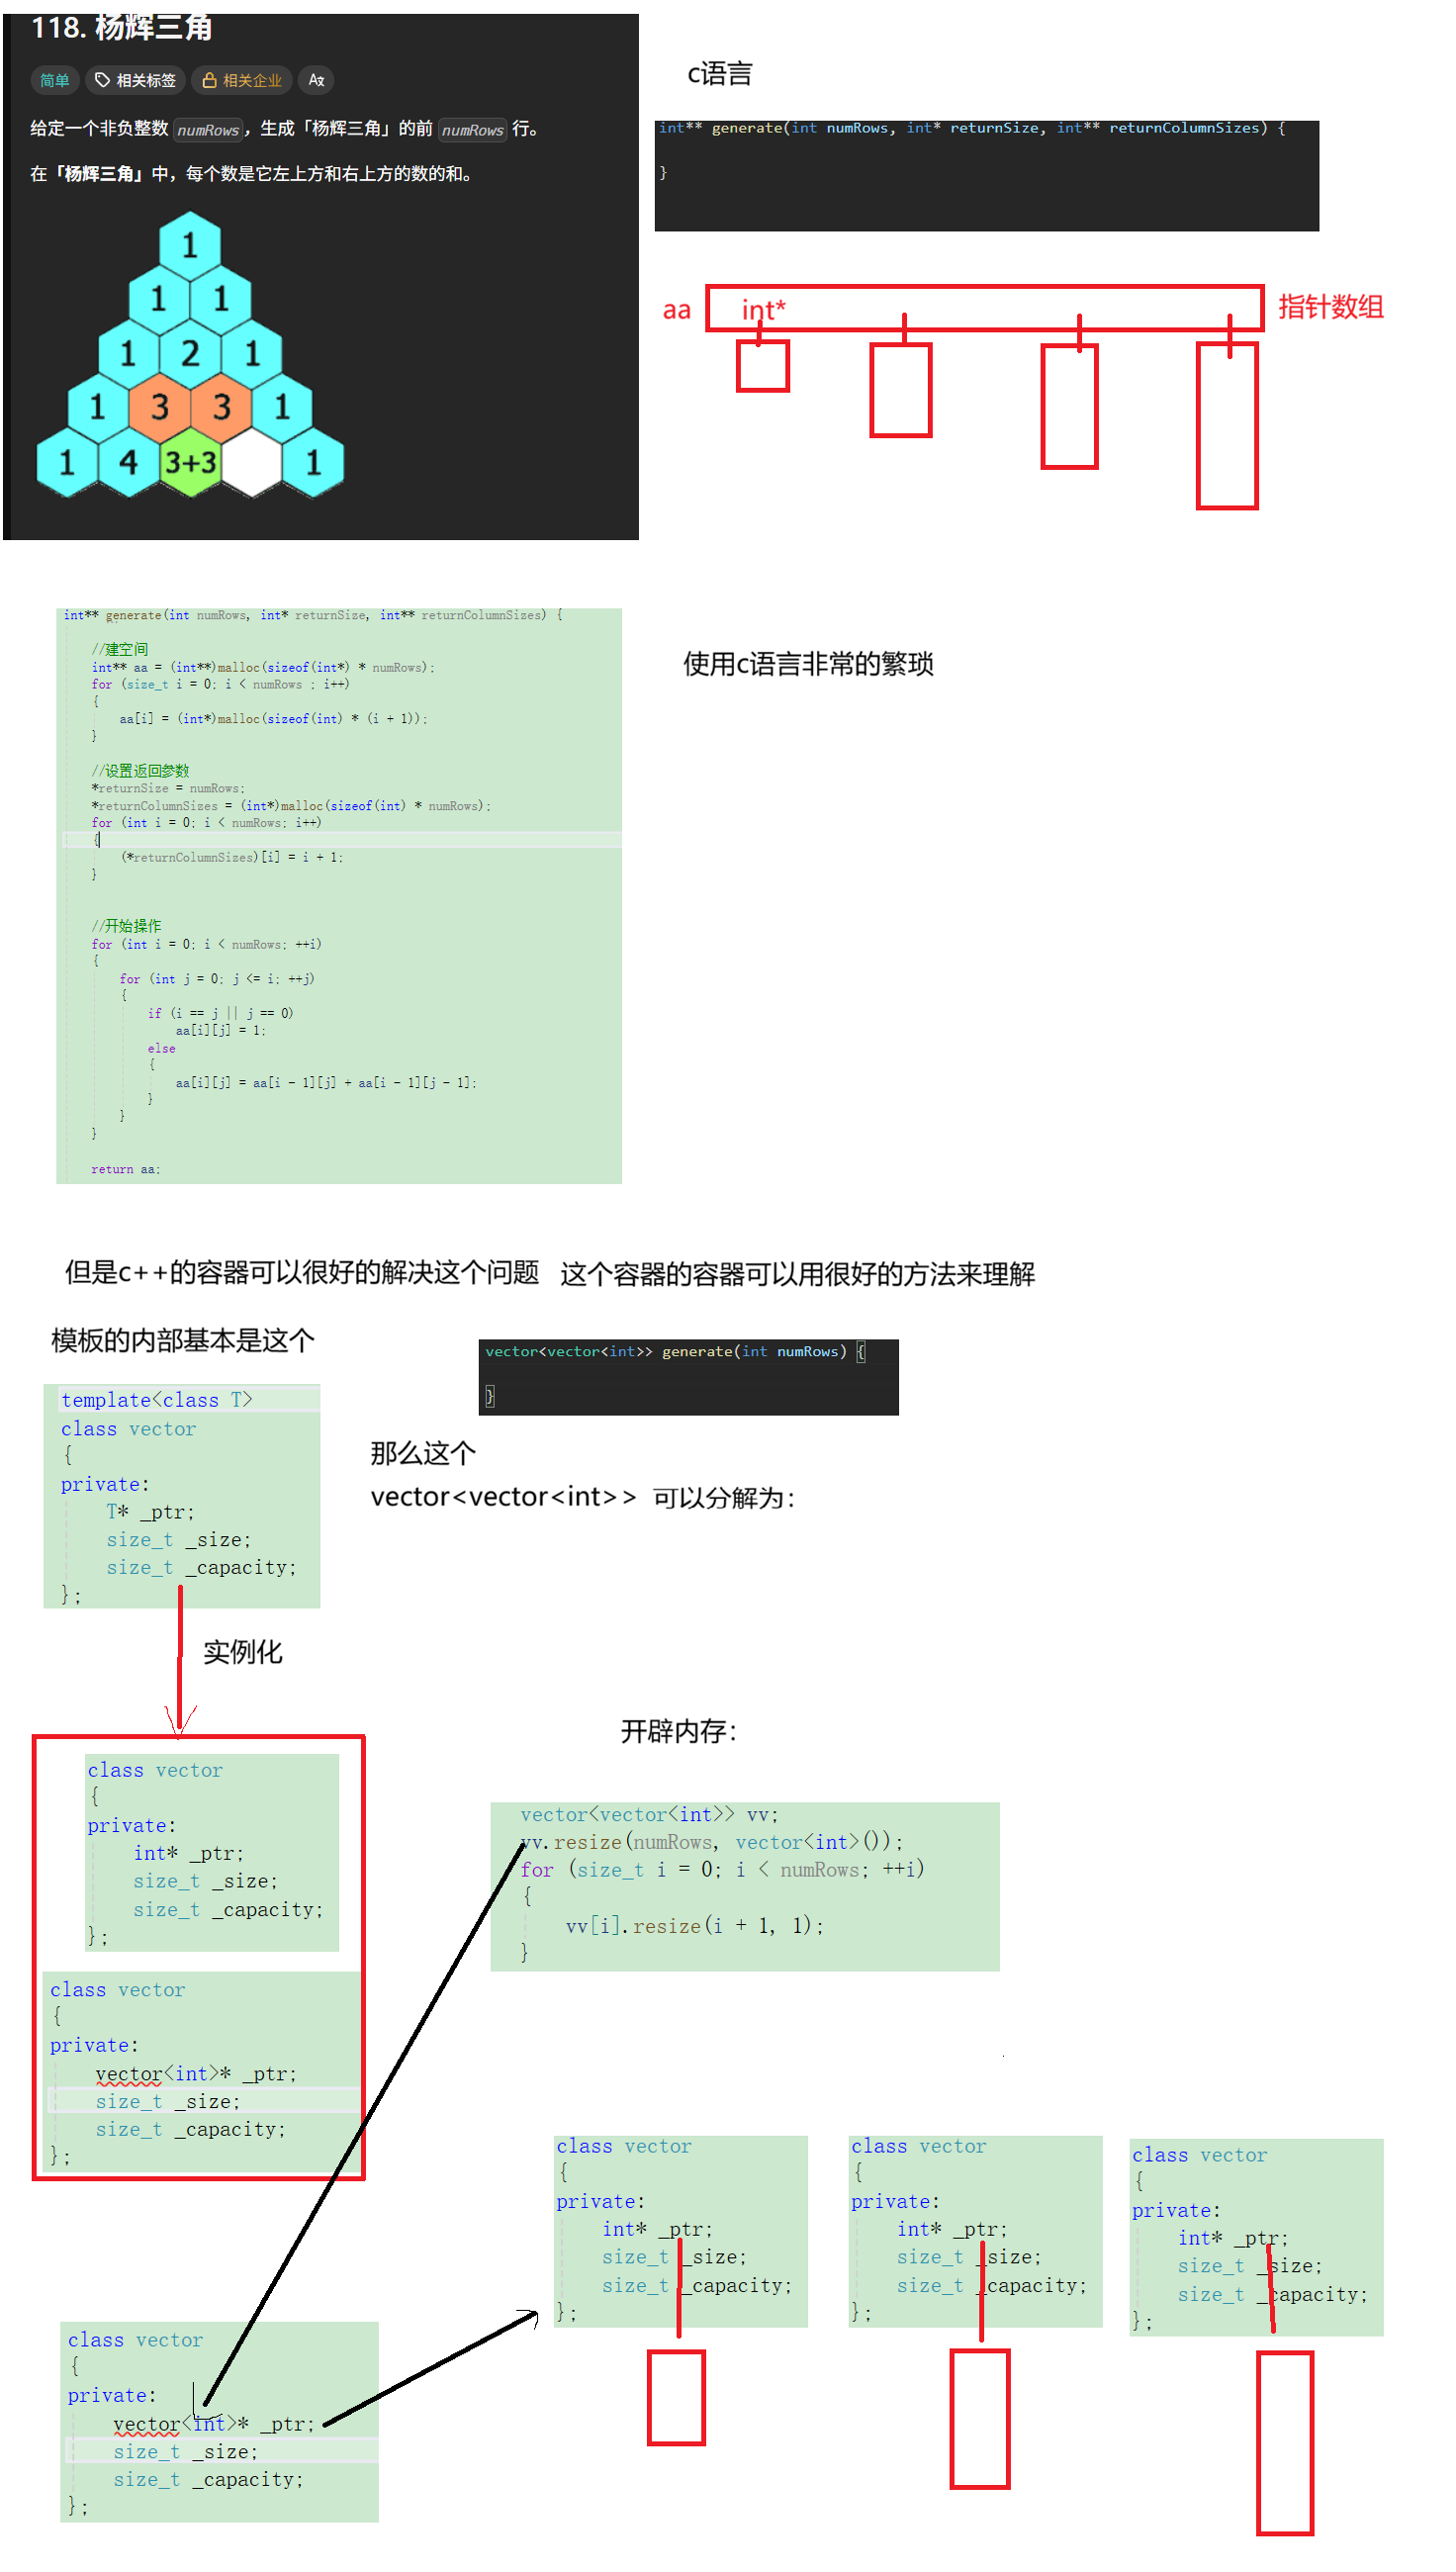
① 用 int** 模拟二维数组
- C 里没有 vector,最接近的"二维数组"就是二级指针
int**:aa是一个"指针的指针"。- 结构是:
aa指向一块存放 int* 指针的数组,其中aa[i]又指向第 i 行的int 数组头。所以aa[i][j]等价于*(*(aa+i)+j)。malloc分配原始内存:第一句给"行指针数组"开numRows个int*;循环里给每一行开i+1个int。这正好对应 C++ 版的两遍 resize。(int**)malloc(...)是 C 风格强制转换。严格说malloc返回void*,C 里可以不转,但int**的写法在混编/可读性上更清晰。
② 用指针带出多个返回值
- C 函数只能返回一个值,但这里调用方需要三样信息:行数、每行长度、数据本身。于是用输出参数解决:
returnSize(行数指针)、returnColumnSizes(每行长度的数组)。*returnSize = numRows;把行数写进调用者提供的 int 变量。*returnColumnSizes = (int*)malloc(...)先分配一个记录每行长度的 int 数组,然后(*returnColumnSizes)[i] = i+1逐行记录。- 注意括号优先级:
(*returnColumnSizes)[i]是"先解引用、再下标";如果漏掉括号写成*returnColumnSizes[i],含义就完全不同了(先下标再解引用)。这是 C 里很经典的一个坑。
③ 边界处理与 C++ 版的对照
- C 版显式用
if (i==j || j==0) aa[i][j] = 1;处理两端,中间才递推——边界完全正确,不会像 C++ 版那样越界。- 对比价值:C++ 版靠
resize(i+1, 1)把边界"预置"成 1,更省心但容易在循环边界上出问题;C 版全手动,繁琐但每一步都显式。- C 版的代价:所有内存都要自己管理——用完要逐行
free(aa[i])再free(aa)、free(*returnColumnSizes),漏一个就内存泄漏。C++ 版vector析构时自动全部释放。- 这也是"为什么现代 C++ 更推荐
vector而不是裸指针 + malloc"的最好例子:同样的逻辑,C++ 更安全、更不易错。
aa 指向一组行指针,每个 aa[i] 指向一行的 int 数组——这就是 C 版"二维数组"
⑥ 总结:一份知识点清单
| 话题 | 要点 | 一句话记忆 |
|---|---|---|
| 遍历 | 下标 []、迭代器 begin/end、范围 for、反向迭代器、const_iterator | 想改值用 &,想只读用 const auto& |
| 下标越界 | operator[] 不检查,越界是未定义行为;安全用 at() | [] 快但野,at() 慢但稳 |
| 扩容 | capacity 约 2 倍增长;扩容=新内存+搬运+释放+更新 | push_back 均摊 O(1) |
| insert/erase | 中间插入删除都是 O(n);会搬移元素 | 会失效迭代器,别再碰旧迭代器 |
| emplace vs push | emplace 直接传构造参数,就地构造,省一次拷贝 | 手里有对象用 push;有参数用 emplace |
| 二维容器 | vector<vector<int>> 每行可变长 | 注意内层循环的边界(j 别越到 i) |
| C 风格二维 | int** + malloc;用输出参数带返回值;手动 free | 括号优先级 ( *p )[i],记得逐行 free |
| vector 本质 | 封装 _ptr/_size/_capacity 的动态数组 | 三个量看懂,容器就懂了 |
练习建议
- 把
test01里auto&改成auto,观察值变不变,体会引用的作用。 - 打印扩容前后的
begin()地址,亲眼看看扩容后旧迭代器指向的内存是否已被释放。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/chenbingjie_c/article/details/166789354