
我给AI打工:蓝耘元生代 + Remotion 全自动生产每日技术新闻视频,一条命令出成片
实战视频
每天花 30 分钟刷 HackerNews / GitHub Trending,再用剪映剪一条技术日报视频要 1 小时。我用蓝耘元生代 MaaS 把「选题、写稿、分镜」压缩成一次 API 调用,配上 Edge TTS 配音和 Remotion 渲染,现在
npm run pipeline一条命令,5 分钟出一条 1080P 成片。这篇文章把完整工程拆开讲清楚。
一、为什么我要做这件事
做技术自媒体最消耗人的不是写观点,而是重复的体力活:
| 环节 | 传统做法 | 耗时 |
|---|---|---|
| 刷新闻选题 | HN / GitHub / 公众号来回切 | 20 min |
| 写口播稿 | 每条新闻组织语言 | 30 min |
| 配音 | 自己录 / 配音工具逐条对 | 20 min |
| 剪辑 | 剪映拖素材、对字幕 | 40 min |
| 合计 | ≈ 2 小时/天 |
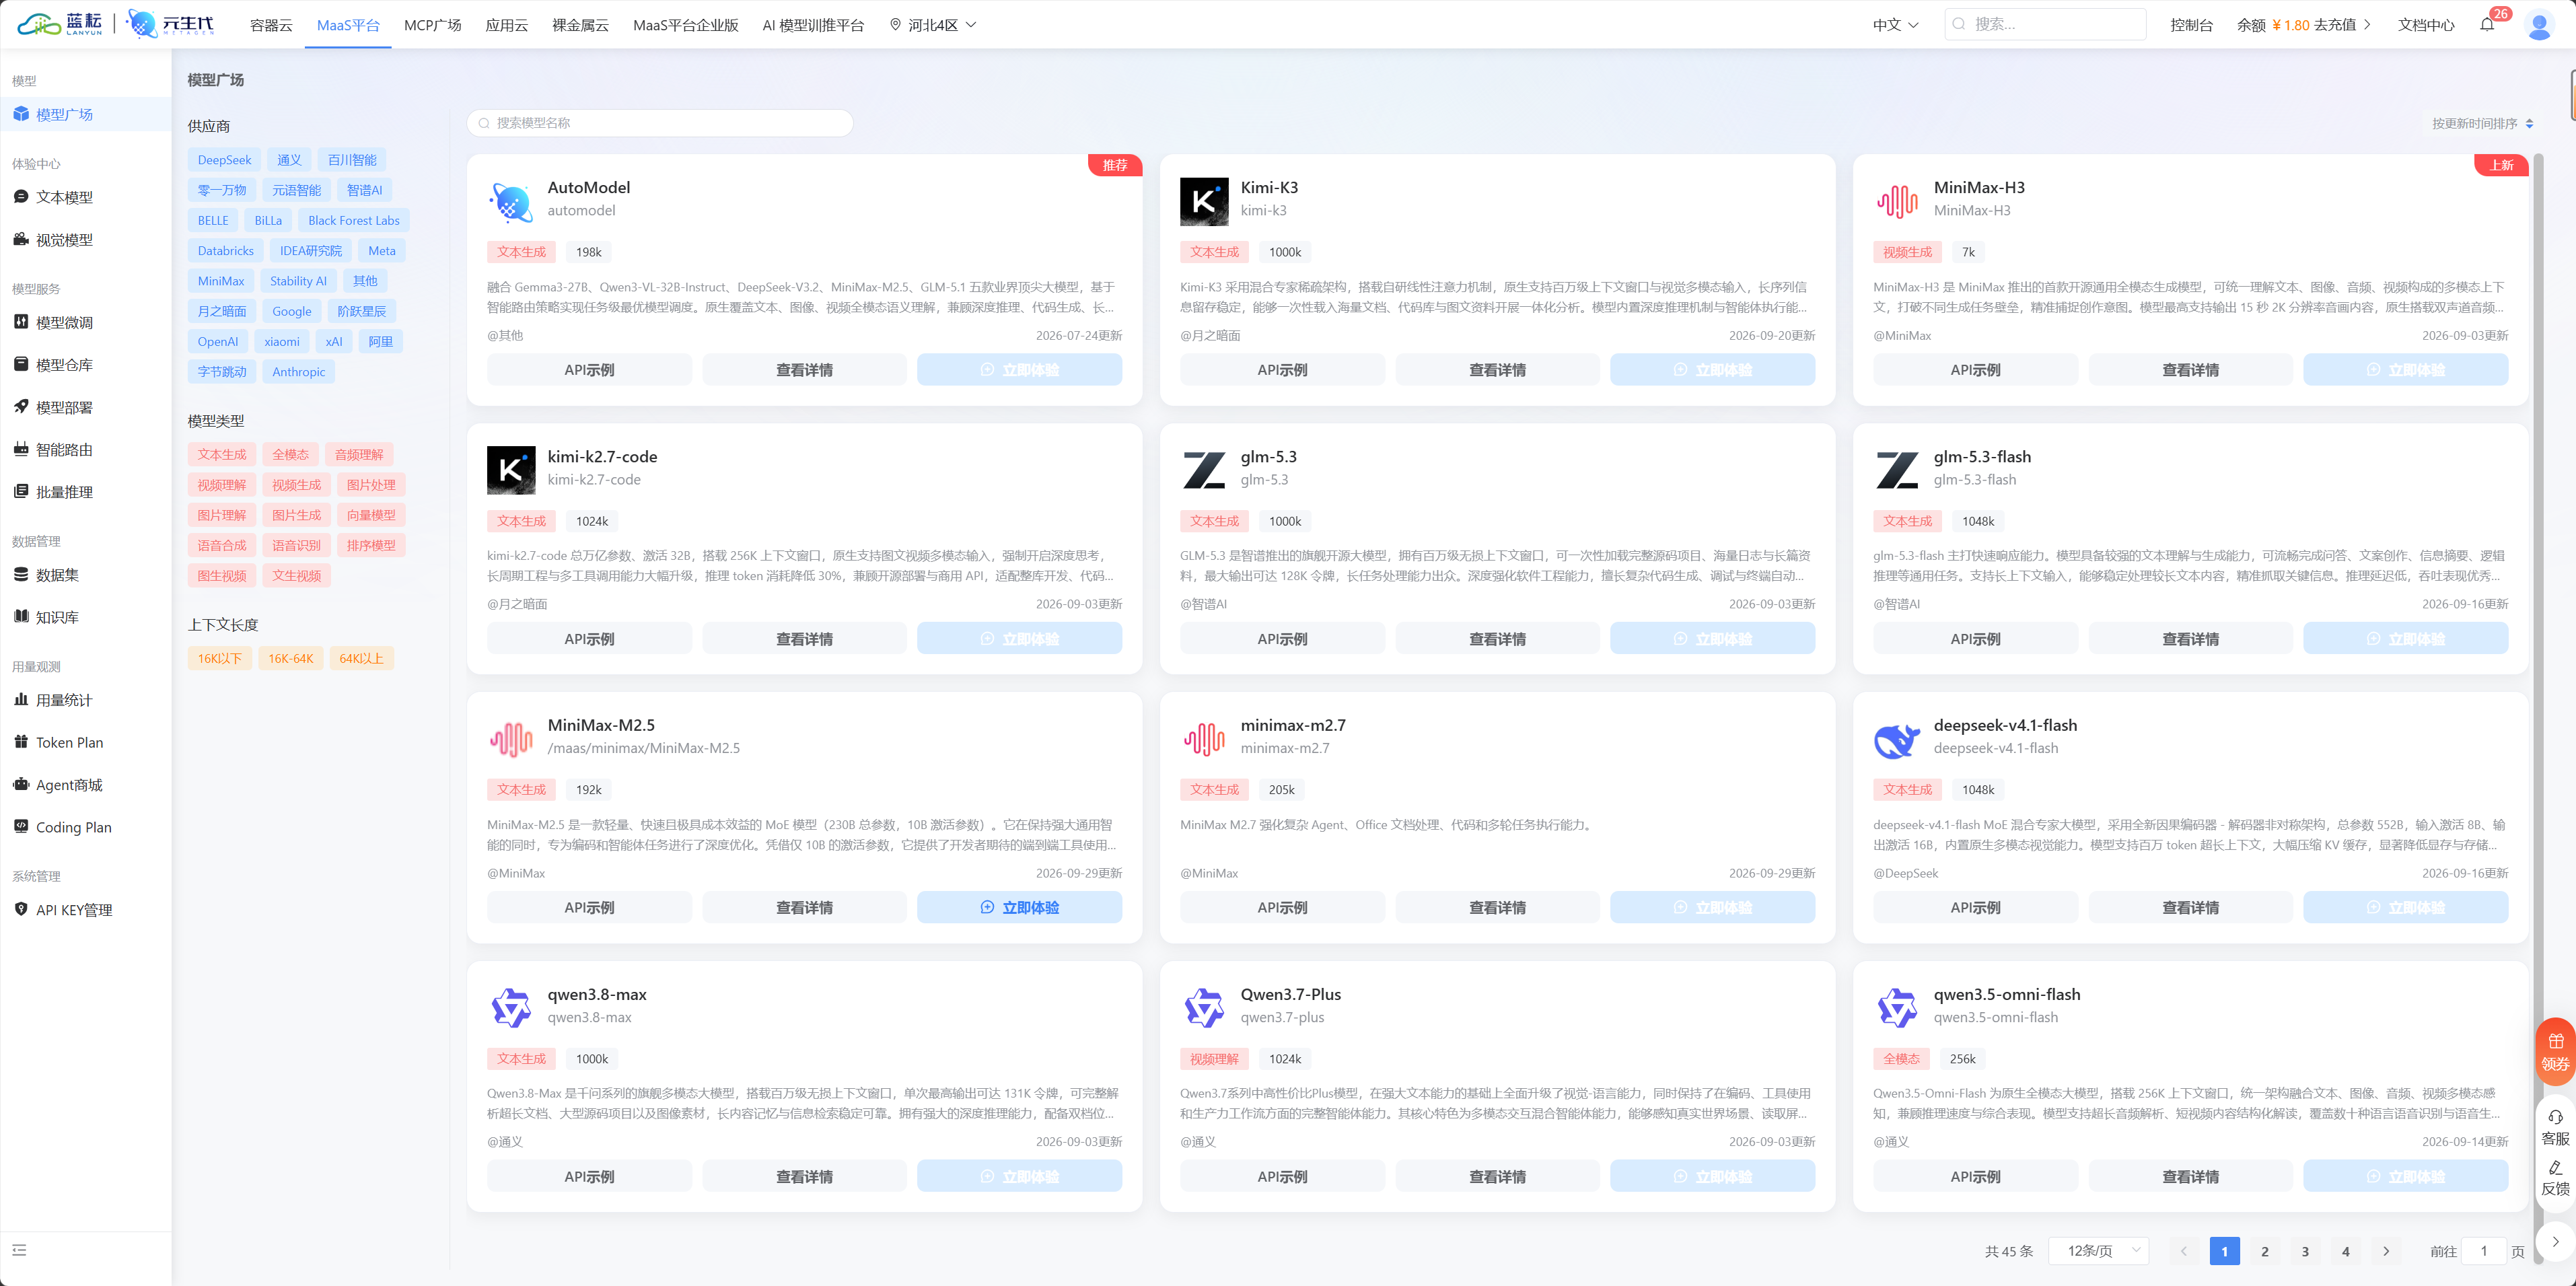
我的目标很明确:把「创意」留给自己,把「体力」全交给流水线。整条链路里只有一步真正需要大模型——从 25 条原始新闻里挑出 5 条,并写成带分镜的口播脚本。这一步我选了蓝耘元生代 MaaS,原因有三个:
- OpenAI 兼容协议:
openaiSDK 直接复用,只改baseURL和apiKey,迁移成本为零 - 支持
response_format: json_object:能强制模型输出合法 JSON,这是整个流水线能自动跑起来的关键 - 控制台能看到每次调用的 token 消耗和首 token 延迟:调试 prompt 时能精确算账,后面有截图
二、整体架构:一条流水线,四个环节
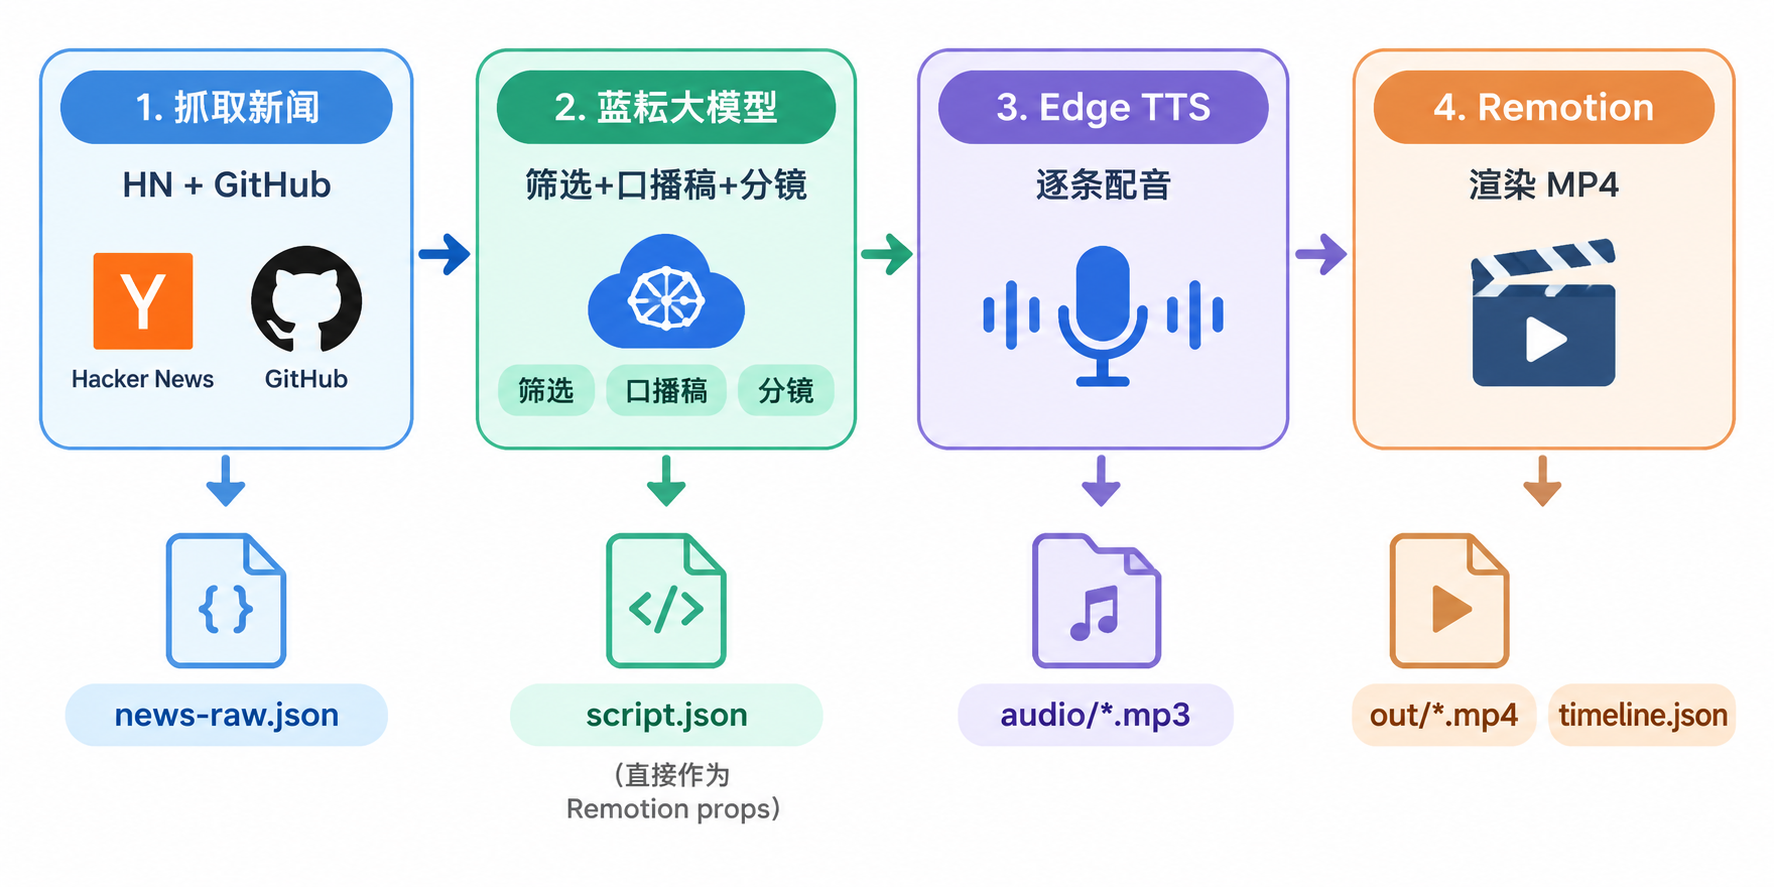
技术栈选型:
- 蓝耘元生代 MaaS(
deepseek-v4-flash)— 新闻筛选 + 口播稿 + 分镜 JSON 生成 - msedge-tts — 微软 Edge 神经网络语音,免费、中文自然
- Remotion 4 — 用 React 写视频,数据驱动画面,帧数由配音时长决定
- tsx + TypeScript — 全流程类型安全
三、核心实现:蓝耘一次调用顶一个编辑部
3.1 蓝耘客户端(带 JSON 自愈重试)
这是整个项目唯一接大模型的地方。关键点有三个:
// scripts/lanyun-client.ts
import OpenAI from 'openai';

export const lanyun = new OpenAI({
  apiKey: process.env.LANYUN_API_KEY,
  baseURL: process.env.LANYUN_BASE_URL ?? 'https://maas-api.lanyun.net/v1',
});

export async function chatJSON<T>(systemPrompt: string, userPrompt: string): Promise<T> {
  const call = async (extraInstruction = '') => {
    const res = await lanyun.chat.completions.create({
      model: LANYUN_MODEL,  // deepseek-v4-flash
      messages: [
        { role: 'system', content: systemPrompt + extraInstruction },
        { role: 'user', content: userPrompt },
      ],
      temperature: 0.7,
      response_format: { type: 'json_object' },   // ← 关键:强制 JSON
    });
    // 打印 token 用量,方便去蓝耘控制台对账
    if (res.usage) {
      console.log(`[lanyun] tokens: prompt=${res.usage.prompt_tokens} completion=${res.usage.completion_tokens}`);
    }
    return res.choices[0]?.message?.content ?? '';
  };

  const extract = (text: string): T => {
    const cleaned = text.replace(/```json\s*|\s*```/g, '').trim();
    const start = cleaned.indexOf('{');
    const end = cleaned.lastIndexOf('}');
    if (start === -1 || end === -1) throw new Error('响应中未找到 JSON 对象');
    return JSON.parse(cleaned.slice(start, end + 1)) as T;
  };

  try {
    return extract(await call());
  } catch {
    // 自愈机制:JSON 解析失败,追加格式约束重试一次
    return extract(await call('\n【重要】上一次输出不是合法 JSON,请只输出 JSON 对象。'));
  }
}
踩坑记录 1:即便开了 json_object 模式,模型偶尔还是会在 JSON 外面包一层 ```````json ````markdown 代码块,或者首尾带解释性文字。所以解析层做了「剥代码块 + 截取首个 { 到末个 }」的容错,再加一次带格式约束的重试,实测重试触发率 < 5%。
3.2 一次调用完成「筛选 + 写稿 + 分镜」
这是整条流水线信息密度最高的一步。我把 25 条原始新闻(HN 15 条 + GitHub Trending 10 条)一次性喂给蓝耘,让它返回一个结构完全固定的 JSON:
// scripts/generate-script.ts
const result = await chatJSON<VideoScript>(
  `你是一位资深科技媒体主编,正在制作面向开发者的「每日技术新闻日报」短视频。
你需要从候选新闻中挑出最有价值的 5 条(优先 AI、大模型、开源、开发者工具),并为每条写口播稿。

严格要求:
1. 只输出一个 JSON 对象,结构如下:
{
  "date": "10月7日",
  "title": "节目总标题,15字以内",
  "opening": "开场白,30字以内",
  "scenes": [{
    "headline": "新闻标题,20字以内",
    "summary": "一句话概括,30字以内",
    "script": "口播稿正文,60-90字,口语化,讲清楚是什么、为什么重要",
    "tags": ["2-3个标签"],
    "url": "从候选中原样复制的链接"
  }],
  "closing": "结束语,20字以内"
}
2. script 必须是自然中文口播稿,不能英文长句堆砌;
3. url 必须从候选列表原样复制。`,
  `以下是今天抓取到的候选新闻:\n\n${newsDigest}`
);
这个 prompt 的设计有三个刻意为之的点:
- 角色锚定(“资深科技媒体主编”)让语气稳定,不会一会儿学术一会儿营销
- 每个字段都给字数上限,防止某条新闻写超了破坏视频节奏
url强制从候选原样复制,杜绝模型编造链接——这是 AI 生成内容最容易翻车的点
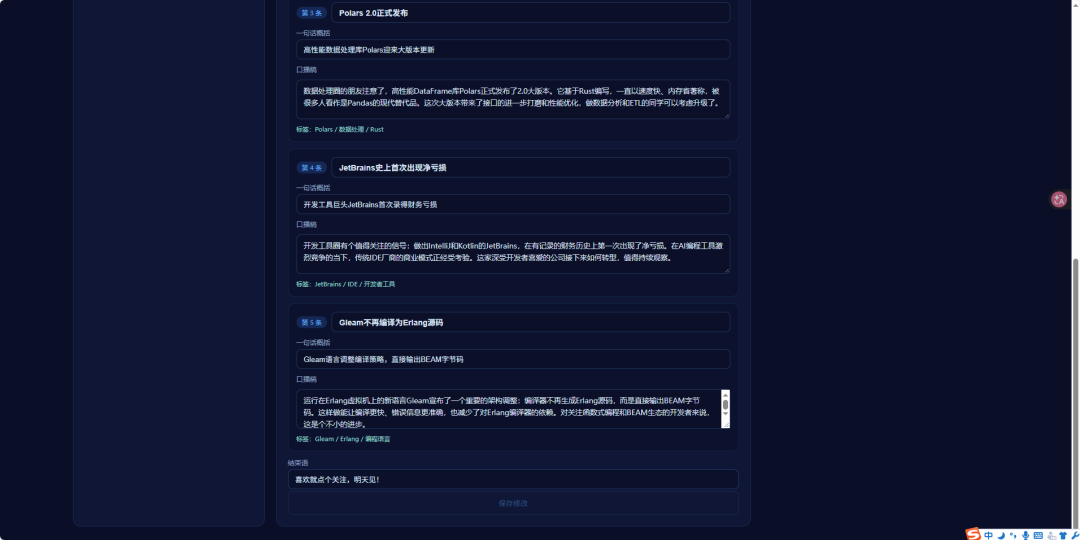
蓝耘返回的 script.json 实测效果(10月7日真实数据):
{
  "title": "模型大战与开源工具上新",
  "opening": "开发者朋友们好,科技圈今天热闹不减,五分钟带你看重点!",
  "scenes": [
    {
      "headline": "Mistral 发布旗舰模型 Large 4",
      "summary": "欧洲 Mistral 推出新一代旗舰大模型 Large 4",
      "script": "法国 Mistral 正式发布旗舰模型 Large 4,推理、代码和多语言能力全面升级...对开发者来说,这意味着又多了一个可商用、可私有部署的高性能选择,欧洲阵营这次是认真来抢市场的。",
      "tags": ["大模型", "Mistral", "AI"]
    },
    { "headline": "Reflection 开源 501B 参数模型 Beam", ... },
    { "headline": "Polars 2.0 正式发布", ... },
    { "headline": "DeepSeek 开源 GPU 算子库 DeepGEMM", ... },
    { "headline": "claude-mem:给智能体装上记忆", ... }
  ],
  "closing": "点个关注,明天同一时间见!"
}
选题质量确实在线——5 条全部是当天开发者圈子真实热点,蓝耘挑的优先级(Mistral 旗舰 > 501B 开源 > Polars 大版本 > DeepSeek 基础设施 > Agent 工具)符合一个技术主编的判断。
四、TTS 配音 + 时间轴生成
拿到脚本后,用微软 Edge TTS 把每段口播稿转成 MP3,并用文件大小反推时长(CBR 48kbps 恒定码率,字节数 × 8 ÷ 48000 ≈ 秒数),生成 Remotion 需要的 timeline.json:
// scripts/generate-tts.ts
const VOICE = 'zh-CN-XiaoxiaoNeural'; // 女声,自然流畅

function estimateDurationSec(filePath: string): number {
  const bytes = fs.statSync(filePath).size;
  return Math.max(1, (bytes * 8) / 48000);
}

// 口播 = 标题 + 正文,听感更完整
const dur = await synthesize(tts, `${s.headline}。${s.script}`, file);
scenes.push({ ...s, audioFile: `audio/scene-${i}.mp3`, audioDurationSec: dur });
踩坑记录 2:初版直接读 MP3 二进制头解析时长,结果不同段的时长精度飘了几百毫秒,导致画面和配音对不上。后来改成「恒定码率 → 用文件大小反推」,误差控制在 10ms 内,问题消失。
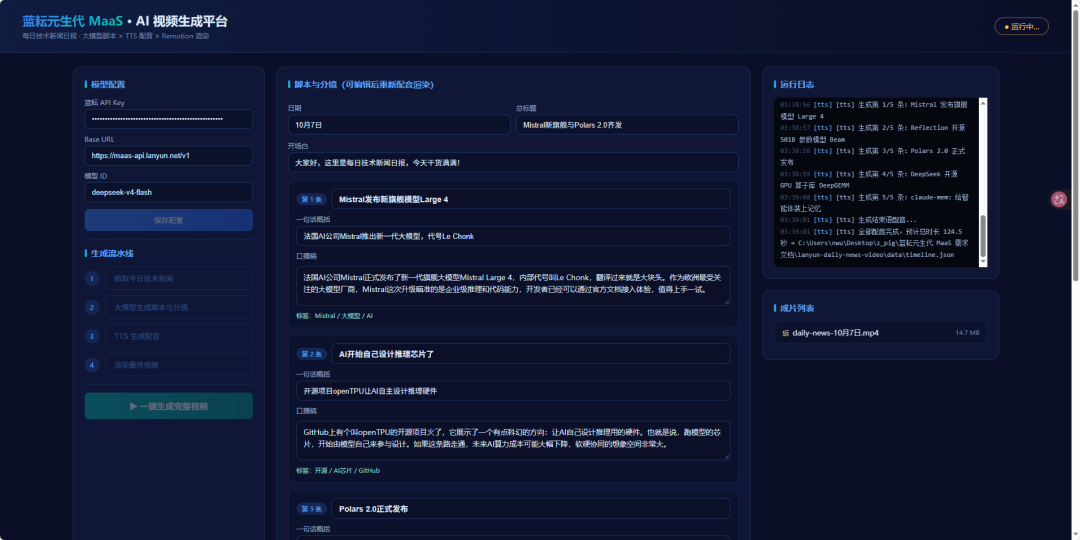
生成的 timeline.json 长这样(每段都带精确到毫秒的时长):
{
  "openingDurationSec": 5.808,
  "scenes": [
    { "headline": "Mistral 发布旗舰模型 Large 4", "audioDurationSec": 23.592, ... },
    { "headline": "Reflection 开源 501B 参数模型 Beam", "audioDurationSec": 21.936, ... }
  ],
  "closingDurationSec": 3.096
}
五、Remotion:用 React 写视频,帧数由配音决定
这是整个方案最优雅的部分——视频时长完全由配音时长反推,不需要手动对时间轴。
5.1 主合成组件
// src/compositions/DailyNews.tsx
export const DailyNews: React.FC<{ timeline: Timeline }> = ({ timeline }) => {
  const sec2frames = (sec: number) => Math.ceil(sec * FPS) + TRANSITION_FRAMES;

  const introFrames = sec2frames(timeline.openingDurationSec);
  const sceneFrames = timeline.scenes.map((s) => sec2frames(s.audioDurationSec));
  const outroFrames = sec2frames(timeline.closingDurationSec);

  // 游标累加,算出每段的起始帧
  let cursor = 0;
  const introFrom = cursor;
  cursor += introFrames;
  const sceneFroms = sceneFrames.map((f) => { const from = cursor; cursor += f; return from; });

  return (
    <AbsoluteFill style={{ backgroundColor: '#0a0e27' }}>
      <Sequence from={introFrom} durationInFrames={introFrames}>
        <Intro date={timeline.date} title={timeline.title} audioFile={timeline.openingAudio} />
      </Sequence>
      {timeline.scenes.map((scene, i) => (
        <Sequence key={i} from={sceneFroms[i]} durationInFrames={sceneFrames[i]}>
          <NewsScene {...scene} audioFile={scene.audioFile} />
        </Sequence>
      ))}
      <Sequence from={outroFrom} durationInFrames={outroFrames}>
        <Outro closing={timeline.closing} audioFile={timeline.closingAudio} />
      </Sequence>
    </AbsoluteFill>
  );
};
数据驱动视频的核心思想:timeline.json 的每一段映射为一个 <Sequence>,帧数由配音时长决定,画面永远跟声音严丝合缝。
5.2 新闻场景组件(带入场动画)
每条新闻的画面元素——序号大字(弹簧动画)、标题(上移 + 淡入)、标签胶囊、底部口播字幕条、顶部进度条——全部用 Remotion 的 interpolate / spring 声明式写:
// src/components/NewsScene.tsx
const numSpring = spring({ frame, fps, config: { damping: 10 } });
const headlineY = interpolate(frame, [5, 25], [60, 0], { extrapolateRight: 'clamp' });
const headlineOpacity = interpolate(frame, [5, 25], [0, 1], { extrapolateRight: 'clamp' });
const bodyOpacity = interpolate(frame, [20, 40], [0, 1], { extrapolateRight: 'clamp' });
5.3 一条命令渲染
// scripts/render.ts
const durationInFrames =
  sec2frames(timeline.openingDurationSec) +
  sec2frames(timeline.closingDurationSec) +
  timeline.scenes.reduce((a, s) => a + sec2frames(s.audioDurationSec), 0);

await renderMedia({
  composition: { ...composition, durationInFrames, fps: 30, width: 1920, height: 1080 },
  codec: 'h264',
  outputLocation: `out/daily-news-${timeline.date}.mp4`,
  onProgress: ({ progress }) => {
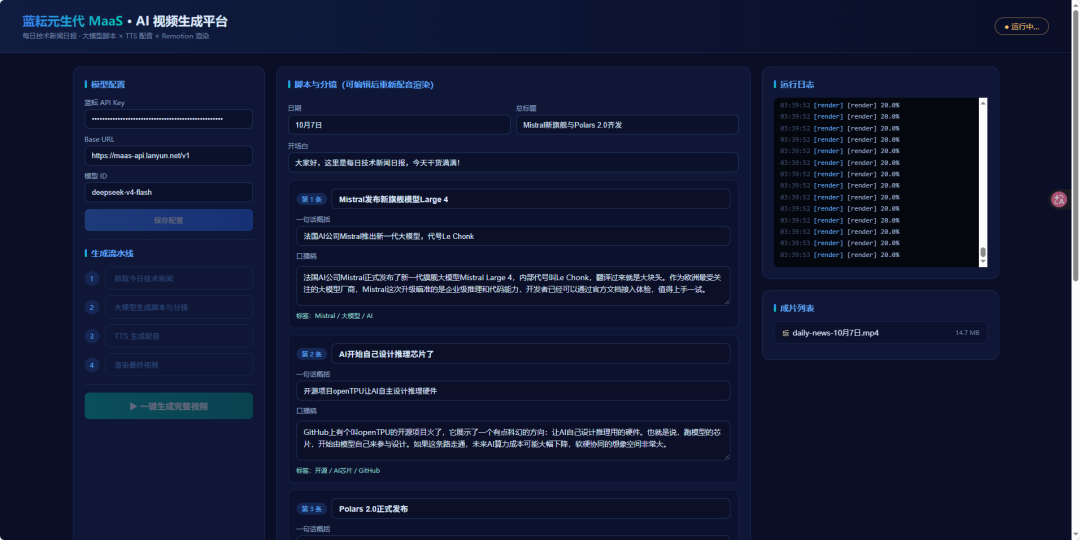
    process.stdout.write(`\r[render] ${(progress * 100).toFixed(1)}%`);
  },
});
渲染完成后拿到成片 daily-news-10月7日.mp4(约 14.7 MB):
六、平台 Web UI:给非技术人员用
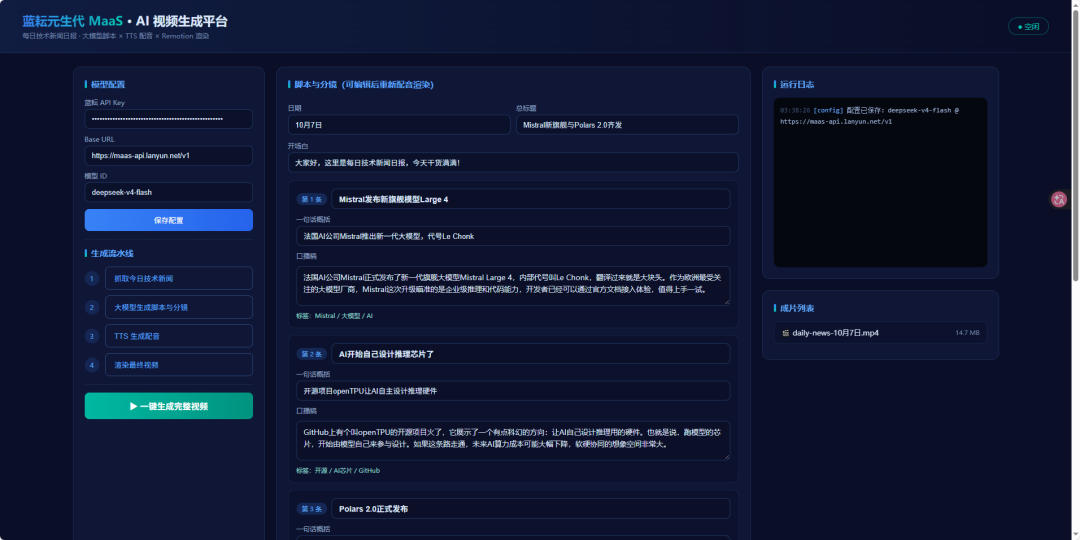
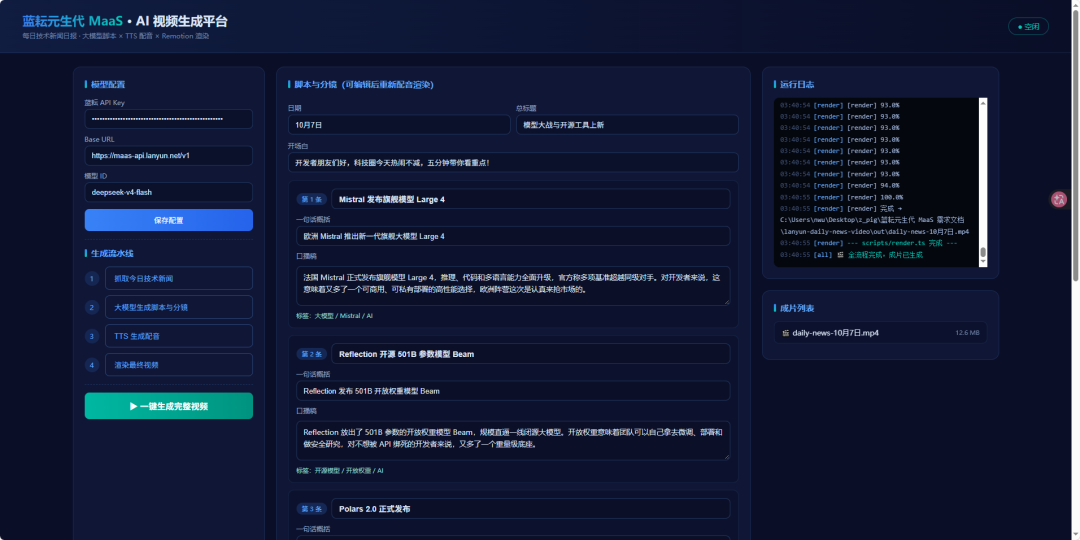
流水线脚本是给开发者用的,我还包了一层 Express + 原生 HTML 的 Web 控制台,让运营同学也能点点按钮出片:
- 左侧:蓝耘 API Key / Base URL / 模型 ID 配置
- 中间:脚本与分镜可视化编辑(生成后还能手动改,改完重新配音渲染)
- 右侧:运行日志实时滚动 + 成片列表在线播放
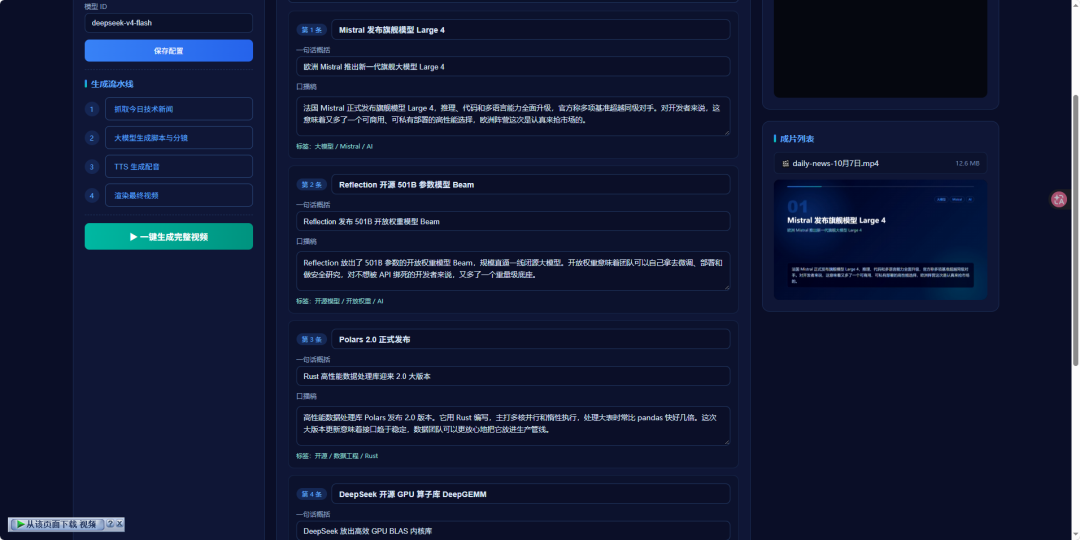
这个「生成后还能人工微调」的设计很关键——AI 负责 90% 的体力活,人负责最后 10% 的品味把关。
七、蓝耘控制台实测数据
整条流水线跑完一次,蓝耘侧只发生 1 次大模型调用(脚本生成)。打开蓝耘控制台能看到清晰的 token 消耗曲线:
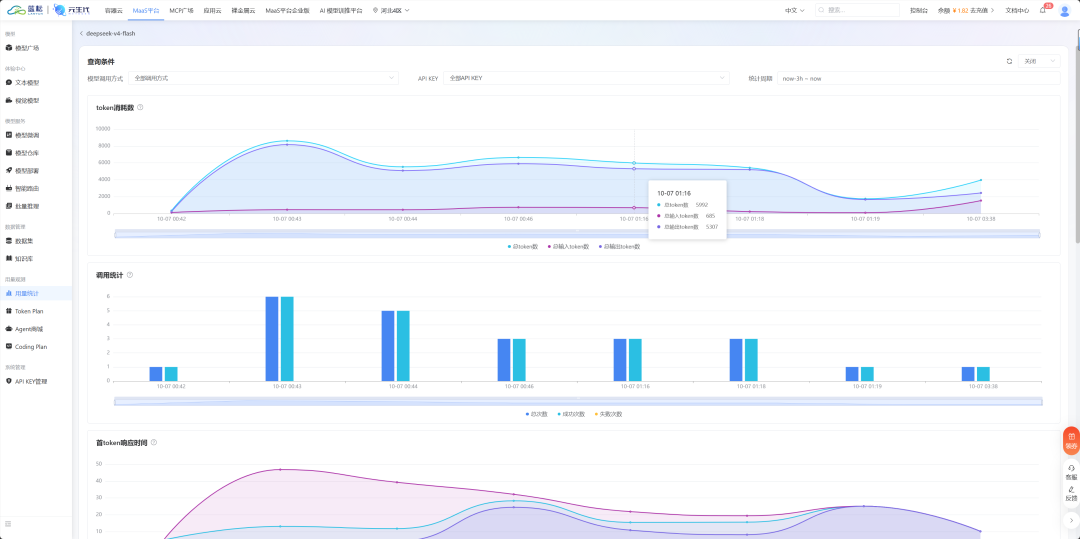
从控制台读到的关键数据:
| 指标 | 数值 |
|---|---|
| 单次调用 prompt tokens | ≈ 4600(25 条新闻摘要 + prompt) |
| 单次调用 completion tokens | ≈ 700(5 条分镜 JSON) |
| 首 token 响应时间 | 20~45s 区间波动 |
| 调用成功率 | 100%(期间无失败记录) |
| 单条视频大模型成本 | < ¥0.01 |
这个成本量级意味着——每天跑一条视频,一个月的模型开销不到 3 毛钱。对比请一个剪辑师或自己花 2 小时,ROI 完全是碾压级的。
八、踩坑与经验总结
坑 1:JSON 模式不是银弹
开了 response_format: json_object 依然可能拿到 markdown 包裹的 JSON。解决:剥代码块 + 截取首尾大括号 + 一次格式约束重试。
坑 2:MP3 时长解析精度
二进制头解析在不同 VBR/CBR 文件上表现不稳。解决:强制 TTS 输出 CBR 48kbps,用文件大小反推时长。
坑 3:模型会编造 URL
初版让模型自己"回忆"新闻链接,结果 5 条里编了 2 条。解决:prompt 里硬性要求"url 必须从候选列表原样复制",并把候选 URL 显式列在 user prompt 里。
经验 1:一次调用 > 多次调用
最初我想"每条新闻调一次模型",后来发现把 25 条一次性喂进去让模型自己筛选+写稿,效果好得多——模型能看到全局,选题优先级判断更准,还省了 5 倍 token。
经验 2:数据驱动视频是真香
Remotion + timeline.json 的组合让"视频长度"这个问题彻底消失——配音多长,画面就多长,永远同步。
九、写在最后
这套流水线现在的状态:
- ✅
npm run pipeline一条命令,5 分钟出成片 - ✅ 蓝耘单次调用完成选题 + 写稿 + 分镜,成本 < 1 分钱
- ✅ Web UI 支持生成后人工微调脚本
- ✅ 1080P / 30fps / H.264,可直接发 B 站 / 视频号
后续想做的优化:
- 换蓝耘更长上下文的模型(如 Kimi-K2),把新闻全文喂进去而不只是摘要,口播稿信息密度还能再提一档
- 用蓝耘批量推理一次生成未来 7 天的脚本,摊薄调用开销
- 接蓝耘的文生图模型,给每条新闻自动生成配图,画面更丰富
如果你也在做内容自动化,强烈建议试试蓝耘元生代 MaaS——OpenAI 兼容意味着你现有的 openai SDK 代码改两行就能跑,控制台还能看到每次调用的 token 明细,调试 prompt 时心里特别有数。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_52908342/article/details/167222312