
排序算法的实现路径:从比较与分组到复杂度、稳定性
1. 阅读前问题卡:排序算法
建议先读:先看排序的定义和算法分类,再进入各算法的处理过程。
1.1 阅读前先看这几个问题
- 文中的排序依据是什么,购物筛选和院校排名分别展示了怎样的排序用途?
- 直接插入排序怎样利用已有序的前段;希尔排序中的
gap又改变了什么? - 直接选择、冒泡和快速排序分别怎样决定元素的最终位置?
- 快速排序的 Hoare、挖坑和前后指针版本,划分区间时各怎样移动数据?
- 归并排序的“先分后合”和计数排序的“统计再回写”各依赖什么信息?
- 性能测试代码如何保证各排序函数拿到相同的初始数据?
- 稳定性描述的是什么关系,为什么阅读复杂度对照时还要单独看稳定性?
1.2 读完后完成这 3 道高频问题
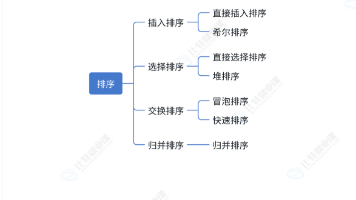
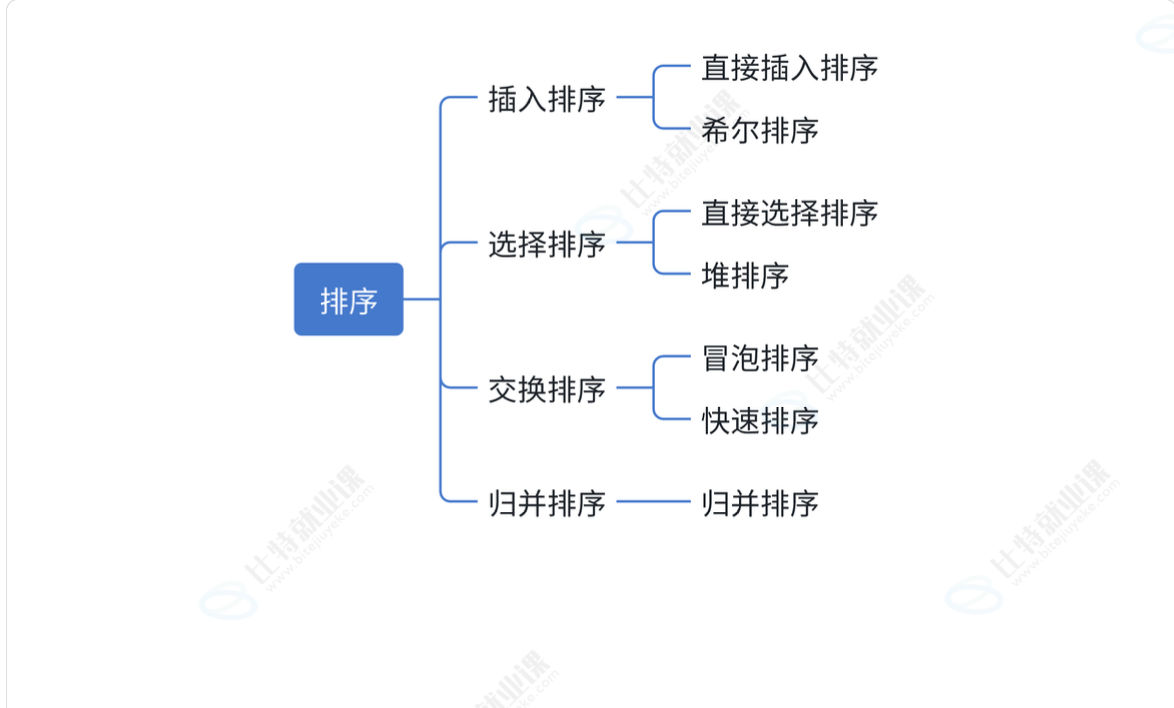
1.2.1 高频问题 1:请说明文中插入、选择、交换、归并和非比较排序各自处理数据的基本思路,并比较它们如何确定元素的位置。
1.2.2 高频问题 2:直接插入排序和希尔排序有什么关系?gap 从大于 1 变化到 1 时,排序过程有什么不同?
1.2.3 高频问题 3:快速排序如何借助基准值划分区间?文中的 Hoare、挖坑和前后指针三种划分方法有什么区别?
1.3 自检清单
- 我能说清排序的目标,以及文中列出的几类排序思路。
- 我能解释直接插入与希尔排序的关系。
- 我能说出选择排序、冒泡排序和快速排序怎样移动或确定元素位置。
- 我能复述归并排序与计数排序的主要步骤。
- 我能说明稳定性指向相等关键字记录的哪种关系。
- 我能指出性能测试代码怎样准备可比较的输入。
2. 前言
2.1 从已有顺序中找位置
整理一手扑克牌时,手里已有的牌先排好,新拿到的一张再沿着现有顺序找位置。对应到直接插入排序,已排好的前段是手里的牌,待插入元素是新牌;比较并后移元素,才能空出插入位置。
希尔排序处理的还是插入位置,却先让相隔一定距离的元素分别整理。对应到文中的 gap 分组,间隔大于 1 时先预排序,最后间隔变成 1,才回到直接插入排序。
2.2 通过选择或交换确定位置
给一排物品按大小摆放,可以每轮从剩余物品里挑出最小的一件放到前面;也可以不断比较相邻两件,让较大的逐渐移向后面。前一种动作对应直接选择排序,后一种对应冒泡排序。两者都在调整顺序,但确定位置的方式不同。
如果先拿一件物品作参照,把较小和较大的分到两侧,再分别处理两侧,关注点就从逐个放置变成划分区间。快速排序用基准值做这件事;文中的三种划分写法,区别在于左右扫描、填坑或前后指针怎样安排交换与回填。
2.3 拆开合并与按次数归位
两摞各自排好序的纸张,可以比较两摞顶端,逐张合成一摞有序纸张。对应到归并排序,两段有序子序列是两摞纸,合并操作决定下一张进入结果的位置;排序过程先把序列分开,再逐层合并。
另一个问题是,若先知道每个数出现了多少次,就能按数值顺序把它们写回去。计数排序中的计数数组承担这份记录,原数组接收回写结果。这里不依靠两两比较确定先后,而依靠数值范围和出现次数。
3. 排序概念及运用
3.1 概念
排序:使一串记录按照其中某个或某些关键字的大小,递增或递减地排列起来的操作。
3.2 运用
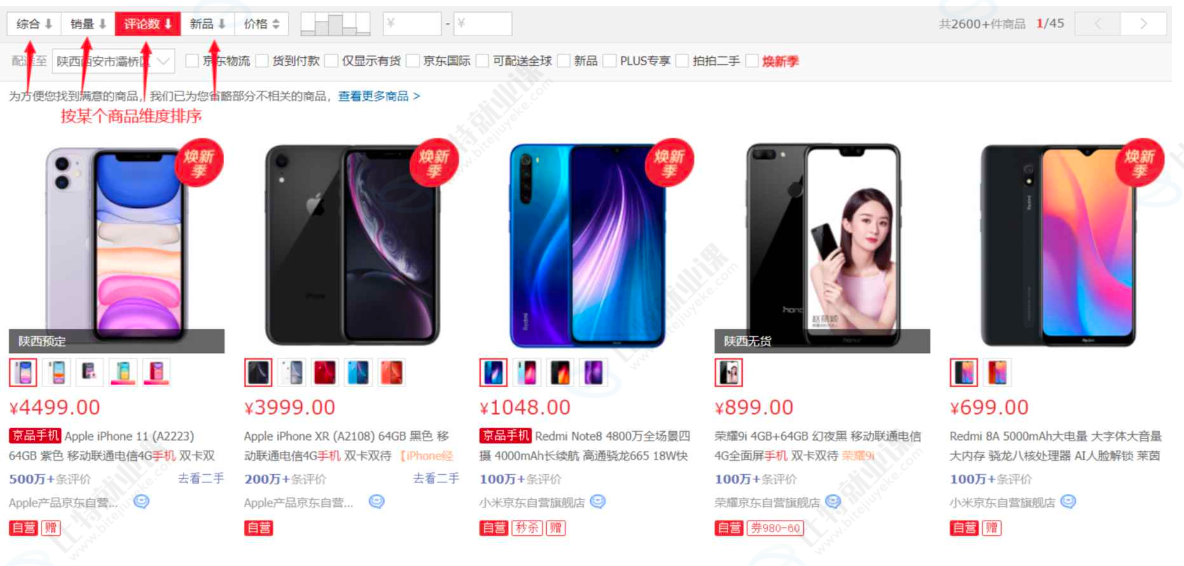
购物筛选排序:
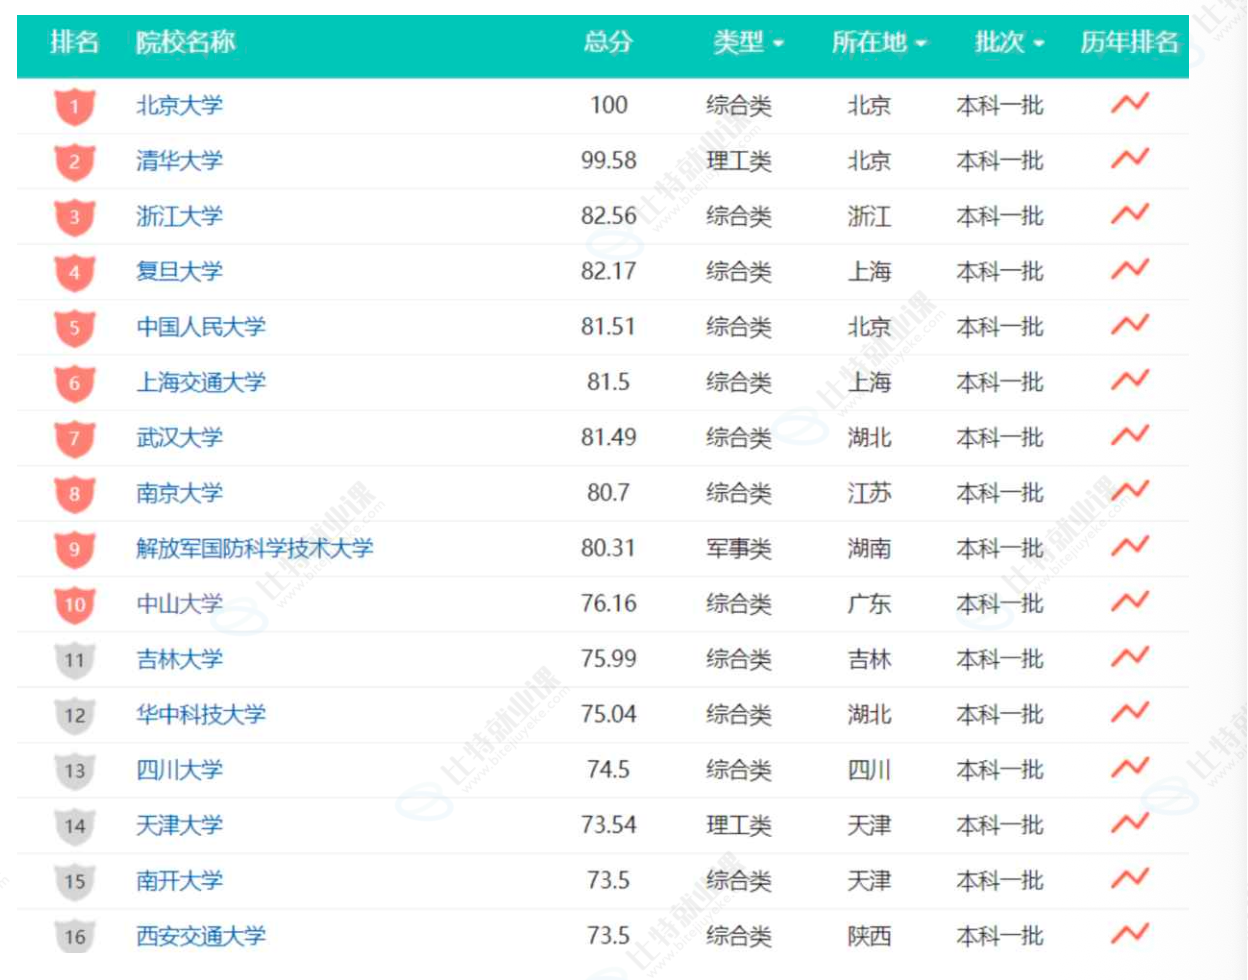
院校排名:
3.3 常见排序算法
4. 实现常见排序算法
示例数组:
int a[] = {5, 3, 9, 6, 2, 4, 7, 1, 8};
4.1 插入排序
直接插入排序的基本思想:把待排序记录按关键码值的大小逐个插入已排好序的序列中,直到所有记录都插入,得到新的有序序列。
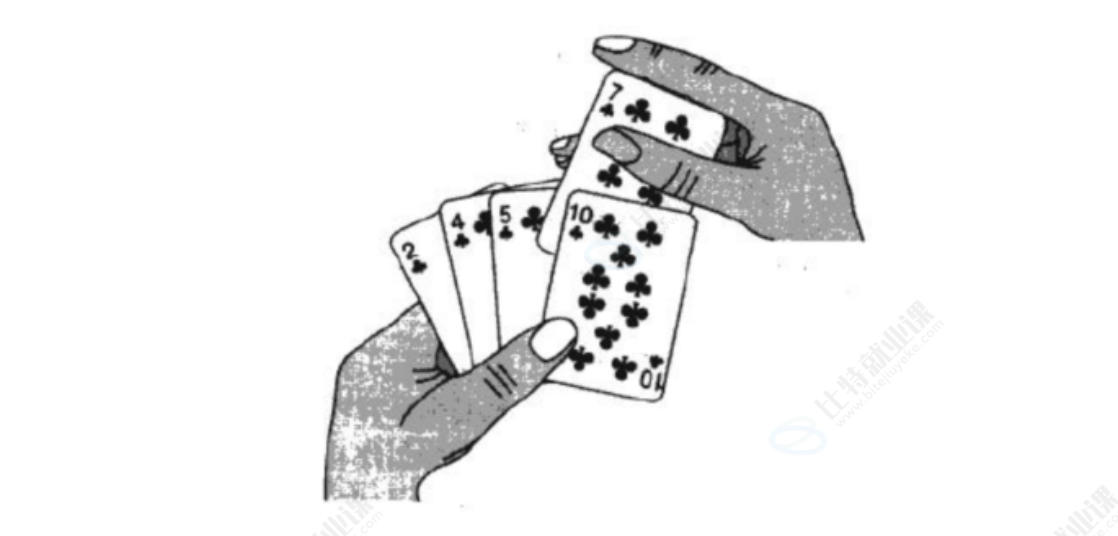
实际玩扑克牌时,就用了插入排序的思想。
4.1.1 直接插入排序
当插入第 i 个元素(i >= 1)时,前面的 array[0] 到 array[i-1] 已经排好序。用 array[i] 的排序码与前面的排序码依次比较,找到插入位置;原位置上的元素顺序后移。

代码实现
void InsertSort(int* a, int n)
{
    for (int i = 0; i < n - 1; i++)
    {
        int end = i;
        int tmp = a[end + 1];
        while (end >= 0)
        {
            if (a[end] > tmp)
            {
                a[end + 1] = a[end];
                end--;
            }
            else
            {
                break;
            }
        }
        a[end + 1] = tmp;
    }
}
直接插入排序的特性:
- 元素集合越接近有序,直接插入排序的时间效率越高。
- 时间复杂度:
O(N^2)。 - 空间复杂度:
O(1)。
4.1.2 希尔排序
希尔排序又称缩小增量法。先选定整数 gap(文中通常取 gap = n / 3 + 1),把距离相等的记录分到同一组,对每组排序;随后更新 gap = gap / 3 + 1,再次分组并插入排序。到 gap = 1 时,相当于直接插入排序。
它是在直接插入排序基础上的改进。原文认为其整体效率高于直接插入排序。
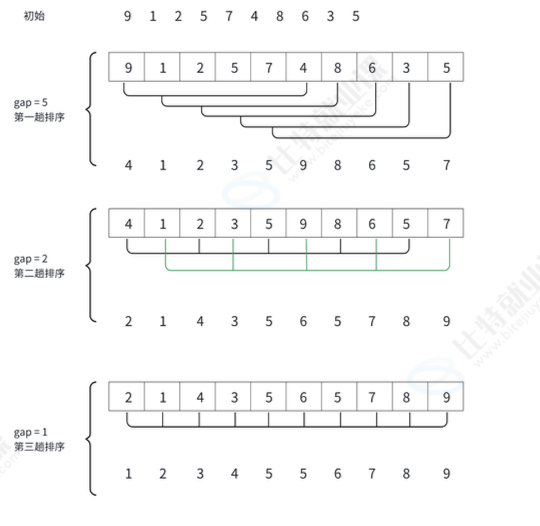
希尔排序的特性:
- 希尔排序是对直接插入排序的优化。
gap > 1时是预排序,目的是让数组更接近有序;gap == 1时,数组已经接近有序。
代码实现
void ShellSort(int* a, int n)
{
    int gap = n;
    while (gap > 1)
    {
        // 推荐写法:除 3
        gap = gap / 3 + 1;
        for (int i = 0; i < n - gap; i++)
        {
            int end = i;
            int tmp = a[end + gap];
            while (end >= 0)
            {
                if (a[end] > tmp)
                {
                    a[end + gap] = a[end];
                    end -= gap;
                }
                else
                {
                    break;
                }
            }
            a[end + gap] = tmp;
        }
    }
}
4.1.2.1 希尔排序的时间复杂度计算
外层循环的时间复杂度可写为 O(log n)。
内层循环:
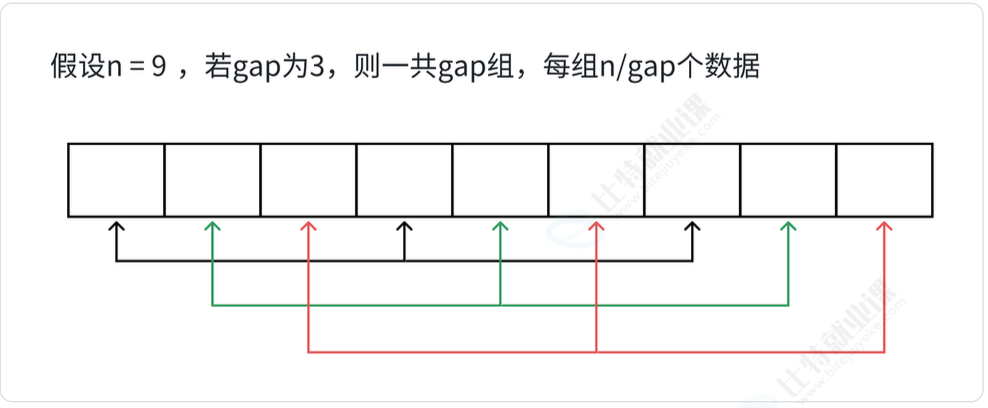
假设有 n 个数据,分为 gap 组,每组约有 n / gap 个。按原文的最坏情况估算,每组插入移动次数为 1 + 2 + ... + (n / gap - 1),总移动次数为:
gap * [1 + 2 + ... + (n / gap - 1)]
以除 3 为例,gap 依次约为 n / 3、n / 9、n / 27,直到 2、1:
gap = n / 3时,移动总数为(n / 3) * (1 + 2) = n。gap = n / 9时,移动总数为(n / 9) * (1 + 2 + ... + 8) = 4n。- 最后一趟
gap = 1,即直接插入排序;原文将这一阶段的内层消耗记为n。
据此,原文描述排序次数先上升,到某一顶点后再下降;顶点的具体计算过程没有给出。
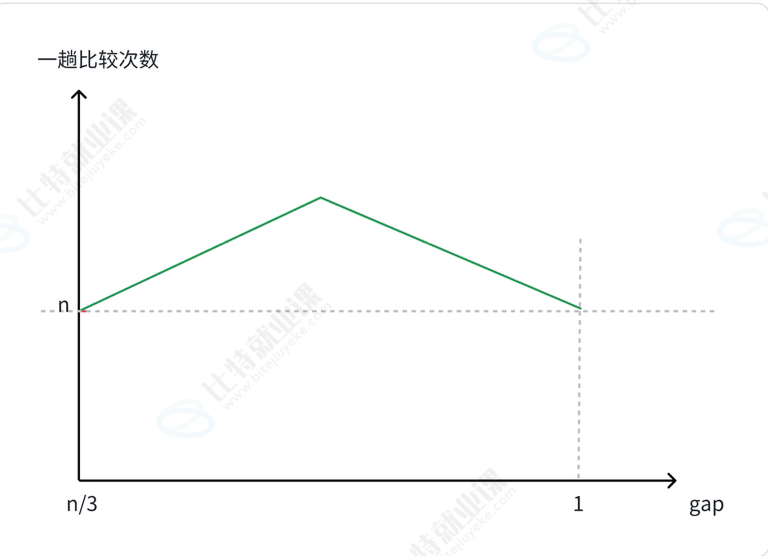
希尔排序的时间复杂度因 gap 取值不同而不固定。原文提到严蔚敏《数据结构(C 语言版)》给出的时间复杂度,但复制文本未保留其具体数值。
4.2 选择排序
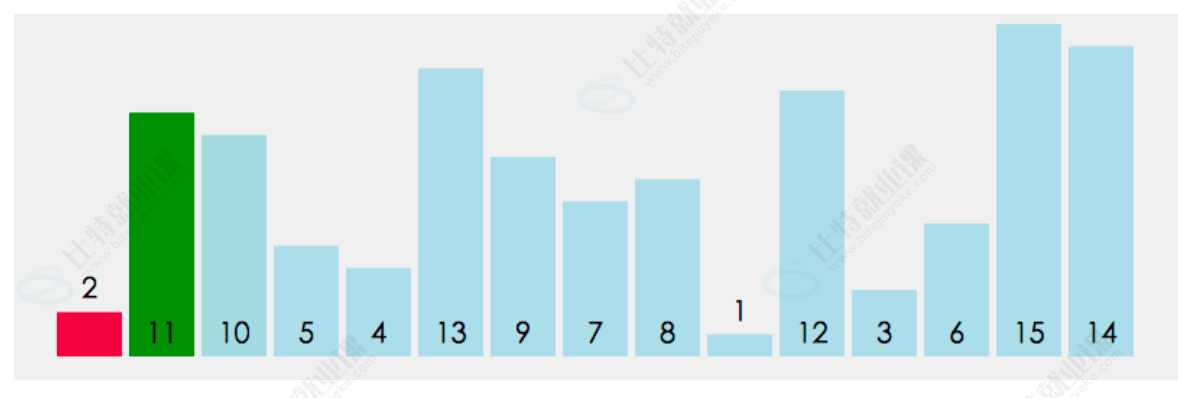
每次从待排序数据中选出最小(或最大)的元素,放到序列起始位置,直到全部元素排完。
4.2.1 直接选择排序
- 在
array[i]到array[n-1]中选择关键码最大或最小的元素。 - 如果它不是这组元素中的最后一个或第一个,就与对应位置的元素交换。
- 在剩余集合中重复,直到只剩 1 个元素。
代码实现
void SelectSort(int* a, int n)
{
    int begin = 0, end = n - 1; // 定义未排序区间的首尾指针

    // 当区间内至少有两个元素时继续循环
    while (begin < end)
    {
        int mini = begin, maxi = begin; // 假设当前区间的首元素是最小值和最大值

        // 遍历当前未排序区间 [begin, end]
        for (int i = begin; i <= end; i++)
        {
            // 如果发现更小的值,更新 mini
            if (a[i] < a[mini])
            {
                mini = i;
            }
            // 如果发现更大的值,更新 maxi
            if (a[i] > a[maxi])
            {
                maxi = i;
            }
        }

        // 【关键边界处理】如果最大值原本就在 begin 位置
        if (begin == maxi)
        {
            maxi = mini; // 因为 begin 马上要和 mini 交换,原来的 maxi 会被换走,需要修正 maxi 的位置
        }

        // 将最小值交换到区间头部
        swap(&a[mini], &a[begin]);

        // 将最大值交换到区间尾部
        swap(&a[maxi], &a[end]);

        // 缩小区间
        ++begin;
        --end;
    }
}
(“ maxi = mini”的必要性:在代码中,maxi 只是一个整数变量,它记录的是最大值所在的下标(位置),而不是最大值本身。当我们说 maxi = 0 时,它的意思是:“我记得,最大值藏在数组的第 0 号位置”。)
直接选择排序的特性:
- 思路容易理解,但效率不高,实际中很少使用。
- 时间复杂度:
O(N^2)。 - 空间复杂度:
O(1)。
4.2.2 堆排序
堆排序(Heapsort)利用堆这种数据结构选择数据,是选择排序的一种。排升序要建大堆,排降序要建小堆。原文在二叉树章节已介绍堆排序,此处不再赘述。
4.3 交换排序
交换排序根据两个记录关键字的比较结果,对换它们在序列中的位置,使关键字较大的记录向尾部移动,较小的记录向前部移动。
4.3.1 冒泡排序
冒泡排序是一种基础的交换排序。元素根据自身大小逐步向数组的一侧移动。

代码实现
void BubbleSort(int* a, int n)
{
    int exchange = 0;
    for (int i = 0; i < n; i++)
    {
        for (int j = 0; j < n - i - 1; j++)
        {
            if (a[j] > a[j + 1])
            {
                exchange = 1;
                swap(&a[j], &a[j + 1]);
            }
        }
        if (exchange == 0)
        {
            break;
        }
    }
}
冒泡排序的特性:
- 时间复杂度:
O(N^2)。 - 空间复杂度:
O(1)。
4.3.2 快速排序
快速排序是 Hoare 于 1962 年提出的二叉树结构的交换排序方法。任取一个待排序元素作为基准值,按基准值把集合划分为两个子序列:左侧元素小于基准值,右侧元素大于基准值;再对左右子序列重复这一过程,直到元素位于相应位置。
实现主框架
// 快速排序
void QuickSort(int* a, int left, int right)
{
    if (left >= right)
    {
        return;
    }

    // _QuickSort 按基准值划分区间
    int meet = _QuickSort(a, left, right);
    QuickSort(a, left, meet - 1);
    QuickSort(a, meet + 1, right);
}
划分区间的 _QuickSort 主要有以下几种实现方式。
4.3.2.1 Hoare 版本
算法思路:
- 创建左右指针,确定基准值。
- 从右向左找比基准值小的数据,从左向右找比基准值大的数据;交换左右指针所指数据,再进入下一轮。

问题 1:为什么跳出循环后 right 位置的值一定不大于 key?
原文解释:当 left > right 时,right 走到 left 左侧,而 left 扫描过的数据均不大于 key,因此此时 right 指向的数据不大于 key。
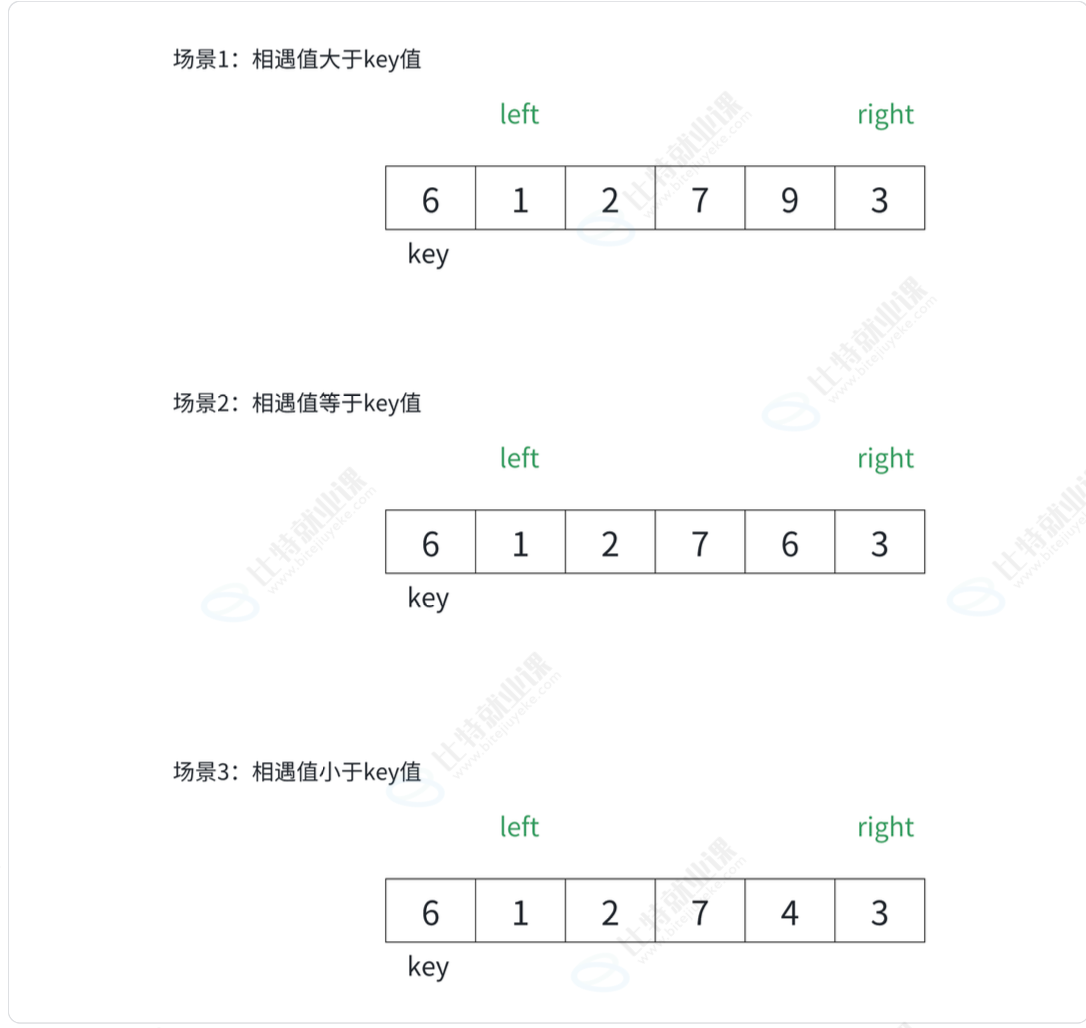
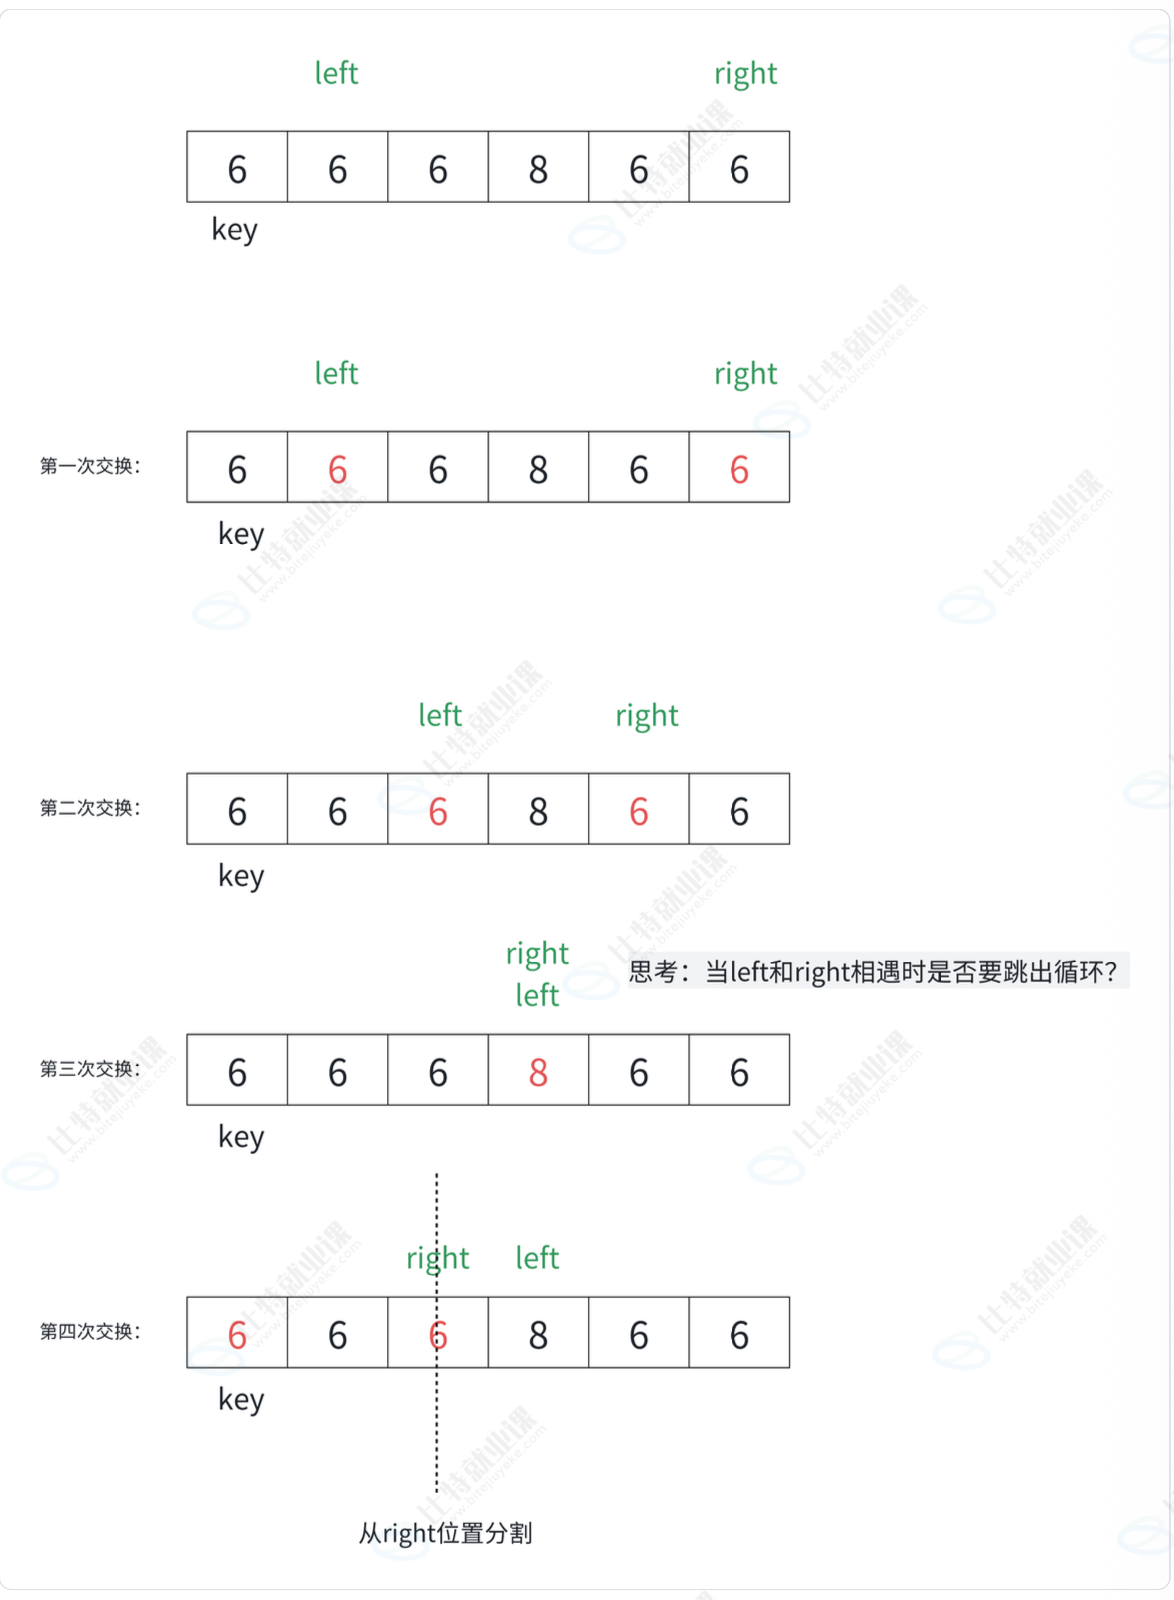
问题 2:为什么 left、right 所指数据等于 key 时也要交换?
相等值参与交换会有额外消耗。原文指出,数组有大量重复值时,若不处理相等值,可能无法有效划分。
代码实现
int _QuickSort(int* a, int left, int right)
{
    int begin = left;
    int end = right;
    int keyi = left;
    ++left;
    while (left <= right)
    {
        // 右边找小
        while (left <= right && a[right] > a[keyi])
        {
            --right;
        }
        // 右边找小
        while (left <= right && a[left] < a[keyi])
        {
            ++left;
        }
        if (left <= right)
        {
            swap(&a[left++], &a[right--]);
        }
    }
    swap(&a[keyi], &a[right]);
    return right;
}
4.3.2.2 挖坑法
创建左右指针。先从右向左找比基准值小的数据,放入左边的“坑”,原位置成为新坑;再从左向右找比基准值大的数据,放入右边的坑。循环结束后,把最初保存的基准值放入当前坑中,并返回该下标。
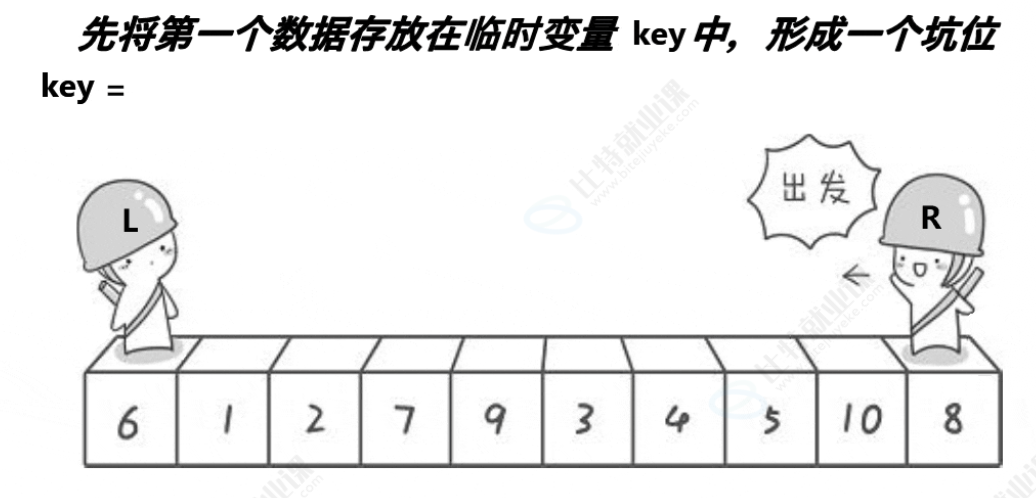
int _QuickSort(int* a, int left, int right)
{
    int mid = a[left];
    int hole = left;
    int key = a[hole];
    while (left < right)
    {
        while (left < right && a[right] >= key)
        {
            --right;
        }
        a[hole] = a[right];
        hole = right;

        while (left < right && a[left] <= key)
        {
            ++left;
        }
        a[hole] = a[left];
        hole = left;
    }
    a[hole] = key;
    return hole;
}
4.3.2.3 Lomuto 前后指针
创建前后指针,从左往右找比基准值小的数据并交换,使较小的数据排在基准值左边。
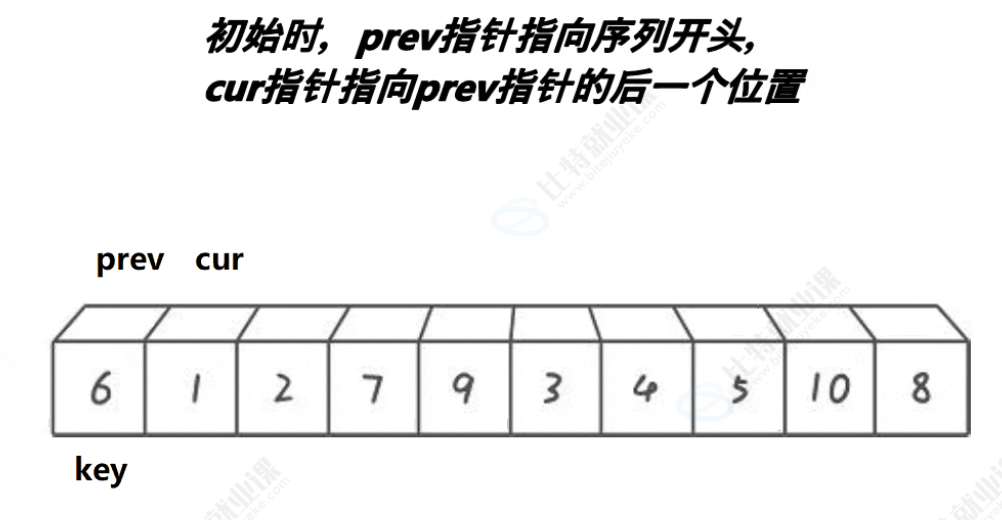
int _QuickSort(int* a, int left, int right)
{
    int prev = left, cur = left + 1;
    int key = left;
    while (cur <= right)
    {
        if (a[cur] < a[key] && ++prev != cur)
        {
            swap(&a[cur], &a[prev]);
        }
        ++cur;
    }
    swap(&a[key], &a[prev]);
    return prev;
}
快速排序的特性:
- 时间复杂度:
O(n log n)。 - 空间复杂度:
O(log n)。
4.3.2.4 非递归版本
非递归快速排序需要借助栈。
代码实现
void QuickSortNonR(int* a, int left, int right)
{
    ST st;
    STInit(&st);          // 初始化一个栈
    STPush(&st, right);   // 注意:先压入右边界
    STPush(&st, left);    // 再压入左边界
    while (!STEmpty(&st))
    {
        int begin = STTop(&st); STPop(&st); // 弹出左边界(后进先出)
        int end = STTop(&st); STPop(&st);   // 弹出右边界
        // ... 单趟排序 ...
    }
    STDestroy(&st);
}

// 单趟
int keyi = begin;     // 基准值下标(默认选最左边的数)
int prev = begin;     // 前指针
int cur = begin + 1;  // 后指针

while (cur <= end)
{
    // 核心逻辑:如果 cur 找到了比基准值小的数,且 prev 和 cur 不重合
    if (a[cur] < a[keyi] && ++prev != cur)
        Swap(&a[prev], &a[cur]);
    ++cur;
}
Swap(&a[keyi], &a[prev]); // 最后把基准值换到 prev 的位置
keyi = prev;              // 更新基准值的最终位置
// [begin, keyi-1] keyi [keyi+1, end]

if (keyi + 1 < end) // 如果右子区间至少有两个元素
{
    STPush(&st, end);
    STPush(&st, keyi + 1);
}
if (begin < keyi - 1) // 如果左子区间至少有两个元素
{
    STPush(&st, keyi - 1);
    STPush(&st, begin);
}
前后指针法的核心思想(大白话版):
prev指针的作用是:维护小于基准值的区域的右边界。初始时,只有基准值本身,所以prev = begin。cur指针的作用是:向前探路,寻找比基准值小的数。- 执行过程:
cur一直往前走。遇到比基准值大的数,不管它,继续走。- 一旦
cur遇到比基准值小的数,就把prev向前挪一步(++prev),然后把a[prev]和a[cur]交换。 - 结果:
prev和cur之间的数,全都是比基准值大的数。prev及其左边的数,全都是比基准值小的数(除了基准值本身还在最左边)。
- 收尾: 当
cur走到end时,把a[keyi](最左边的基准值)和a[prev]交换。此时,基准值就归位了。
细节提示:
++prev != cur这个判断是为了优化。如果prev和cur指向同一个位置,交换是没有意义的(自己跟自己换),加上这个判断可以省去一次无用的Swap调用
4.4 归并排序
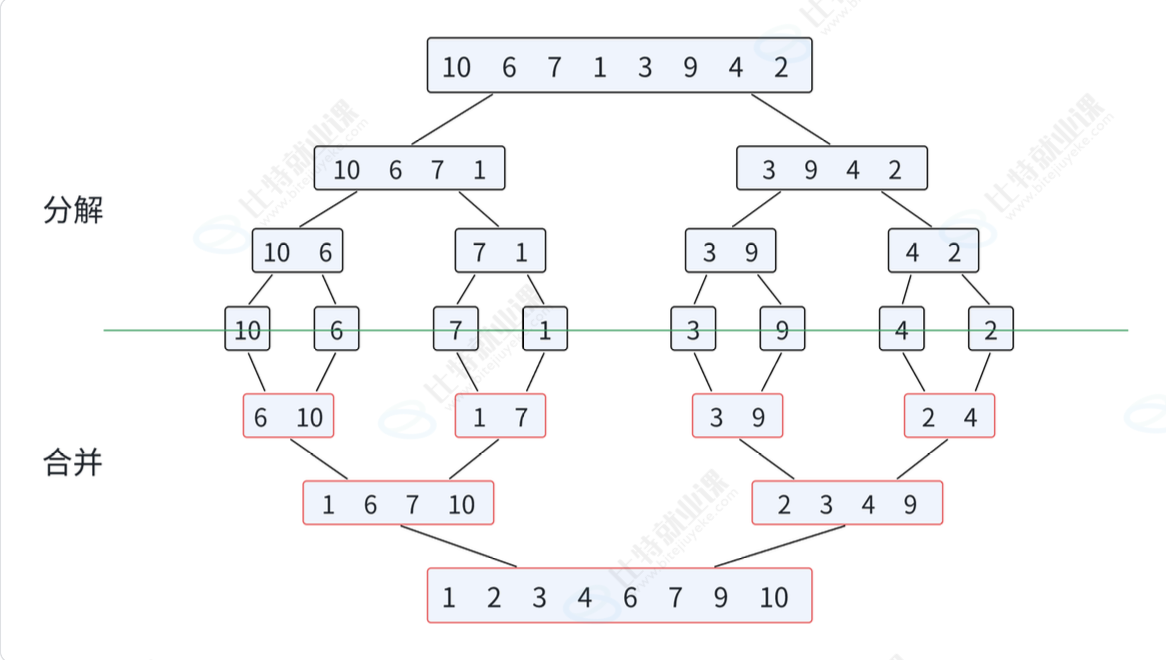
归并排序(Merge Sort)建立在归并操作上,是分治法(Divide and Conquer)的典型应用。先使各子序列有序,再合并有序子序列,使整个序列有序。两个有序表合并成一个有序表,称为二路归并。
核心步骤:
代码实现
void _MergeSort(int* a, int left, int right, int* tmp)
{
    if (left >= right)
    {
        return;
    }
    int mid = (right + left) / 2;

    // [left, mid] [mid+1, right]
    _MergeSort(a, left, mid, tmp);
    _MergeSort(a, mid + 1, right, tmp);

    int begin1 = left, end1 = mid;
    int begin2 = mid + 1, end2 = right;
    int index = begin1;

    // 合并两个有序数组为一个数组
    while (begin1 <= end1 && begin2 <= end2)
    {
        if (a[begin1] < a[begin2])
        {
            tmp[index++] = a[begin1++];
        }
        else
        {
            tmp[index++] = a[begin2++];
        }
    }
    while (begin1 <= end1)
    {
        tmp[index++] = a[begin1++];
    }
    while (begin2 <= end2)
    {
        tmp[index++] = a[begin2++];
    }
    for (int i = left; i <= right; i++)
    {
        a[i] = tmp[i];
    }
}

void MergeSort(int* a, int n)
{
    int* tmp = new int[n];
    _MergeSort(a, 0, n - 1, tmp);
    delete[] tmp;
}
归并排序的特性:
- 时间复杂度:
O(n log n)。 - 空间复杂度:
O(n)。
4.5 测试代码:排序性能对比
// 测试排序的性能对比
void TestOP()
{
    srand(time(0));
    const int N = 100000;
    int* a1 = (int*)malloc(sizeof(int) * N);
    int* a2 = (int*)malloc(sizeof(int) * N);
    int* a3 = (int*)malloc(sizeof(int) * N);
    int* a4 = (int*)malloc(sizeof(int) * N);
    int* a5 = (int*)malloc(sizeof(int) * N);
    int* a6 = (int*)malloc(sizeof(int) * N);
    int* a7 = (int*)malloc(sizeof(int) * N);
    for (int i = 0; i < N; ++i)
    {
        a1[i] = rand();
        a2[i] = a1[i];
        a3[i] = a1[i];
        a4[i] = a1[i];
        a5[i] = a1[i];
        a6[i] = a1[i];
        a7[i] = a1[i];
    }

    int begin1 = clock();
    InsertSort(a1, N);
    int end1 = clock();
    int begin2 = clock();
    ShellSort(a2, N);
    int end2 = clock();
    int begin3 = clock();
    SelectSort(a3, N);
    int end3 = clock();
    int begin4 = clock();
    HeapSort(a4, N);
    int end4 = clock();
    int begin5 = clock();
    QuickSort(a5, 0, N - 1);
    int end5 = clock();
    int begin6 = clock();
    MergeSort(a6, N);
    int end6 = clock();
    int begin7 = clock();
    BubbleSort(a7, N);
    int end7 = clock();

    printf("InsertSort:%d\n", end1 - begin1);
    printf("ShellSort:%d\n", end2 - begin2);
    printf("SelectSort:%d\n", end3 - begin3);
    printf("HeapSort:%d\n", end4 - begin4);
    printf("QuickSort:%d\n", end5 - begin5);
    printf("MergeSort:%d\n", end6 - begin6);
    printf("BubbleSort:%d\n", end7 - begin7);

    free(a1);
    free(a2);
    free(a3);
    free(a4);
    free(a5);
    free(a6);
    free(a7);
}
4.6 非比较排序
4.6.1 计数排序
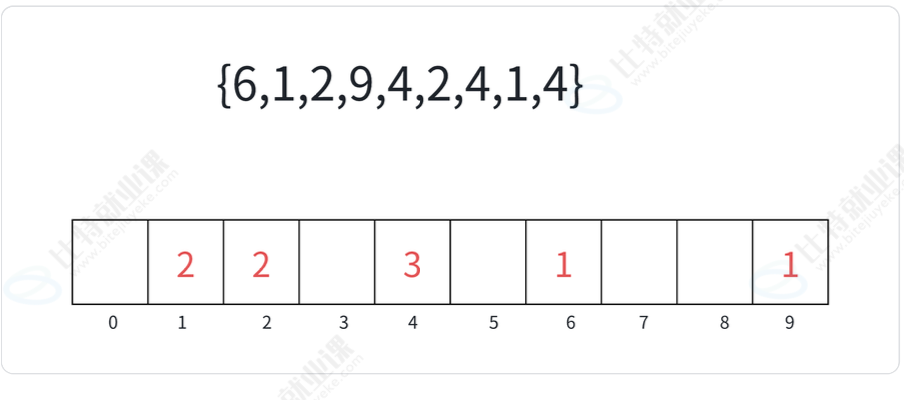
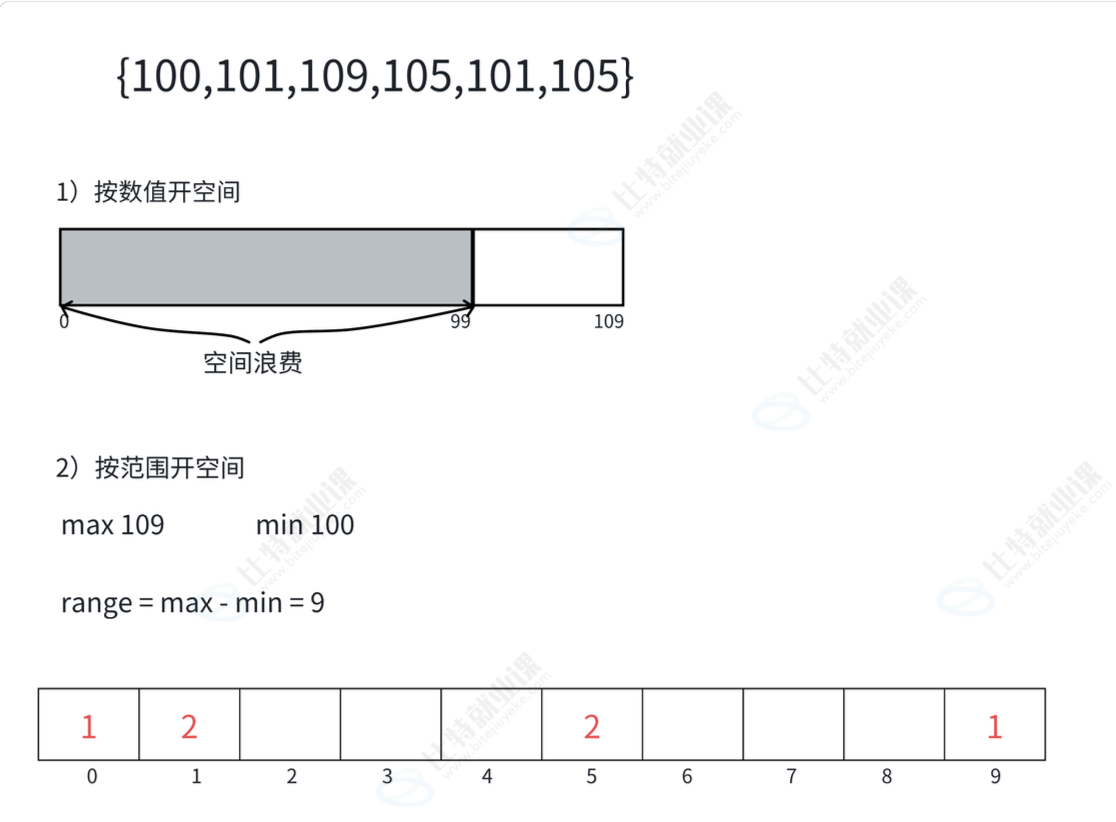
计数排序又称为鸽巢原理,是对哈希直接定址法的变形应用。操作步骤:
- 统计相同元素的出现次数。
- 根据统计结果,将序列回写到原序列中。
代码实现
void CountSort(int* a, int n)
{
    int min = a[0], max = a[0];
    for (int i = 1; i < n; i++)
    {
        if (a[i] > max) max = a[i];
        if (a[i] < min) min = a[i];
    }
        int range = max - min + 1; // 计算值域跨度
    int* count = (int*)malloc(sizeof(int) * range); // 动态开辟计数数组
    if (count == NULL)
    {
        perror("malloc fail");
        return;
    }
    memset(count, 0, sizeof(int) * range); // 全部初始化为 0
        // 统计次数
    for (int i = 0; i < n; i++)
    {
        count[a[i] - min]++;
    }
        // 排序
    int j = 0; // j 用于遍历原数组 a
    for (int i = 0; i < range; i++) // i 用于遍历计数数组 count因为 count 的下标代表了数值的大小(相对大小),所以从小到大遍历就能实现排序。
    {
        while (count[i]--) // 只要 count[i] > 0,就循环执行
        {
            a[j++] = i + min; // 还原数值,写回原数组
        }
    }
}
计数排序的特性:
- 数据范围集中时效率较高,但适用范围和场景有限。
- 时间复杂度:
O(N + range)。 - 空间复杂度:
O(range)。 - 稳定性:稳定。
5. 排序算法复杂度及稳定性分析
稳定性:待排序记录中有多个相同关键字时,若排序后它们的相对次序不变,则算法稳定;否则不稳定。例如原序列中 r[i] = r[j] 且 r[i] 在 r[j] 之前,排序后仍保持这一先后关系,就属于稳定。
原文复杂度对照表在复制时失去列对齐。以下按可辨认的条目保留其复杂度与稳定性信息:
| 排序方法 | 平均情况 | 最好情况 | 最坏情况 | 辅助空间 | 稳定性 |
|---|---|---|---|---|---|
| 冒泡排序 | O(n^2) | O(n) | O(n^2) | O(1) | 稳定 |
| 直接选择排序 | O(n^2) | O(n^2) | O(n^2) | O(1) | 不稳定 |
| 直接插入排序 | O(n^2) | O(n) | O(n^2) | O(1) | 稳定 |
| 希尔排序 | O(n^1.3) | O(n log n) | O(n^2) | O(1) | 不稳定 |
| 堆排序 | O(n log n) | O(n log n) | O(n log n) | O(1) | 不稳定 |
| 归并排序 | O(n log n) | O(n log n) | O(n log n) | O(n) | 稳定 |
| 快速排序 | O(n log n) | O(n log n) | O(n^2) | O(log n)~O(n) | 不稳定 |
稳定性验证案例:
- 直接选择排序:
5 8 5 2 9。 - 希尔排序:
5 8 2 5 9。 - 堆排序:
2 2 2 2。 - 快速排序:
5 3 3 4 3 8 9 10 11。
6.回答问题卡的问题
问题 1:文中的排序依据是什么,购物筛选和院校排名分别展示了怎样的排序用途?
答:
依据是记录中某个或某些关键字的大小,目标是按这些关键字递增或递减排列
选择排序:把每轮待排序部分选出最小或最大的元素,放在相应的位置。用途:购物示例可按销量、评论数、价格等维度排列商品
插入排序,交换排序:按大小去排序元素。用途:院校示例按总分从高到低展示排名。
问题 2:直接插入排序怎样利用已有序的前段;希尔排序中的 gap 又改变了什么?
答:
在前段已经有序,比较时将较大的元素后移,腾出位置再插入,可以和前面的序列依次比较,最终找到插入位置
gap具体作用:按下标间隔分组,同组内以 gap 为步长比较和移动;gap > 1 是预排序,gap = 1 才完成整个数组的直接插入排序
优势:
-
**减少了元素的移动次数:**在
gap > 1的预排序阶段,元素可以大步流星地跨越数组,迅速到达大概正确的位置,有效减少后续整理工作。避免了直接插入排序中“每次只能挪一步”的尴尬。 -
降低了时间复杂度: 希尔排序通过这种增量分组,将平均时间复杂度降到了大约 O(n*1.3) 。对于中等规模的数据,效率提升非常明显。
问题 3:直接选择、冒泡和快速排序分别怎样决定元素的最终位置?
答:
直接选择:在 array[i] 到 array[n-1] 中选择关键码最大或最小的元素。如果它不是这组元素中的最后一个或第一个,就与对应位置(排升序时最小值放前端,最大值放后端)的元素交换。代码每轮同时寻找两者,放好后缩小待排序区间。在剩余集合中重复,直到只剩 1 个元素。
冒泡排序:元素根据自身大小逐步向数组的一侧移动。比较相邻元素,逆序就交换;升序的一趟扫描会把当前未排好部分的最大值送到末端。
快速排序:任取一个待排序元素作为基准值,按基准值把集合划分为两个子序列:左侧元素小于基准值,右侧元素大于基准值(也可以有元素相等);再对左右子序列重复这一过程,直到元素位于相应位置。
问题 4:快速排序的 Hoare、挖坑和前后指针版本,划分区间时各怎样移动数据?
答:
Hoare:
- 创建左右指针,确定基准值。
- 基准值保留在左端、左指针从后一项开始,从右向左找比基准值小的数据,从左向右找比基准值大的数据(相等值也可能停下并交换);交换左右指针所指数据,交换后两指针继续内移,再进入下一轮。
- 扫描交错后将基准值与
right处元素交换并返回下标。
挖坑法:
创建左右指针。开始时保存左端基准值,并把左端设为初始坑。先从右向左找比基准值小的数据,放入左边的“坑”,原位置成为新坑;再从左向右找比基准值大的数据,放入右边的坑。循环结束后,把最初保存的基准值放入当前坑中,并返回该下标。
Lomuto 前后指针:
创建前后指针,从左往右找比基准值小的数据并交换,扫描期间,较小元素先集中在基准值右边、截至 prev 的区域;扫描结束后,基准值与 prev 处元素交换,较小元素才位于基准值左边。
问题 5:归并排序的“先分后合”和计数排序的“统计再回写”各依赖什么信息?
答:
归并排序(先分后合) 依赖的是**“元素之间的大小关系(相对顺序)”**。合并的前提是两段已经各自有序,比较的是两段当前未合并的首元素;下一项由较小者决定,并写入临时数组,最后回写。
计数排序(统计再回写) 依赖的是**“元素本身的绝对数值(全局分布)”**。具体而言:文中整数实现先求最小值、最大值和数值范围,用 a[i] - min 定位计数项,统计每个值的次数,再按从小到大的数值顺序回写。
问题 6:性能测试代码如何保证各排序函数拿到相同的初始数据?
答:
通过这些复制都在调用排序函数之前完成,使各独立数组的初始长度、元素值和顺序一致。
a2[i] = a1[i];
a3[i] = a1[i];
a4[i] = a1[i];
a5[i] = a1[i];
a6[i] = a1[i];
a7[i] = a1[i];
问题 7:稳定性描述的是什么关系,为什么阅读复杂度对照时还要单独看稳定性?
答:
稳定性:待排序记录中有多个相同关键字时,若排序后它们的相对次序不变,则算法稳定;否则不稳定。
时间、空间复杂度与稳定性描述不同维度,因此复杂度相同也不能代替稳定性判断。
高频问题 1:请说明文中插入、选择、交换、归并和非比较排序各自处理数据的基本思路,并比较它们如何确定元素的位置。
答:
这几类排序的区别,主要在于怎样找到或安排元素的位置。
插入排序把待排序元素逐个插入已经有序的序列,比较并移动已有元素,为当前元素找位置。直接插入在有序前段里处理,希尔排序则先按 gap 对各组插入排序,缩小间隔后再整理整个数组;插入时确定的是当前有序序列中的位置。
选择排序每轮从剩余数据中选出最小或最大的元素,放到对应端点,直接确定该极值的最终位置。直接选择靠扫描寻找极值,堆排序借助堆来选择;文中升序堆排序使用大堆,降序使用小堆。
交换排序通过比较和交换调整位置。冒泡比较相邻元素,升序时每趟把剩余部分的最大值推到末端;快速排序以基准值划分两侧,将基准值归位后,再分别处理左右区间。
归并排序先分开序列,使子序列各自有序,再比较两段当前的首元素,逐项合成更大的有序序列。元素在合并结果中的位置由两段的大小比较决定。
非比较排序在本文中以计数排序为例:先统计各整数值出现的次数,再按数值顺序回写。它依赖数值范围和出现次数安排每个值占据的位置,不靠两两比较。
高频问题 2:直接插入排序和希尔排序有什么关系?gap 从大于 1 变化到 1 时,排序过程有什么不同?
答:
希尔排序是在直接插入排序基础上的改进,组内使用的仍是插入排序,变化的是元素之间的间隔。
gap > 1 时,相隔 gap 个下标的元素组成一组,在各组内比较、后移和插入,元素一次可以移动 gap 个位置。这是预排序:各组有序,整个数组逐步接近有序,但还不能据此认为整个数组已经排好。
文中从 gap = n 开始,每轮更新为 gap = gap / 3 + 1。当 gap 变成 1,所有元素归到同一组,比较和移动都变成相邻位置上的操作,相当于对经过预排序的整个数组做一次直接插入排序,完成最终排序。
高频问题 3:快速排序如何借助基准值划分区间?文中的 Hoare、挖坑和前后指针三种划分方法有什么区别?
答:
快速排序先选一个基准值,把较小的元素安排到一侧、较大的安排到另一侧。文中的三种划分代码都取左端元素作基准,划分完成后让基准值归位并返回下标;随后分别递归处理它两侧的区间,区间只剩一个元素或为空时结束。
Hoare让左右指针相向扫描。右侧跳过大于基准值的元素,左侧跳过小于基准值的元素,停下后交换两处数据并继续内移;指针交错后,把左端基准值与 right 处元素交换。它靠两端交换移动数据,相等值也可能参与交换。
挖坑法先保存基准值,把左端作为初始坑。从右侧找到较小值填左坑,原位置成为右坑;再从左侧找到较大值填右坑,坑随回填移动。左右指针相遇后,把保存的基准值放回最后的坑。它通过赋值填坑完成划分。
前后指针由 cur 单向扫描,prev 记录已收集的较小元素区域的末端。每遇到一个小于基准值的元素,就推进 prev,需要时交换到该区域;最后交换基准值与 prev 处元素。它先收集较小元素,再完成基准值归位。
重复值的处理范围也不同:Hoare 和挖坑法允许等于基准值的元素留在两侧;前后指针只收集严格较小值,所以相等值留在右侧。划分完成只保证元素位于基准值的相应一侧,两侧内部仍需继续排序。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2601_96348813/article/details/167589400